
 quevatech/challenge_repo
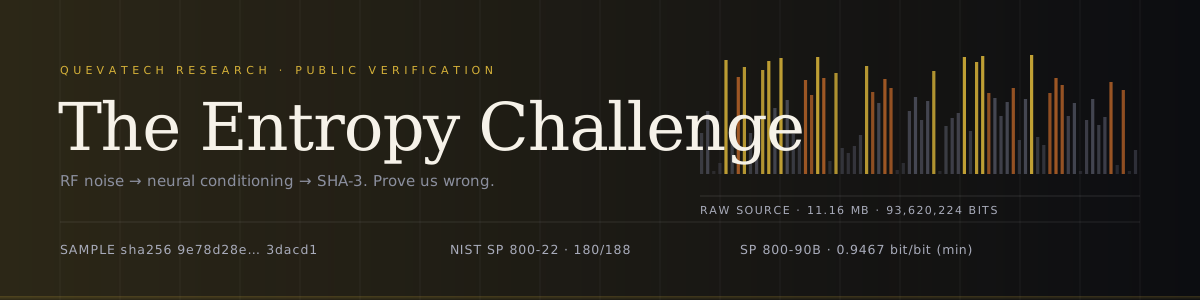
신경망 기반 난수 생성기를 NIST SP 800-22 및 SP 800-90B 표준에 대해 검증하고, 이를 해독하는 데 현상금을 제공하는 구조화된 도전 과제 저장소입니다.

English · Türkçe
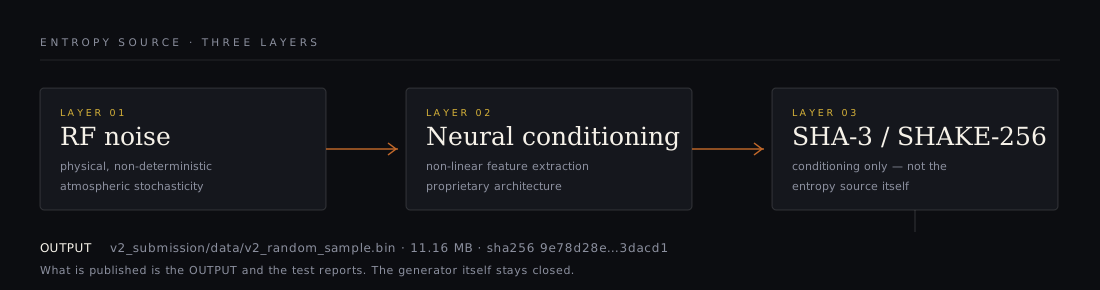
우리는 RF 노이즈를 입력으로 받아 독점적인 신경 컨디셔닝 단계를 거치고, 그 결과를 SHA-3 / SHAKE-256으로 후처리하는 난수 생성기를 만들었습니다. 우리는 이 출력이 이상적인 난수원과 구별할 수 없다고 주장합니다. 즉, 어떤 통계적 또는 학습된 구별자도 이 출력에서 우연을 이길 수 없다는 것입니다.
우리는 출력과 검증 보고서를 공개합니다. 생성기는 공개하지 않습니다.
요청은 단 한 줄입니다: 우리가 틀렸음을 증명하십시오.
| 계층 | 구성 요소 | 역할 | 공개 여부 |
|---|---|---|---|
| 01 | RF 노이즈 | 물리적이고 비결정적인 소스 (대기 확률성) | ✗ |
| 02 | 신경 컨디셔닝 | 원시 RF 신호로부터의 비선형 특징 추출 | ✗ |
| 03 | SHA-3 / SHAKE-256 | 암호학적 컨디셔닝 및 화이트닝 (SP 800-90B 방식) | ✗ |
| → | 샘플 파일 | 인증된 실행과 비트 단위로 동일한 11.16 MB의 출력 | ✓ |
여기서 SHA-3는 오직 컨디셔닝 구성 요소로만 사용되며, 결코 엔트로피 소스로 사용되지 않습니다. 컨디셔닝은 엔트로피를 줄일 수만 있을 뿐, 만들어낼 수는 없습니다.
| 항목 | 값 |
|---|---|
| 샘플 | v2_submission/data/v2_random_sample.bin |
| 크기 | 11,702,528 바이트 · 93,620,224 비트 |
| SHA-256 | 9e78d28edfe7fe1e1a76a3da5eee805c2a472fe43d0abfe873b170a5453dacd1 |
| 인증 | TEST_REPORT.md — SP 800-22, SP 800-90B, Dieharder, AIS 31 |
| 파이프라인 | .github/workflows/nist-tests.yml |
| 지표 | 값 | 해석 |
|---|---|---|
| NIST SP 800-22 (공식 C STS) | 180 / 188 서브 테스트 통과 | 95.7 %; 실패율은 테스트당 예상되는 약 1 % 범위 내 |
| SP 800-90B, IID 평가 | H = 7.9675 bits/byte | IID 가정 확인됨 |
| SP 800-90B, 비-IID (보수적) | min-entropy 7.5739 bits/byte → 0.9467 bits/bit | 우리가 방어할 수치 |
| 마르코프 예측 공격 | 최고 50.06 % | 동전 던지기와 구별 불가 |
| ML 구별자 (GBM, RF) | 최고 51.25 %, p = 0.36 | 유의미한 우위 없음 |
| 자기상관, 지연 1–1000 | 유의미한 지연 2개 (예상 약 2.7) | 주기성 없음 |
보수적인 수치를 읽으십시오. 0.9996 bits/bit는 IID MCV 추정치이고, 0.9467 bits/bit는 t-tuple 추정기에 의해 도출된 비-IID 한계입니다. 컨디셔닝된 스트림은 IID 테스트에서 당연히 완벽해 보여야 하며, 그것은 별로 증명하는 바가 없습니다. 우리가 책임질 한계는 0.9467 bits/bit입니다.
주장이 아니라 명령입니다:
python tools/verify_sample.py
| 검사 | 관측값 | 기준 |
|---|---|---|
| SHA-256 / 크기 | 인증된 보고서와 일치 | 정확히 일치 |
| 비트 균형 | 1의 비율 49.999 %, 단일 비트 p = 0.847 | p > 0.01 |
| 바이트 균일성 | χ² = 248.39 (df 255), p = 0.605 | p > 0.01 |
| 바이트 평균 / 표준편차 | 127.49 / 73.906 | 127.5 / 73.90 |
| 직렬 상관, 지연 1–8 | 최대 |ρ| = 0.00031 | < 0.000877 (3σ) |
| 최장 동일 연속 구간 | 28 비트 | ≈ log₂(93.6 M) ≈ 26.5 |
| 중복 16바이트 블록 | 731,408개 중 0개 | 0 |
| 압축 한계 | 8.0024 비트/바이트 | > 7.99 |
여덟 개의 기준을 모두 통과하며, 어느 하나라도 통과하지 못하면 스크립트는 0이 아닌 값으로 종료됩니다. 이는 의도적으로 가능한 가장 저렴한 테스트 집합입니다. 인증을 대체하기 위한 것이 아니라 실행하기 쉽도록 만들어진 것입니다.
성공이 무엇을 입증할 수 있는지에 따라 난이도가 높아지는 세 가지 레벨입니다.
| 레벨 | 질문 | 합격 기준 | 인정 |
|---|---|---|---|
| 🥇 L1 · 예측기 | 비트 N+1을 예측할 수 있습니까? | N = 100,000개의 홀드아웃 비트에 대해: 정확도 ≥ 50.52 % (양측 p < 0.001). 더 큰 N도 허용되며, 임계값은 이항 검정에서 도출됩니다. | 명예의 전당 + 인증서 |
| 🥈 L2 · 구별기 | os.urandom과 우리를 구별할 수 있습니까? | 클래스당 ≥ 100,000개 샘플, p < 0.001에서 이점 > 0.01, 한 번도 본 적 없는 스트림에서 평가. | 명예의 전당, 이름 명시 |
| 🥉 L3 · 패턴 탐지기 | 모든 표준 테스트가 무언가를 놓쳤습니까? | p < 1e-6에서 다중 비교 보정을 통과하고 두 번째 샘플에서 재현되는 편향 또는 주기. | 명예의 전당, 공개 감사 |
os.urandom을 포함한
어떤 생성기도 깨뜨릴 것입니다.tools/referee.py가 동결된 방법을
홀드아웃 스트림에 대해 실행하고 results.json을 작성합니다. 해당 파일이
없는 발견은 발견이 아닙니다.| 날짜 | 연구자 | 레벨 | 결과 | 증거 |
|---|---|---|---|---|
| — | 당신의 이름 | — | — | — |
pip install -r requirements.txt

# 1. cheapest gate, ~10 s
python tools/verify_sample.py

# 2. NIST SP 800-22 official C implementation (89 streams × 1 Mbit)
git clone --depth=1 https://github.com/arcetri/sts && (cd sts && make legacy)
bash tests/run_sts.sh v2_submission/data/v2_random_sample.bin sts/sts_legacy_fft 89 results/

# 3. NIST SP 800-90B official tools (ea_iid + ea_non_iid)
bash tests/run_ea90b.sh v2_submission/data/v2_random_sample.bin 8 results/

# 4. attack suite: Markov prediction, ML distinguisher, autocorrelation, leakage
python tests/security_tests.py --file v2_submission/data/v2_random_sample.bin
이 저장소가 증명하지 않는 것들의 짧은 목록입니다. 이를 숨기는 것은 진지한 검토자가 가장 먼저 알아차릴 부분이므로, 대신 여기에 적어 둡니다.
submissions/<handle>/로 풀 리퀘스트를 열어 주세요.[email protected] (공개 이슈를 열지 마세요).샘플 인증 2026-04 · 문서 CC BY 4.0 · 코드 MIT · QuevaTech Research






