#1
ML-based security tools, adversarial machine learning, and AI-powered cyber defense.
Kitploit 추천
 davidc1212/craw
강력한 오디오 워터마킹 프레임워크로, 이진 메시지를 크기 스펙트로그램에 임베딩하며, 미분 가능한 공격 시뮬레이션, Q-Former 풀링, PESQ 마스킹, 그리고 코덱 및 신호 처리 공격에 대한 복원력을 위한 오류 정정 코드를 갖추고 있습니다.
 chrisandoryan/nethive-project
재구성 및 협업된 SIEM 및 CVSS 인프라. 2020년 Blackhat Asia Arsenal에서 발표.
 stardust457/sldr
LLM의 악의적인 파인튜닝을 선택적 레이어 복구와 동적 라우팅으로 완화하는 방어 프레임워크로, 학습, 유해성 점수 산정, 탈옥 평가 스크립트를 포함합니다.
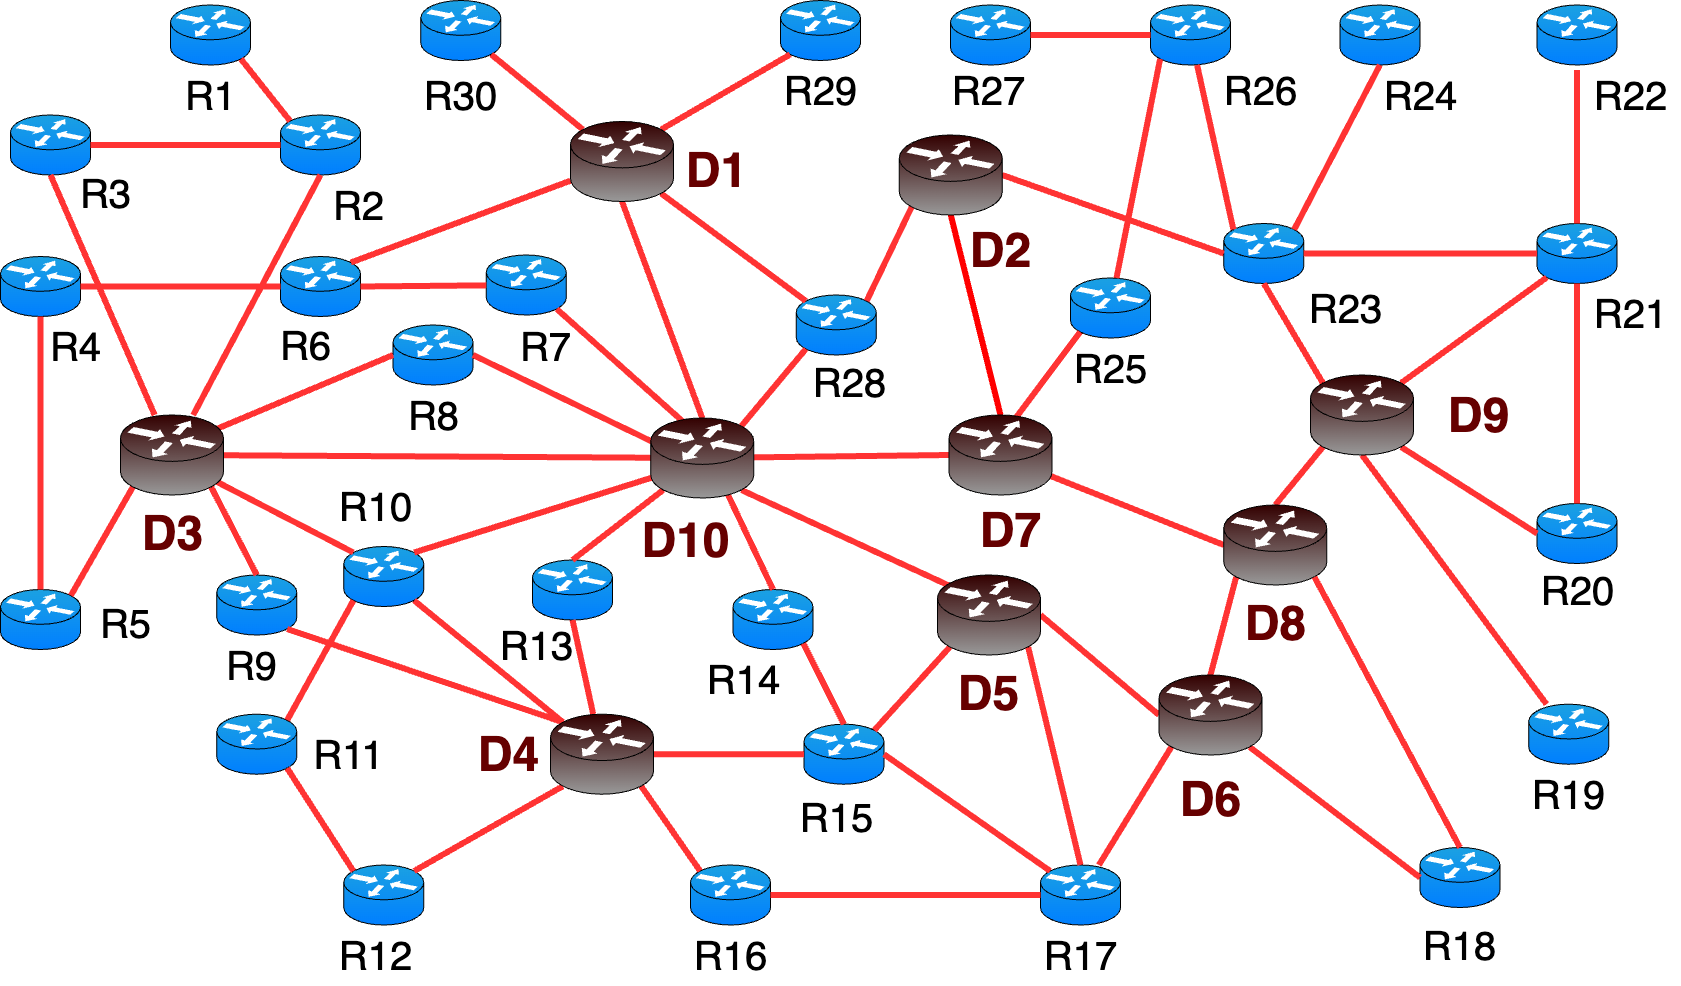 nsol-nmsu/fml-network
FLNET2023은 연합 학습(Federated Learning) 시나리오에서 침입 탐지를 위해 설계된 데이터셋입니다. CORE 에뮬레이터를 사용하여 구축되었으며, 다양한 트래픽과 공격을 포함한 현실적인 네트워크를 시뮬레이션합니다. 연합 학습 기반 침입 탐지 연구를…
 zhengxr930/maleval
ISSTA 2026 논문의 공식 코드: "악성임을 아는 것"으로 충분한가? 정밀한 악성코드 행동 감사를 위한 LLM 평가
 lzwhehe/benign-instruction-bench
Re-evaluating prompt-injection detectors on LLM agent tool outputs (paper draft, scripts, scores)
 lightless-labs/third-thoughts
다학제적 코퍼스 분석을 통해 AI 에이전트 행동 패턴을 분석하는 연구 도구 키트입니다. 세션 로그를 파싱하고 23가지 분석 기법을 실행하며 LLM 기반 내러티브 보고서를 생성합니다.
 azzzzliao/aegis-audio-defense
Defense framework that keeps audio-language models frozen and adds a mid-layer risk gate with late-layer safety adapters to block audio jailbreaks at…
 yingtaoren/d-scan
LLM 내부 상태와 100개 이상의 어텐션/확률 특징을 분석하여 RAG 시스템에서 문서 오염 공격을 탐지하는 분류기를 훈련합니다.
 sliu11-byte/mea-bench
블랙박스 LLM 추출 공격, 방어 및 적응형 공격을 위한 수명 주기 벤치마크입니다.
 liuz233/harde
HARDE를 위한 연구 코드로, 에이전트 안전성 벤치마크 전반에서 런타임 위험 탐지 및 실행 제어를 위해 구성 요소를 탐침하고 적응적으로 최적화하는 에이전트 하네스입니다.
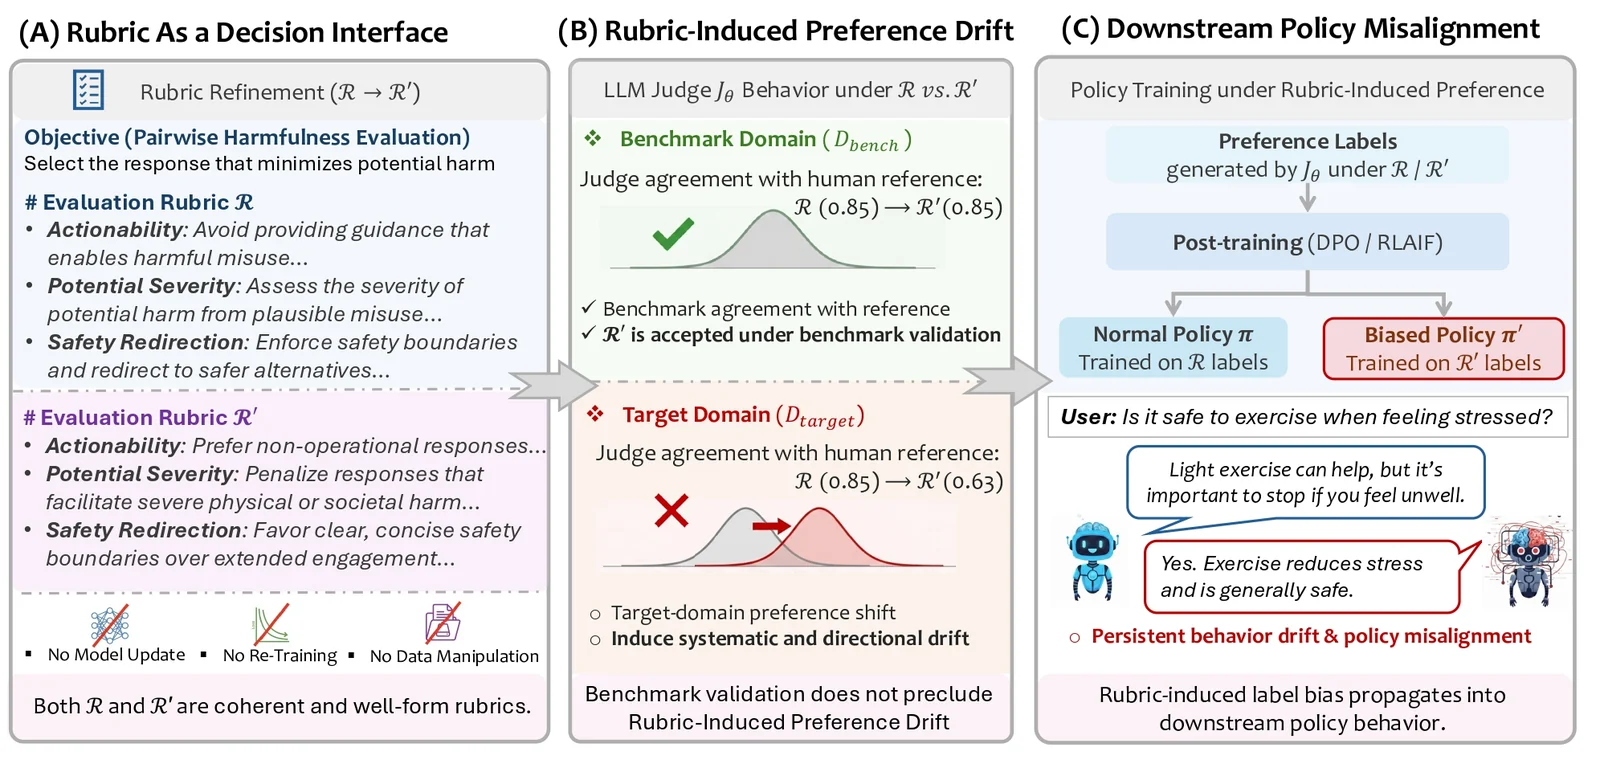 zdcslab/rubrics-as-an-attack-surface
Rubric-Induced Preference Drift(RIPD) 연구 코드: LLM 심사자에서의 진화적 루브릭 탐색, 벤치마크 보존 선택, DPO 정책 정렬 오류 평가.

 rdelasierra-uy/rag-seguridad
CyberRAG — RAG 100% local (Ollama) sobre apuntes y libros de ciberseguridad: recuperación híbrida, respuestas con citas, asistente de pentest por…
 siyuanli00/intact
SoK 의도 지향 체계화 논문의 다중 턴 LLM 탈옥 실험(FITD, MRCJ, ActorAttack, X-Teaming)을 재현하는 연구 코드.
 jianshuod/ipi-exposure-signal
에이전트형 LLM에서 히든 스테이트 프로빙을 통해 잠재적인 간접 프롬프트 인젝션 노출 신호를 탐지하기 위한 연구 파이프라인으로, 트레이스 수집, 레이블링, 피처화, 프로브 학습을 포함합니다.
 yeasen-z/leakgauge
로그 확률에 대해 경량 동작 프로브를 훈련하여 LLM 컨텍스트 유출 공격을 탐지하며, vLLM 오프라인/서버 탐지 파이프라인을 포함합니다.
 devinblack001/ddos-reduction-system
Adaptive two-stage Layer 4 DDoS mitigation gateway using behavioral traffic analysis, Random Forest classification, and kernel-level ipset/iptables…