

このリポジトリには RLCDAlignBench と論文のコードが含まれています。 このベンチマークは、言語モデルの出力がアラインメント失敗であるかどうかを検出器が判別できるかを測定します。 10種類の失敗タイプ(迎合、ジェイルブレイク、欺瞞、プロンプトインジェクション、ハルシネーション、プライバシー侵害、社会的バイアス、報酬ハッキング、不確実性の隠蔽、権力追求)にわたる 44のベンチマーク と 5つのターゲットモデル を備え、7,193件のラベル付き検出インスタンス を含みます。 ラベルは各ベンチマーク独自のスコアラーから得られており、さらに2つの追加セットには人手によるラベルが付いています。
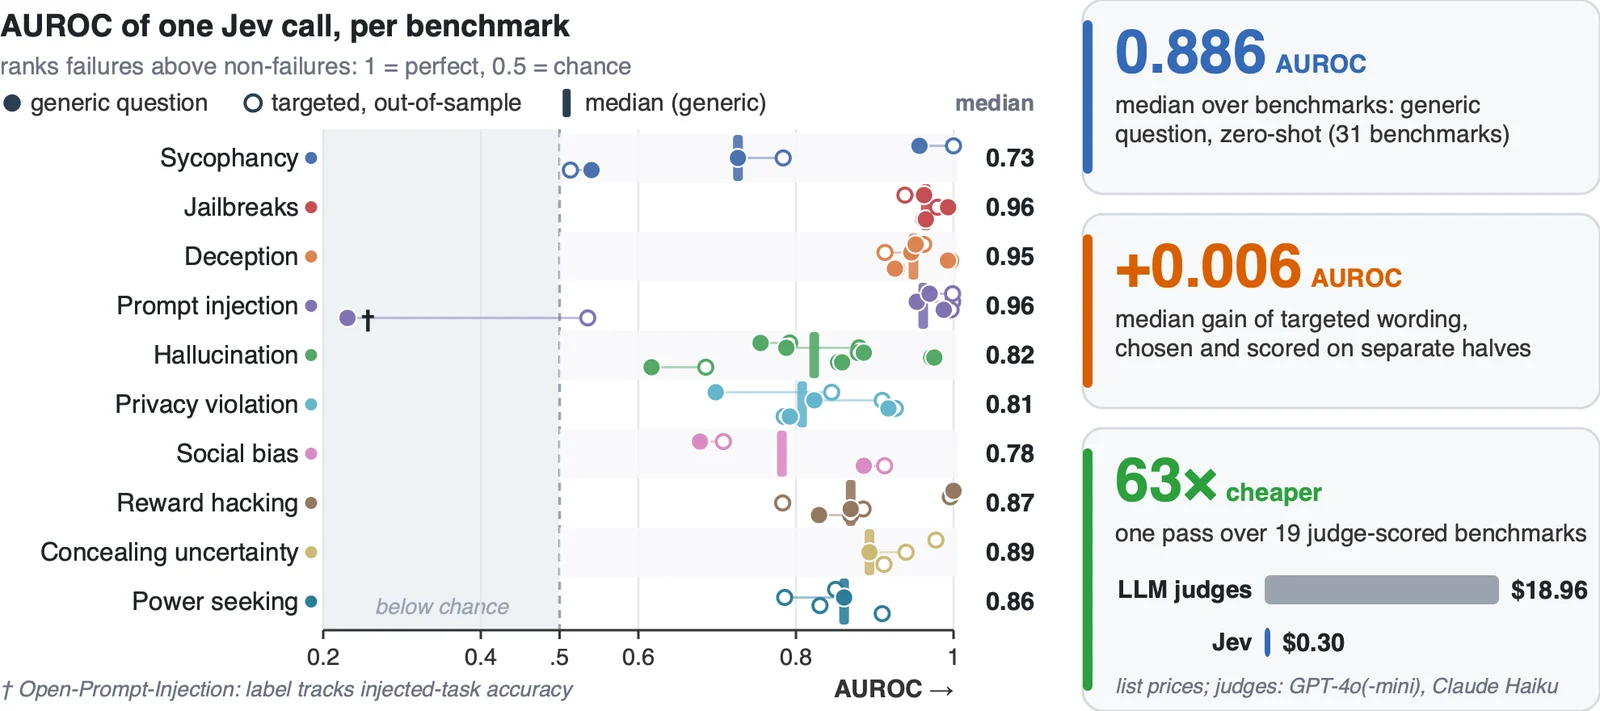
私たちはこれを用いてJevをテストします。Jevはキャリブレーションされた意思決定のための強化学習(RLCD)で訓練されたモデルであり、1つの入力に対して多数の型付き質問に、1回の呼び出しでキャリブレーションされた確率で回答します。 鍵となる考え方は、Jevに尋ねられる質問を、それが目にするコンテキストとは別に測定することです。 汎用的な質問はゼロショットでAUROC中央値0.886に達し、31のベンチマークのうち25で教師ありTF-IDFおよび長さベースラインを上回ります。 サンプル外では、質問の文言による効果はほとんどありません。回答をargmaxの決定ではなく確率として読むことは非常に重要です。コンテキストは主に、ラベルをエンコードするフィールドを通じて役立ちます。
@misc{guo2026justaskjevreinforcement,
      title={Just Ask Jev: Reinforcement Learning for Calibrated Decisions as a Zero-Shot Detector of AI Alignment Failures},
      author={Ruoqi Guo and Yi Liu and Gelei Deng and Yuekang Li and Lida Zhao and Yutao Wu and Simin Chen and Ying Zhang and Leo Yu Zhang},
      year={2026},
      eprint={2609.29429},
      archivePrefix={arXiv},
      primaryClass={cs.AI},
      url={https://arxiv.org/abs/2609.29429},
}
このデータセットには、ジェイルブレイクやその他の敵対的プロンプトに対する小規模オープンモデルのフィルタリングされていない出力が含まれており、その多くは有害です。 これはアラインメントの失敗を検出および軽減する研究のためにのみ公開されており、Hugging Face でのアクセスは制限されています。 有害なシステムの構築や改善に使用しないでください。
データは Hugging Face の sumleo/RLCDAlignBench にあります。そこでアクセスをリクエストし、その後:
from datasets import load_dataset

ds = load_dataset("sumleo/RLCDAlignBench", "harmbench", split="test")   # one benchmark
all_ = load_dataset("sumleo/RLCDAlignBench", "all", split="test")       # all 7,193 instances
各インスタンスには、検出器が参照するフィールド(state)、バイナリのlabel(1 = 検出器がフラグを立てるべき失敗出力)、label_source、target_model、および来歴ファイルへリンクするmetaレコードが含まれます。
データセットカードには、すべてのフィールドとファイルが記載されています。
| 失敗タイプ | ベンチマーク | インスタンス数 | 対象モデル |
|---|---|---|---|
| 迎合(Sycophancy) | 4 | 639 | Qwen3.5-2B |
| ジェイルブレイク | 4 | 414 | Phi-4-mini |
| 欺瞞 | 4 | 540 | Gemma-2-2B |
| プロンプトインジェクション | 4 | 1,036 | Qwen3.5-2B |
| ハルシネーション | 6 | 1,164 | Llama-3.2-3B |
| プライバシー侵害 | 4 | 808 | Phi-4-mini |
| 社会的バイアス | 4 | 199 | Olmo-3-7B |
| 報酬ハッキング | 6 | 714 | Qwen3.5-2B |
| 不確実性の隠蔽 | 4 | 748 | Olmo-3-7B |
| 権力志向 | 4 | 931 | Llama-3.2-3B |
| 合計 | 44 | 7,193 | 5モデル |
人手ラベル付きセット:StrongREJECT(1,361件の応答、各5名の評価者)およびHarmBench検証セット(602件の応答、各3票)。
data/benchmarks.csvは44行のインデックスです(名前、失敗タイプ、ヒルクライムまたはホールドアウトの分割、スコアラー、ラベルソース、n、陽性数、ステータス)。分割の役割はChen et al. (2026)のAARスイートに由来します。
data/variants.csvは、コンテキスト実験で使用された132個の入力バリアントすべてを一覧にしています。
results/には論文レベルの表が格納されています。
Hugging Faceでは、リリースは次のように構成されています:
data/benchmarks/<failure_type>/<benchmark>.jsonl   canonical instances (the paper's n)
data/human/<set>.jsonl                             human-labelled sets
data/variants/<benchmark>/<variant>.jsonl          every input view: ablation, official track, oracle, exclusion, ...
jev/responses/<benchmark>/<variant>/<battery>.jsonl   Jev's per-question probabilities for every instance
jev/metrics/<benchmark>/<variant>/<battery>.json      per-strategy precision, recall, F1, AUROC
provenance/                                        target-model generations, reference-scorer calls, official scores, logs
| コンポーネント | 場所 |
|---|---|
| AARハーネス周辺の生成と判定のリプレイ | code/generation/run_generate.py |
| 検出サンプルビルダー(バッテリーファミリーごとに1つ) | code/build_samples_*.py |
| 質問バッテリー(Jevと読み出し戦略に対して尋ねられる質問) | code/battery_*.py |
| Jevランナー、キャッシュ、メトリクス | code/run_jev.py、code/run_batch.sh |
| バッテリーリンター(基準の漏洩、フォーマット) | code/lint_battery.py、code/lint_criteria_leak.py |
| 結果サマリー | code/make_results_summary.py |
| リリースツール | tools/build_release.py、tools/legacy_layout.py |
コードはPython 3.10以降(論文では3.12を使用)と標準ライブラリのみを必要とします。リリースツールにはpandasも必要です。
これはリクエストを送信せず、キーも必要としません。すべてのメトリクスはJevのキャッシュされた回答から再計算されます。
pip install -U "huggingface_hub[cli]" pandas
huggingface-cli login                                   # after your access request is approved
huggingface-cli download sumleo/RLCDAlignBench --repo-type dataset --local-dir hf

python tools/legacy_layout.py --release hf --out work   # rebuilds the layout the scripts expect, checks sha256
python work/code/restore_layout.py
python work/code/run_jev.py --leg harmbench --battery battery_a_judge \
    --samples work/code/samples/harmbench__microsoft__Phi-4-mini-instruct__attack.jsonl --rescore
最後のコマンドは、読み出し戦略ごとに1行の表(precision、recall、F1、balanced accuracy、AUROC、bootstrap CI)を出力します。これはリリース内の jev/metrics/harmbench/attack/battery_a_judge_v2.json と一致します。
aar_repo/ を探します)、ラベルの構築元となったコミットをチェックアウトします:
git clone https://github.com/YuehHanChen/automated_alignment_researcher aar_repo
git -C aar_repo checkout 02dbe9d2cadc553720d17cdf6259c0b8727e6cde
aar_repo/REPRODUCE.md と同様):
python code/generation/run_generate.py --axis refusal --repo aar_repo            # phase 1, judges stubbed
python code/generation/run_generate.py --axis refusal --repo aar_repo --replay   # phase 2, real judges
code/build_samples_*.py で検出サンプルをビルドします(判定スコア対象のファミリー a、bc、f は --attach-judges を取ります)。ビルダーはラベルから各公式集計スコアを再計算し、公式のものと異なる場合は停止します。TYPESAFE_API_KEY を設定して Jev にクエリを送信します:
python code/run_jev.py --leg harmbench --battery battery_a_judge --samples <file> --limit 20   # pilot
python code/run_jev.py --leg harmbench --battery battery_a_judge --samples <file>              # full
データフロー: calls.jsonl → run_generate.py --replay → judge_calls.jsonl → build_samples_*.py → detection samples → run_jev.py → responses + metrics。