自動化された研究アーティファクト — 上流プロジェクトではありません。
このリポジトリは、公開されているGitHub Actionsワークフローの脆弱性の再現に関するラヴァル大学の修士論文のために、自動化ハーネスによって構築された使い捨てのラボです。これは、コミット
2a209b058c60823b57e8b7775b10244ff340eb8b(2025-05-14)時点のtimescale/pgaiの逐語的なスナップショットであり、そのプロジェクト自身のライセンスの下で再配布されています。そのライセンスファイルは、このスナップショットに変更なしで含まれています。上流プロジェクトは関与しておらず、決して標的にはなりません。ここで研究されている脆弱性はすでに公開されています。このリポジトリ内のすべてのシークレットと変数は、ランダムに生成されたダミー値です — 実際の認証情報は存在しません。アクションの参照とランナーイメージは、2025-05-14時点で解決されたものに固定されています。スナップショットに加えられたすべての変更については、ハーネス出力内の
pinning.mdを参照してください。質問や異議がある場合: [email protected]
PostgreSQLを、RAGおよびAgenticアプリケーション向けの堅牢で本番環境対応の検索エンジンに変えるPythonライブラリです。
🔄 PostgreSQLデータとS3ドキュメントからベクトル埋め込みを自動的に作成・同期します。データが変更されると、埋め込みは自動的に更新されます。
🔍 pgvectorとpgvectorscaleによる強力なベクトル検索とセマンティック検索。
🛡️ すぐに本番環境で使用可能: 効率的な埋め込み生成のためのバッチ処理をサポートし、モデルの障害、レート制限、レイテンシの急上昇に対する組み込みの処理を備えています。
🐘 Timescale Cloud、Amazon RDS、Supabaseなどを含む、あらゆるPostgreSQLデータベースで動作します。
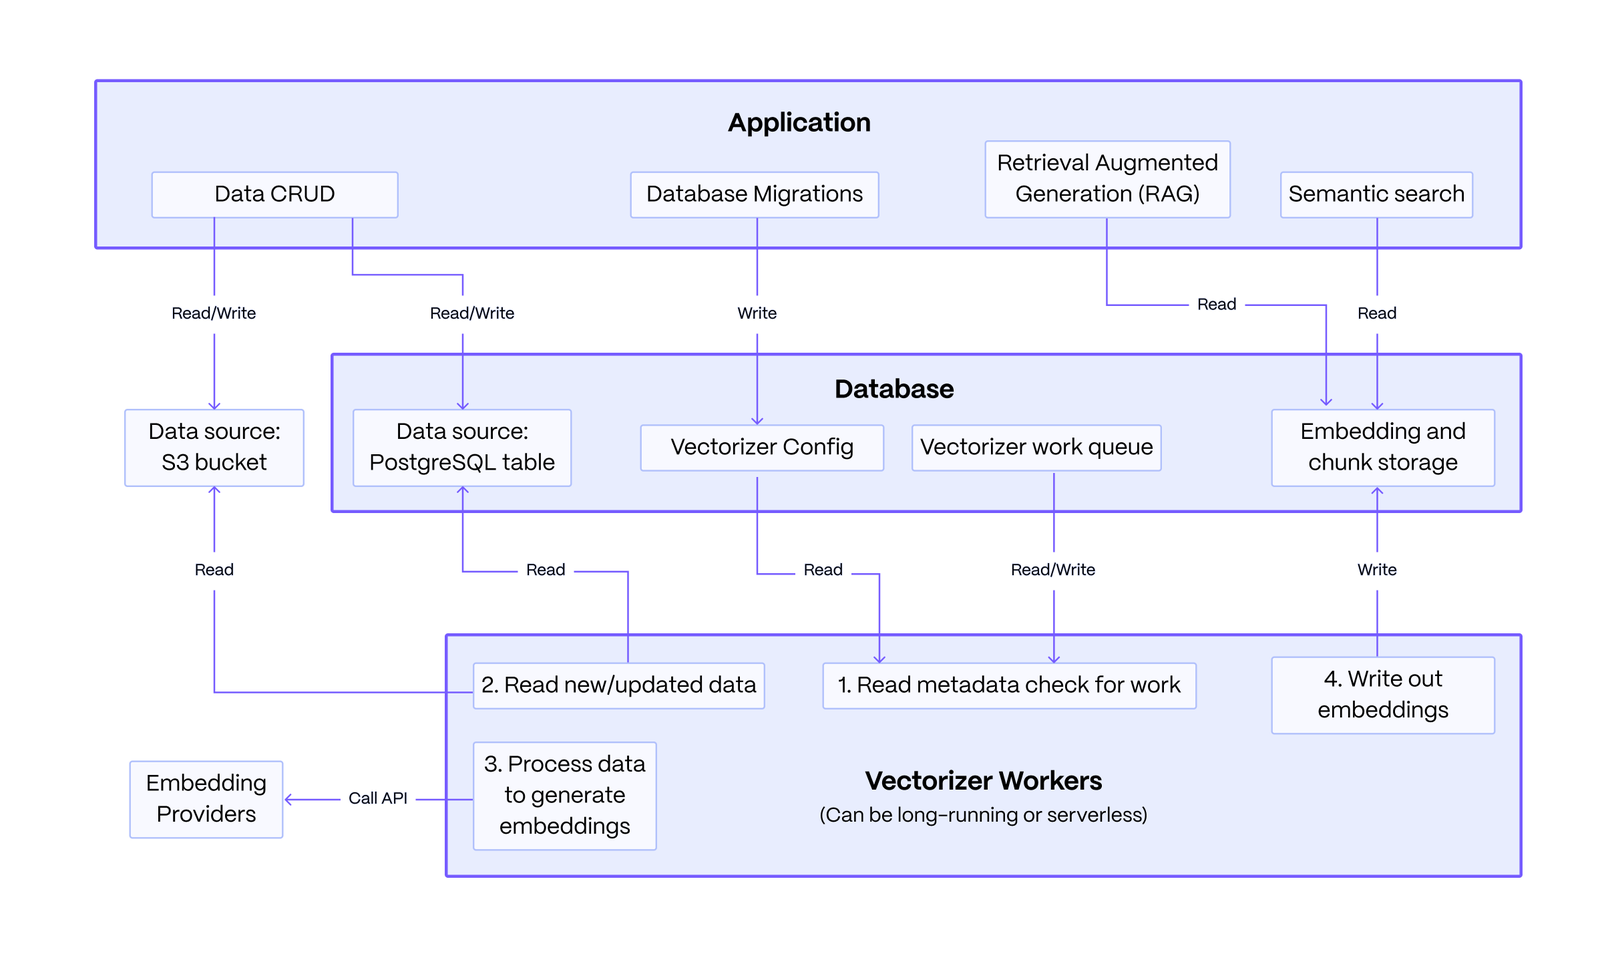
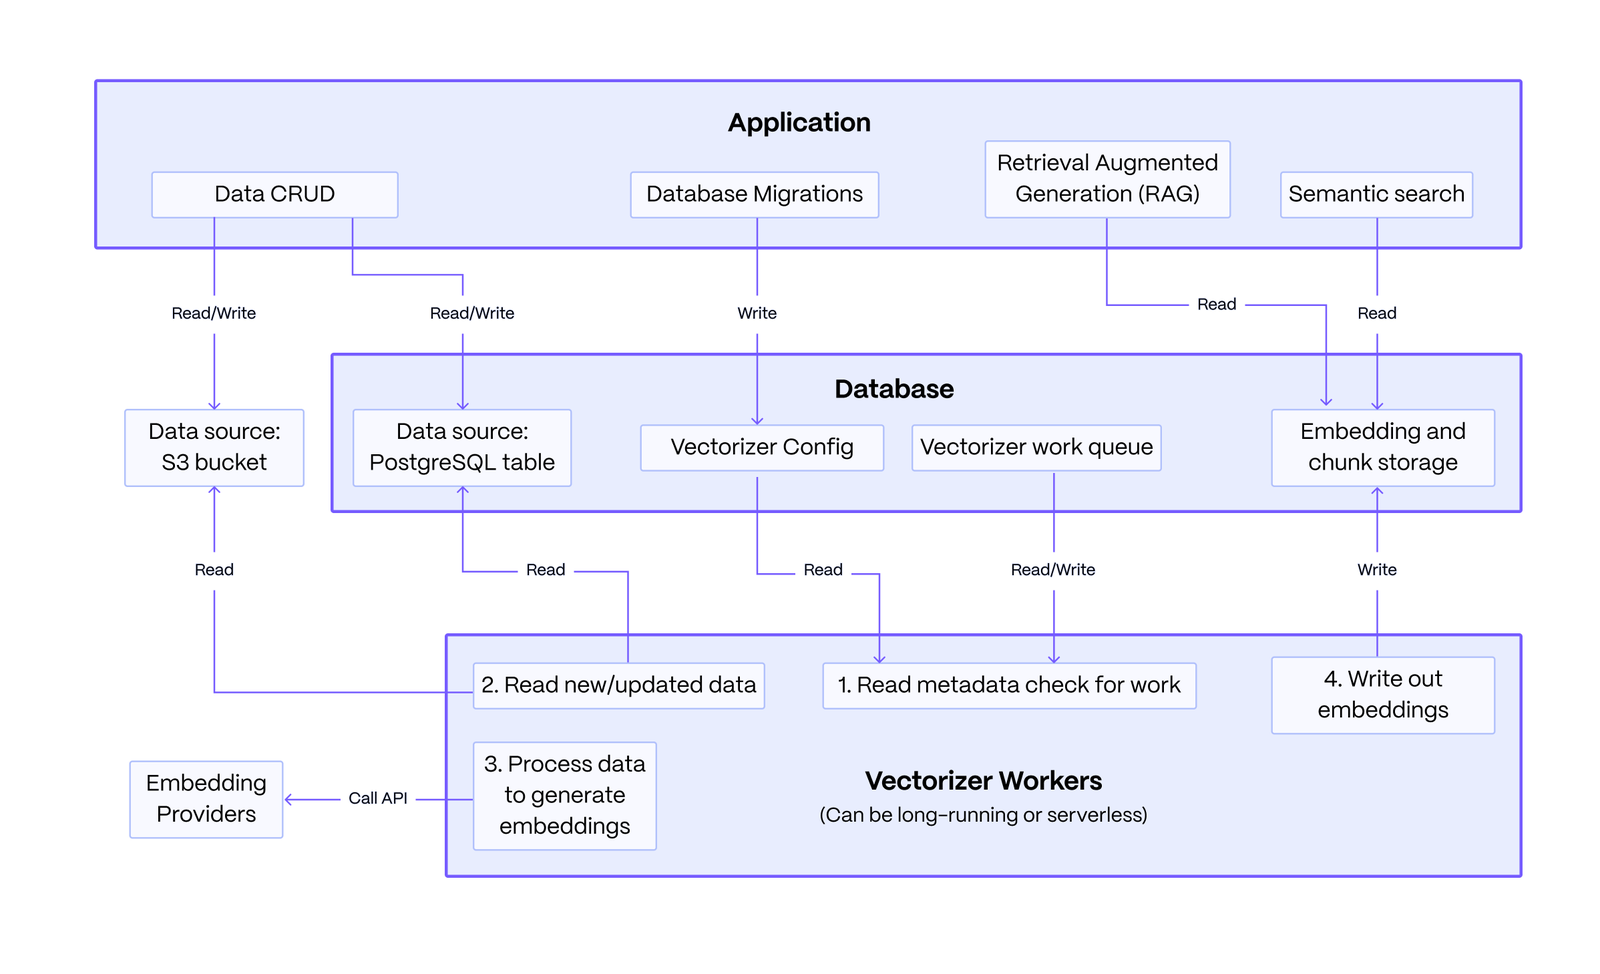
基本アーキテクチャ: このシステムは、ユーザーが作成するアプリケーション、PostgreSQLデータベース、およびステートレスなベクトライザーワーカーで構成されています。アプリケーションは、PostgreSQLやS3などのソースからのデータを埋め込むためのベクトライザー設定を定義します。ワーカーはこの設定を読み取り、データキューを埋め込みとチャンク化されたテキストに処理し、結果を書き戻します。その後、アプリケーションはこのデータをクエリして、RAGとセマンティック検索を強化します。
このアーキテクチャの主な強みは、その回復力にあります。アプリケーションによるデータ変更は埋め込みプロセスから分離されているため、埋め込みサービスの障害がコアなデータ操作に影響を与えることはありません。
まず、pgaiパッケージをインストールします。``` pip install pgai
次に、pgaiデータベースコンポーネントをインストールします。これは、ターミナルからCLIを使用して行うか、Pythonアプリケーションコード内でpgai Pythonパッケージを使用して行うことができます。```
# from the cli
pgai install -d <database-url>

# or from the python package, often done as part of your application setup
import pgai
pgai.install(DB_URL)
このクイックスタートでは、pgai Vectorizerがデータの変更に応じて埋め込みを自動的に作成・同期することで、PostgreSQLデータに対するセマンティック検索とRAGをどのように実現するかを説明します。
pgai Vectorizerの重要な「秘密のソース」は、埋め込み生成に対する宣言的なアプローチです。パイプラインを定義するだけで、Vectorizerが埋め込みを同期し続けるための運用上の複雑さを処理します。埋め込みエンドポイントが信頼できない場合でも同様です。パイプラインのシンプルなバージョンは、次のように定義できます。```sql CREATE TABLE IF NOT EXISTS wiki ( id INTEGER PRIMARY KEY GENERATED ALWAYS AS IDENTITY, url TEXT NOT NULL, title TEXT NOT NULL, text TEXT NOT NULL )
SELECT ai.create_vectorizer( 'wiki'::regclass, loading => ai.loading_column(column_name=>'text'), destination => ai.destination_table(target_table=>'wiki_embedding_storage'), embedding => ai.embedding_openai(model=>'text-embedding-ada-002', dimensions=>'1536') )
ベクタライザーは、`wiki` テーブルのすべての行に対して埋め込みを自動的に作成し、さらに重要なことに、基盤となるデータが変更されるたびに埋め込みを同期し続けます。**これは、`wiki` テーブルにインデックスを宣言するようなものだと考えてください**。ただし、データベースがインデックスのデータ構造を管理する代わりに、Vectorizer が埋め込みを管理します。

## クイックスタートの実行

**前提条件:**
- PostgreSQL データベース([docker の手順](https://docs.timescale.com/self-hosted/latest/install/installation-docker/))。
- OpenAI API キー(クイックスタートでは埋め込みに openai を使用しますが、[複数のプロバイダー](#supported-embedding-models)を使用できます)。

次の内容で `.env` ファイルを作成します:```
OPENAI_API_KEY=<your-openai-api-key>
DB_URL=<your-database-url>
クイックスタートの例から完全な Pythonコード と requirements.txt をダウンロードし、.env ファイルと同じディレクトリで実行できます。