できる。ただし機能する攻撃は一系統だけで、それは誰もが想定するものではない。
Unicodeの異体字セレクタ(カテゴリMn、U+FE00〜U+FE0FおよびU+E0100〜U+E01EF)は検出器を閾値未満に押し下げ、そのままそこに留まる。私が試した他のあらゆる不可視文字攻撃は、1行の入力正規化によって完全に元に戻される。異体字セレクタはそうならない。なぜならそれらは意味を持つコードポイント(絵文字の表示形式、CJKの異体字)であり、NFKCが畳み込まない、また畳み込むべきでもないものだからだ。
モデルとドメインをまたいで再現済み:
| モデル | ドメイン | ベースライン z | vs16_30 適用後 | 編集率 |
|---|---|---|---|---|
| gpt-oss-20b | 散文 | 45.03 | 0.72 | 57% |
| gpt-oss-20b | コード | 37.24 | 0.68 | 58% |
| Qwen3.8-27B | 散文 | 35.50 | -0.67 | 57% |
閾値は z = 2.33。3つすべてが攻撃後に閾値を下回り、正規化後も下回ったままである(それぞれ 0.09、0.45、-0.78)。テキストは人間の読者には同一に表示される。
2つ目の実際の知見は攻撃をまったく必要としない: 低エントロピーのテキストはそもそもほとんど透かしが入っていない。 思考を無効にすると、Qwen3.8-27Bの純粋なコード出力は攻撃なしで z = 4.31 を記録し、何も施していない状態で閾値2.33に近い。思考を再び有効にすると、同じモデル、同じドメイン、同じ長さで z = 25.53 に達する。推論の前置きが通常の散文であり、透かしを正常に担うからだ。
このリポジトリのすべては、以下でのみ測定されており、それ以外では測定されていない:
| モデル | パラメータ数 | 実行環境 | 実行内容 |
|---|---|---|---|
| Qwen3.5-0.8B | 0.8B | Mac (MPS) | 攻撃ラダー全体、1k〜8k |
| Qwen3.5-4B | 4B | Mac / 4090 | 攻撃ラダー全体 + エントロピー実験 + ステゴ生/正規化 |
| DeepSeek-R1-Distill-Qwen-14B | 14B | Mac (MLX, 4-bit) | 透かし + 検出、推論トレース |
| gpt-oss-20b | 20B | 3090 / 4090 / RunPod | 32kまでの攻撃ラダー全体、散文 + コード、異体字セレクタ、131kまでの挿入率スケーリング則 |
| Qwen3.8-27B | 27B | RunPod H100 / Modal H100 | 散文 + コード、異体字セレクタ、思考モードの対比 |
| gpt-oss-120b | 120B | Modal H100 (MXFP4) / RunPod H100 | 2k / 8k / 32kでの散文 + コード + 推論、65kまでの部分的な挿入率スケーリング |
| DeepSeek-V4-Flash | 284B MoE | RunPod 2x H200 (FP8) | 2k / 8kでの散文 + コード |
すべての実験がすべてのモデルで実行されたわけではなく、以下の表はどれがどこで実行されたかを示している。興味深い問いが絞り込まれるにつれてより大きなモデルが追加されたため、攻撃ラダーは小さなモデルで広範にわたり、長さとドメインに関する作業は大きなモデルに集中している。
Anthropic(そしてその前のGoogle DeepMind、SynthID-Text論文)は、鍵付きトーナメントでトークンサンプリングにバイアスをかけることで生成テキストに透かしを入れる。信号はどのトークンが選ばれたかに存在し、隠し文字にあるのではない。私はこれが、検索置換を手にした意欲的な人物に対してどれほど脆いかを知りたかったので、生成器と未学習の平均g検出器を構築し、それに対して攻撃を仕掛けた。
検出器の閾値は z = 2.33(偽陽性率1%)。これを上回る = 透かし検出。私は透かし入りテキストを生成し、攻撃し、再トークン化し、スコアリングした。すべての結果表にはroundtrip対照(攻撃されていない透かし入りテキスト)が含まれており、その行で検出器が実際に機能していることを確認できる。この研究の間に2度、バグによってすべてのzがゼロに崩壊したが、それを捉えたのはこの対照だけだった。
攻撃対象領域はUnicodeカテゴリによって明確に分かれ、それが結局すべてだった。
機能する(カテゴリMn、非間隔記号):
| 攻撃 | 内容 | 編集率 | 正規化を生き延びるか? |
|---|---|---|---|
vs16_30 | 約30%の文字の後に異体字セレクタ | 57% | はい |
vs16 | 約10%の文字の後に異体字セレクタ | 23% | はい (z 3.46) |
vs_supp | 補助面のセレクタ (U+E0100+) | 24% | はい (z 3.40) |
homoglyph | ラテン文字aの代わりにキリル文字а (カテゴリLl) | 9% | はい、ただし効果は弱い |
機能しない(カテゴリ Cf、書式文字):
| 攻撃 | raw z | 正規化後 z | 判定 |
|---|---|---|---|
zwsp_30 | -0.09 | 35.68 | 完全に復元 |
combo | 0.92 | 35.68 | 完全に復元 |
bidi | 24.37 | 35.68 | 完全に復元 |
nbsp | 41.04 | 46.51 | ほとんど変化なし |
Cf 文字は意味的内容を持たない純粋な書式設定であるため、正規化器はそれらを一括で除去しても何も失わない。Mn 異体字セレクタは絵文字や CJK テキストにおいて実際の意味を持つため、一律に除去すると正当な文書を破壊してしまう。この非対称性こそが、一方のファミリーは正当化でき、もう一方はできない理由である。
実用的な範囲: 強力なベースラインを閾値以下に押し下げるには、文字のおよそ 20% 以上を改変する必要があるが、挿入される文字は不可視であるため、どの編集率でもテキストは通常どおり読める。視覚的に同一であることが検証済みである。詳細は src/fidelity_check.py を参照。4 つのファミリーは何も描画しない文字のみを挿入する。ホモグリフは正直な例外である(フォント依存であり、不可視であることは保証されない)。
私の当初の懸念はありふれたものだった。em ダッシュや「and」から「&」への置換、マークダウンの除去が単純に機能し、ウォーターマークはセキュリティシアターに過ぎないのではないか、と。オンラインの多くの人々はまさにそう考えている。
それは機能しない。gpt-oss-20b における表層編集のはしご全体を、32k トークンまで試した結果:
| 攻撃 | 編集率 | z @ 1k | z @ 32k |
|---|---|---|---|
| roundtrip(対照) | 0% | 25.7 | 104.3 |
| em ダッシュからハイフンへ | ~0% | 26.4 | 113.7 |
| すべてのマークダウンを除去 | 13.6% | 27.2 | 103.3 |
| AmE から BrE + 略語 | 1.3% | ~28 | ~100 |
| 各単語の 40% を削除 | 38% | 4.9 | 25.4 |
このはしごを実行した 3 つのモデル(0.8B、4B、20B = 294 セル)を通じて、閾値を超えたセルはちょうど 1 つ だけだった。4B の最短長において各単語の 39% を削除したケースである。それは攻撃ではなく、文書の細断である。
研究全体で測定された総セル数:440(上記の攻撃はしごからの 294 に加え、散文を 131072 トークンまで拡張した以下のスケーリング則スイープからの 146)。
驚いたことが 2 つある:
完全なメカニズムと攻撃ごとの表は docs/FINDINGS.md にある。
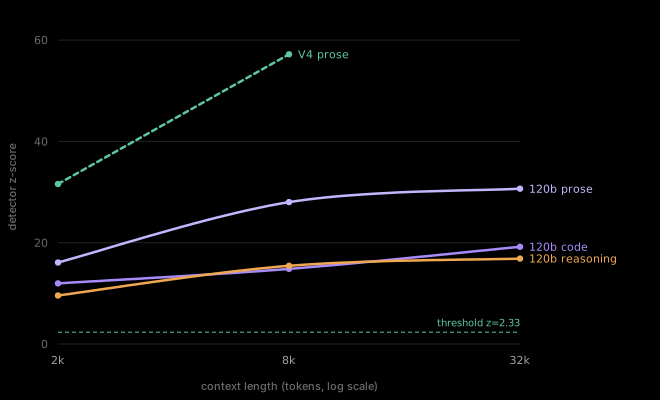
ウォーターマークの信頼度はコンテキストとともに増大する一方、トークンあたりの信号は一定のままであるため、長い文書は攻撃するのがより難しく、簡単ではない。散文はどの長さでも最も強いマークを運ぶ。DeepSeek-V4-Flash(破線)は 284B MoE 上で同じ上昇を再現する。
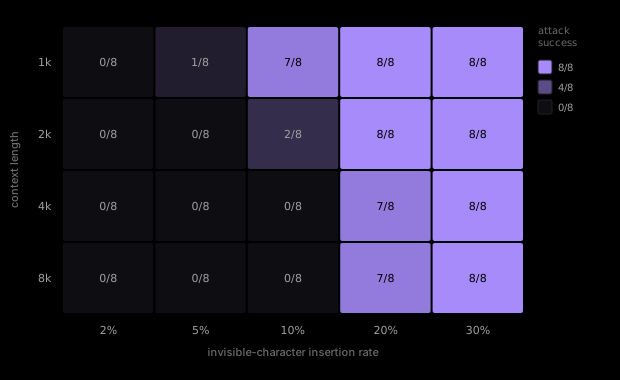
そして攻撃はそれに追従し続けなければならない。各セルは、8 つのランダムな挿入シードのうちいくつが検出器を打ち負かしたかを示す。10% の挿入は 1k トークンでは突破できるが、4k までには完全に失敗する。必要な挿入率はコンテキスト長とともに上昇する。これが攻撃がコンテキスト非依存でない理由である。
専用の追跡スイープがこれを明確にする。gpt-oss-20b において、1024 トークンから 131072(モデルの最大コンテキスト)まで、必要な率は p*(L) ≈ 2.37·log2(L) − 14.6 に従う——1k トークンでの 9.3% から 131k での 25.0% へと上昇する。
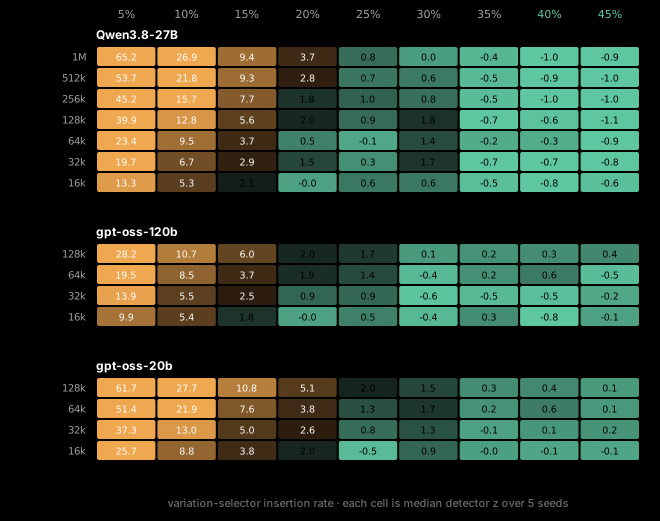
では当然の次の疑問は、文書を十分に長くすれば最終的に検出器が完全に勝つのではないか、という点です。これを確かめるため、スイープを 1,048,576 トークンまで拡張しました。3モデル × 全コンテキスト長 × 挿入率で、上の各セルは5シードにわたる検出器 z の中央値であり、攻撃が勝った箇所(z < 2.33)はティール、透かしが生き残った箇所はオレンジで示しています。
答えはノーです。防御側の先行優位は拡大しますが、攻撃側のコストはより緩やかにしか増えません:
| モデル | 測定した長さ | 最短時の p* | 最長時の p* | 倍増あたり |
|---|---|---|---|---|
| gpt-oss-20b | 16k – 131k | 19.0% | 24.5% | +1.86 pp |
| gpt-oss-120b | 16k – 131k | 14.2% | 19.5% | +1.91 pp |
| Qwen3.8-27B | 16k – 1,048,576 | 14.7% | 22.4% | +1.21 pp |
ベースラインの透かし強度は √n のように上昇しますが、それを消すのに必要な挿入率は、コンテキストが倍増するごとにわずか約1.2〜1.9パーセントポイントしか上昇しません。測定した135の攻撃セルのうち、35%以上の挿入率にある45セルすべてが閾値を下回りました -- 最悪ケースは35%で z = 0.31、40%で z = 0.60 です。実際に必要とされた最高の挿入率は24.5%で、これは131kにおける gpt-oss-20b の値でした。16kから1Mトークンへ、つまり64倍への増加で、検出器が得たのは約8パーセントポイントにすぎません。
率直に述べておくべき注意点が2つあります。gpt-oss-120b の以前の「部分実行」は今回完了し、131kで測定された19.5%が、以前に4つの長さのうち3つから外挿された約20〜23%という数値を置き換えます。また、Qwen3.8-27B のベースライン z は7つの長さすべてで14.85のまま横ばいです -- これは文書の退化による真のアーティファクトであるため、その絶対的な強度の数値は信頼できないものとして扱ってください。それが示す長さスケーリングの傾向は他の2モデルと一致しており、上の表はそれを使用しています。完全な表、フィット、注意点は docs/FINDINGS.md § 14 にあります。
インタラクティブ版を試す → 実際の研究サンプルをビフォー/アフターの切り替え表示で確認でき、さらに自分のテキストに攻撃変換を実行できるプレイグラウンドも用意しています。任意に貼り付けたテキストが本当に透かし入りかどうかを判定することはできません(それには我々が持っていない鍵が必要です)、そしてその旨が明記されています。生成スクリプトについては site/ を参照してください。
透かしはモデルのトークンごとの不確実性に乗っています。モデルが次のトークンに自信を持っている箇所では、トーナメントがそれを偏らせる余地がないため、信号が入りません。つまりマークは低エントロピーのテキストでは弱く、コードは低エントロピーです。
Qwen3.5-4B、散文 vs コード、512トークンのサンプル、攻撃は一切なし:
| ドメイン | エントロピー | z |
|---|---|---|
| 散文 | 1.19 bits/tok | 11.1 |
| コード | 0.55 bits/tok | 5.0 |
z 比 0.45x、エントロピー比 0.46x、両者は連動しており、これがメカニズムそのものが表れている証拠です。8つのコードサンプルのうち3つが、単独で検出閾値以下まで低下しました。 最も際どいもの(素のアルゴリズム、0.2 bits/token)は1.7で、検出失敗でした。
スケールが大きくなるとさらに極端になります。攻撃を一切行わないベースライン z:
| モデル | 散文 | コード | 比率 |
|---|---|---|---|
| gpt-oss-20b | 45.03 | 37.24 | 0.83 |
| Qwen3.8-27B | 35.50 | 4.31 | 0.12 |
Qwen3.8-27B のコード出力はあまりにテンプレート化されているため、攻撃を受けていないクリーンな透かしが z = 4.31 にとどまり、2.33の閾値をわずかに上回るだけです。敵対者は不要です。
これが意味するのは、ドメインをまたいで単一の信頼度閾値を使うのは安全ではなく、短いコードスニペットはほぼ透かしを入れられないということです。JSON、設定、構造化抽出、定型文にも一般化できます。
これらの検出器のいずれかを提供する場合、入力を正規化することで大部分は対応できますが、すべてではありません:
ステップ3と4は、素朴な正規化では見落とされるものです。
ギャップについて正直に述べます。