

heretic v2.0.0
トレーニング不要の言語モデル改変:検閲の除去、スロップの抑制、追従性の低減など
Heretic
トレーニング不要の言語モデル改変
検閲を除去し、スロップを抑制し、追従性を低減、その他多数。
すべてを午後のひとときで、あなたのゲーミングPC上で。


あなたのハードウェアで実行できるあらゆるLLMを改変1
Hereticは、通常は膨大な計算資源を持つ企業だけが行えることを可能にする ユニークなツールです。つまり、言語モデルを単に実行するのではなく、改変するのです。 高コストなトレーニングを行うのではなく、対照的な例示プロンプトと対応するスコアラーに基づいて 振る舞いを誘導する、一連の数学的手法を用います。
Hereticは設定に応じて以下が可能です:
- 拒否を抑制/検閲を除去(これがデフォルトの動作です)
- スロップを低減(
config.noslop.toml) - ユーモアを低減(
config.nohumor.toml) - 追従性を低減(
config.nosyco.toml) - 感情的な整合性を変更(
config.emotions.toml)
その他、非常に多くのことが可能です。
‼️ Hereticの使用に、言語モデルの内部動作を理解している必要はありません ‼️
実際、最初のモデルから検閲を除去するまで、 ほんの数秒でゼロから始められます。Hereticはほとんどの密なモデル、 多くのマルチモーダルモデル、いくつかの異なるMoEアーキテクチャ、そして多くの現代的な ハイブリッドモデルをサポートしています。
コミュニティはHereticを用いて 数千ものモデルを作成・公開しています。 HereticのモデルはMMLUやGSM8Kといった標準的な指標で独立にベンチマークされており、 競合するアブリテレーションツールで生成されたモデルと比較して遜色ない、あるいは優れていることが 確認されています。23
使用方法
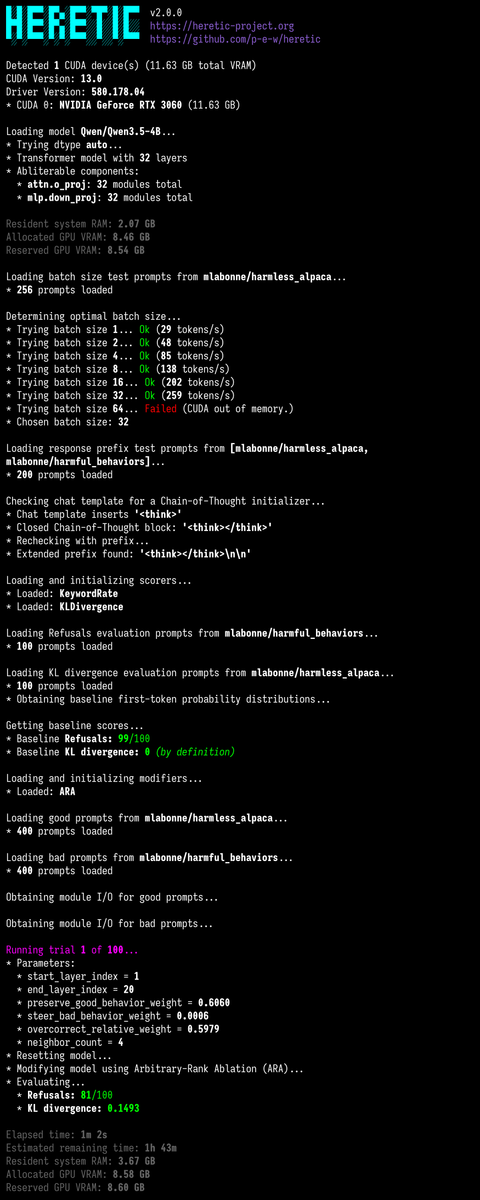
お使いのハードウェアに適した形でPyTorch 2.6以降をインストールした Python 3.10以降の環境を用意してください。その後、以下を実行します:
pip install -U heretic-llm
heretic Qwen/Qwen3-4B-Instruct-2507
Qwen/Qwen3-4B-Instruct-2507 を、処理したい任意のモデルに置き換えてください。
デフォルトでは、Heretic は検閲の除去(拒否の抑制)を実行します。
別のことをしたい場合は、上記でリンクされている設定ファイルのいずれかを選択するか、独自の設定ファイルを作成してください。利用可能な設定オプションについては config.default.toml を参照してください。
[!IMPORTANT]
Heretic 1.x 用に作成された設定ファイルは、Heretic 2.x とは互換性がありません! 古い設定を動作させるために変更が必要な内容については、移行ガイドを参照してください。
プログラムの実行開始時に、Heretic は利用可能なハードウェアを最大限に活用するため、最適なバッチサイズを決定するためにシステムをベンチマークします。 RTX 3090 上で、デフォルト設定の場合、 Qwen3-4B-Instruct-2507 の処理には約 30〜40 分かかります。
Heretic がモデルの処理を完了すると、モデルを保存する、Hugging Face にアップロードする、どれだけうまく機能するかをテストするためにチャットする、標準ベンチマークを実行する、またはこれらの任意の組み合わせを選択できます。
スコアラープラグインを使用した Heretic の動作の制御
Heretic は、1 つまたは複数のスコアを最適化することでモデルの動作を誘導します。スコアはスコアラープラグインによって計算されます。独自のスコアラーを簡単に作成して、Heretic がモデルに対して行うことを完全に制御できます。
スコアラーが継承する必要がある Scorer インターフェース(抽象基底クラス)は、scorer.py で定義されています。必須のメソッドは get_score のみですが、必要に応じて利用できる仕組み(設定管理など)が他にもあります。
デフォルトでは、Heretic は拒否率(keyword_rate.py で実装)と KL ダイバージェンス(kl_divergence.py で実装)によってモデルをスコアリングします。
追加のスコアラーは scorers ディレクトリで利用できます。
これらのスコアラーは独自の実装の例として役立ち、ニーズに合わせて簡単に適応できます。
スコアラーはメイン設定ファイルを通じて設定されます。
どのスコアラープラグインが有効になるかは scorers 設定によって決まり、この設定は最適化中にスコアラーのスコアを最小化するか最大化するかも制御します。任意の数のスコアラーを同時に使用でき、それらのスコアは共最適化されます。同じスコアラーの複数のインスタンスを異なる設定で構成できます。この仕組みの完全なドキュメントについては設定ファイルを参照してください。
スコアラープラグインへのパスは、完全修飾インポートパス(fully.qualified.module.MyScorerClass)として、またはファイルパスの後にクラス名を続けた形式(path/to/plugin.py:MyScorerClass)で指定できます。独自のプラグインを使用するために Heretic パッケージのコードを変更する必要はありません。
Heretic にはモディファイアプラグインもあり、これらについては 次のセクションで説明します。
Heretic の仕組み
Heretic は、プラグ可能なモディファイア(インターフェースは
modifier.py)と、Optuna を利用した TPE ベースのハイパーパラメータオプティマイザーを組み合わせています。オプティマイザーは、モディファイアに渡されると結果のモデル上で設定可能なスコアのセットを最小化または最大化するパラメータのセットを見つけます(上記参照)。
Heretic には 2 つのモディファイアが付属しています:
-
Arbitrary-Rank Ablation (ARA)4: これはデフォルトのモディファイアであり、Heretic での使用のために特別に開発されました。ARA の仕組みの概要は元のプルリクエストで確認でき、正確な実装は
ara.pyで確認できます。 -
Directional ablation aka "abliteration"5: 拒否抑制のための古典的な手法です。Heretic の実装では、レイヤー全体にわたる柔軟なアブレーション重みカーネルを使用し、投影アブリテレーション6とノルム保存(MPOA)7の両方をサポートしています。 完全なコードは
abliteration.pyにあります。
modifiers 設定を使用して、モディファイアの実装を切り替えることができます。
この設定名は複数形ですが、Heretic では現在、1回の処理実行につき
1つのモディファイアのみ使用できます。これは将来的に変更される可能性があります。
再現性と Heretic Grimoire
Heretic には、再現可能なモデルを作成する機能があります。そのリポジトリには、 環境が元の環境と完全に同一であることを条件に、オンデマンドでバイト単位で同一のモデルを 生成するために必要なすべての情報が含まれます。PyTorch は、ハードウェア、ドライバ、 オペレーティングシステム、およびすべてのパッケージバージョンを含むソフトウェアスタック全体が 完全に同一でない限り、演算が同一の出力を返すことを保証しません。
Heretic は、そのような複雑さをすべて管理します。処理済みモデルを
Hugging Face にアップロードする際、Heretic は再現性情報を含めることを提案します。これは完全に
任意ですが、含めることを選択した場合、アップロードされたリポジトリにはモデルを再作成するための
詳細な手順を含む reproduce フォルダが含まれます
(例)。
このフォルダには、人間が読める手順と、Heretic がモデルを自動的に再現するために必要な
すべての情報を含む reproduce.json という名前の機械可読マニフェストファイルの
両方が含まれます。
自動再現は次のコマンドで実行できます
heretic --reproduce path/to/reproduce.json
Hereticはプロセスを案内し、モデルの作成に使用された環境とあなたの環境を照合して、問題となる可能性のある不一致を指摘します。元のモデルを作成するために必要だった数時間に及ぶ計算をやり直す必要はなく、プロセス全体は通常数分で完了します。結果のモデルをエクスポートした後、Hereticは重みファイルのハッシュを再現マニフェストに保存されているものと照合して検証します(あなたのシステムが元のシステムにどれだけ似ているかによって、一致する場合も一致しない場合もあります)。
Footnotes
-
https://raw.githubusercontent.com/p-e-w/heretic/master/Heretic%E3%81%AFbitsandbytes%E3%81%AB%E3%82%88%E3%82%8B%E3%82%AA%E3%83%B3%E3%82%B6%E3%83%95%E3%83%A9%E3%82%A4%E3%81%AE4%E3%83%93%E3%83%83%E3%83%88%E3%83%A2%E3%83%87%E3%83%AB%E9%87%8F%E5%AD%90%E5%8C%96%E3%82%92%E3%82%B5%E3%83%9D%E3%83%BC%E3%83%88%E3%81%97%E3%81%A6%E3%81%8A%E3%82%8A%E3%80%81 モデルの処理に必要なVRAM量を、そのモデルの一般的な量子化版を実行するのと同じ量まで削減できます。 ただし精度はわずかに低下します。有効にするには
quantizationオプションをbnb_4bitに設定してください。 ↩ -
https://old.reddit.com/r/LocalLLaMA/comments/1sojjoc/abliterlitics_benchmark_and_tensor_analysis/ ↩
-
https://old.reddit.com/r/LocalLLaMA/comments/1sy18lx/abliterlitics_benchmarks_and_tensor_comparison/ ↩
-
Weidmann 2026. この手法を説明するプレプリントが近日公開予定です。 ↩