
 #1

 zju-llm-safety/ascent
ファインチューニングフレームワーク。LLMに対して一次最適安全性キャリブレーションと定期的な再キャリブレーションを適用し、安全性と両立する更新を維持しつつ下流タスクの有用性を向上させる。
 tz98lab/dlr-ne-ics-security
高度な持続的脅威と移動標的防御の間の確率的ICSセキュリティゲームに対する動的低ランクナッシュ均衡計算を実装した研究コード。
 abhinavdubey30/perturbed-embedding-vectors
論文「Jailbreaking Open-Weight LLMs via Random Embedding Perturbations」のコード、レスポンスログ、ラベル
 arxhr007/aliens_eye
AI powered OSINT engine to discover and map 840+ social media identities across the web
 jisung-pacific/hdi-graphrag-attack
GraphRAGパイプラインにおけるLLMを用いた構造的補助インデックス脆弱性を明らかにする、Hop-Decayed Influence(HDI)と3S攻撃フレームワークの研究実装。
 lzwhehe/benign-instruction-bench
Re-evaluating prompt-injection detectors on LLM agent tool outputs (paper draft, scripts, scores)
 hoodoer/colonelclustered
Java製のBurpプラグインで、サーバーレスポンスの実際の内容に基づいてレスポンスに対してテキストクラスタリングを実行し、外れ値やグループを特定します。たとえばIntruderの実行結果からなどです。
 rbidou/pyrasp
Runtime Application Self Protection for Python web servers, serverless functions and MCP servers, detecting attacks, prompt injection and data leaks…
 euph00/zoneclaw-code
OpenClawスタイルのコンピュータ操作エージェントに対する永続メモリ攻撃のベンチマークおよび防御コード。メモリゾーニングによる緩和策、攻撃シナリオ、評価スクリプトを含む。
 sliu11-byte/mea-bench
ブラックボックスLLM抽出攻撃、防御、および適応型攻撃のためのライフサイクルベンチマーク。
 js-lee-ai/refusal-relocates
Refusal localizes, the damage relocates, safety layers under few-sample fine-tuning
 liuz233/harde
HARDEの研究コード。エージェントの安全性ベンチマーク全体にわたる実行時リスク検出と実行制御のために、コンポーネントをプローブし適応的に最適化するエージェントハーネス。
 kevinchunye/prompt_injection
ツールを使用するLLMエージェントパイプラインにおいて、プロンプトインジェクション防御がどこで発火するかを測定するベンチマークハーネス。公開、永続化、中継、実行の各段階にわたってカナリートークンを追跡する。
 joshuaprovoste/deserializer
AI、LLM、ロボティクス、データサイエンス、機械学習、深層学習(ただしこれらに限定されない)におけるPythonのRCE経路と深いデシリアライゼーションチェーンを発見するための、エージェント型LLM駆動の関係マッピングを備えたASTベースの静的コードアナライザー。
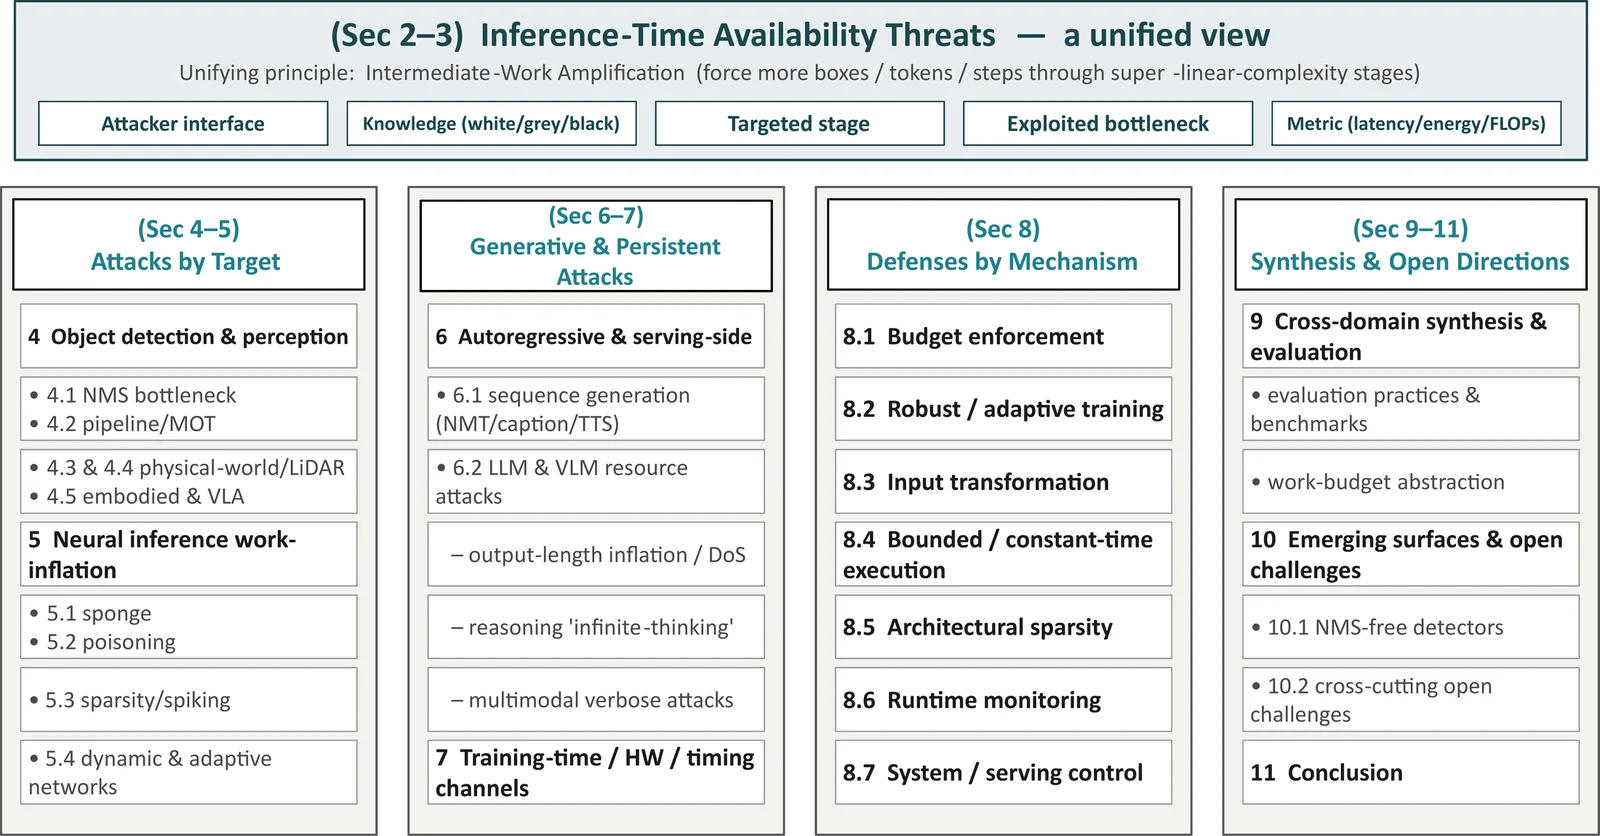 guzonghua/awesome-latency-attacks
深層学習のレイテンシ、エネルギー・レイテンシ、およびタイミング(可用性)攻撃と防御のキュレーションされたインデックス — ACM Computing Surveys 投稿のコンパニオン。
 facebookresearch/meta_secalign
プロンプトインジェクション攻撃に対する防御のためのオープンウェイトLLMとトレーニング/評価コード。エージェント型ツール呼び出しと指示追従のセキュリティに関するベンチマーク付き。
 kaill-jlq/mmskillrisk
LLMエージェントがマルチモーダルスキル画像に隠された悪意のある指示に抵抗できるかをテストするベンチマークおよび評価ハーネス。5つのリスクカテゴリにわたる108件のケースとASR/TSRスコアリングを備える。









