 zydak/leetobfuscator
Offusca C/C++ tramite passi LLVM: crittografia delle stringhe, appiattimento del flusso di controllo, riscrittura MBA e anti-analisi per contrastare il reverse engineering.

██╗     ███████╗███████╗████████╗
██║     ██╔════╝██╔════╝╚══██╔══╝
██║     █████╗  █████╗     ██║
██║     ██╔══╝  ██╔══╝     ██║
███████╗███████╗███████╗   ██║
╚══════╝╚══════╝╚══════╝   ╚═╝

 ██████╗ ██████╗ ███████╗██╗   ██╗███████╗ ██████╗ █████╗ ████████╗ ██████╗ ██████╗
██╔═══██╗██╔══██╗██╔════╝██║   ██║██╔════╝██╔════╝██╔══██╗╚══██╔══╝██╔═══██╗██╔══██╗
██║   ██║██████╔╝█████╗  ██║   ██║███████╗██║     ███████║   ██║   ██║   ██║██████╔╝
██║   ██║██╔══██╗██╔══╝  ██║   ██║╚════██║██║     ██╔══██║   ██║   ██║   ██║██╔══██╗
╚██████╔╝██████╔╝██║     ╚██████╔╝███████║╚██████╗██║  ██║   ██║   ╚██████╔╝██║  ██║
 ╚═════╝ ╚═════╝ ╚═╝      ╚═════╝ ╚══════╝ ╚═════╝╚═╝  ╚═╝   ╚═╝    ╚═════╝ ╚═╝  ╚═╝

A simple obfuscator for C/C++ x64 and x86 code
Questo è realizzato come un fork di LLVM, quindi hai bisogno del codice sorgente effettivo per offuscare. Non è un offuscatore arbitrario di eseguibili. È una versione modificata del compilatore.
Se vuoi dare un'occhiata ai risultati, ho creato e offuscato 2 crackme con questo. Puoi ottenerli in releases insieme al binario clang precompilato.
Tutto questo è stato compilato con il flag -O3 e tutte le schermate provengono da IDA Pro 9.4. L'ho testato anche con Binary Ninja e Ghidra, i risultati erano uguali o peggiori.
Cifra le stringhe in fase di compilazione e inserisce una funzione di decifratura a ogni utilizzo della stringa cifrata. Questo disabilita completamente la possibilità di cercare qualsiasi stringa nel binario. E ogni stringa ha la propria chiave univoca hardcoded nella funzione di decifratura, il che rende il dump e la decifratura molto più difficili. Queste funzioni di decifratura saranno anche inline. (non inline qui sotto solo per dimostrazione)
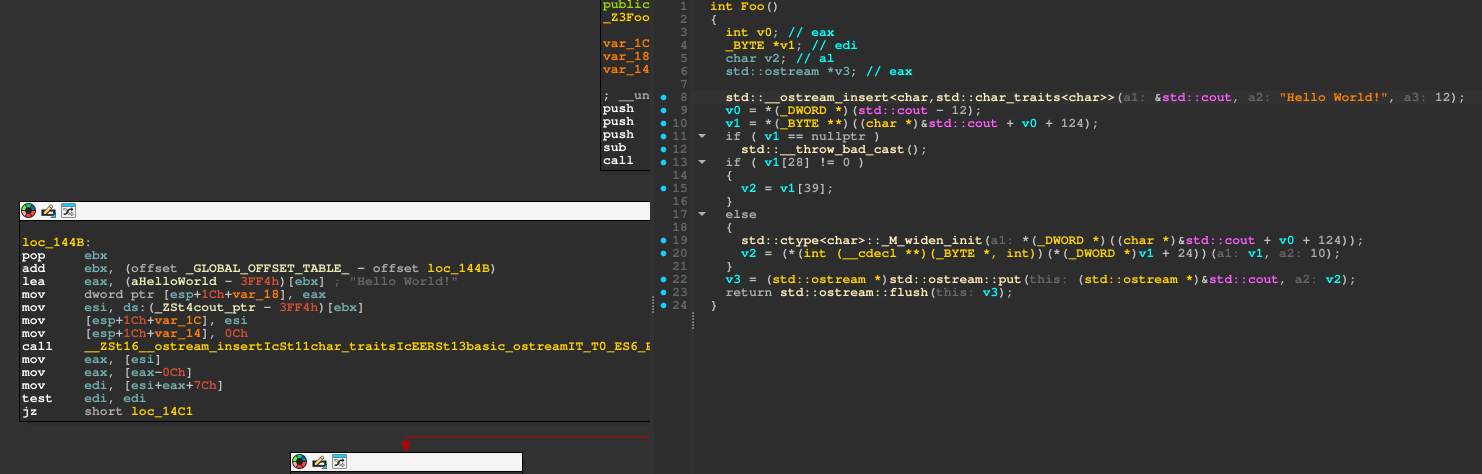 Prima del passaggio |
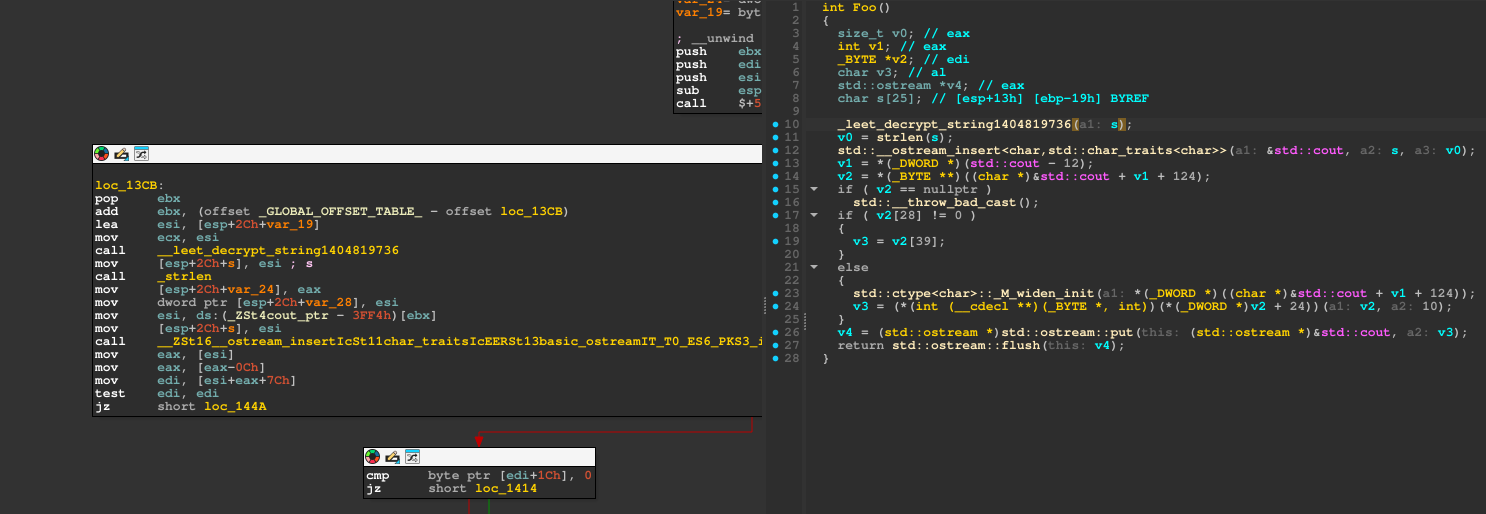 Dopo |
Sostituisce le operazioni aritmetiche con i loro equivalenti MBA. È praticamente impossibile vedere cosa facesse l'operazione originale a meno che non la si esegua prima attraverso un deoffuscatore MBA. Naturalmente questo offuscamento è alquanto debole perché MBA è il trucco più vecchio del libro, quindi ci sono molti strumenti per gestirlo, ad esempio CoBRA, che riuscirà a deoffuscare con successo questo nell'espressione originale:
./cobra-cli --mba "((x^y) - (((x^y)&0xFF)&0xA) + 10) * ((x^y) - ((x^y)|0xA) + 10) + ((x^y) - (((x^y)&0xFF)|0xFFFFFFF5) - 11) * (~(x^y) - (~(x^y)|0xA) + 10)" --bitwidth 32

10 * (x ^ y)
Ecco perché ho creato il pass AAMBA.
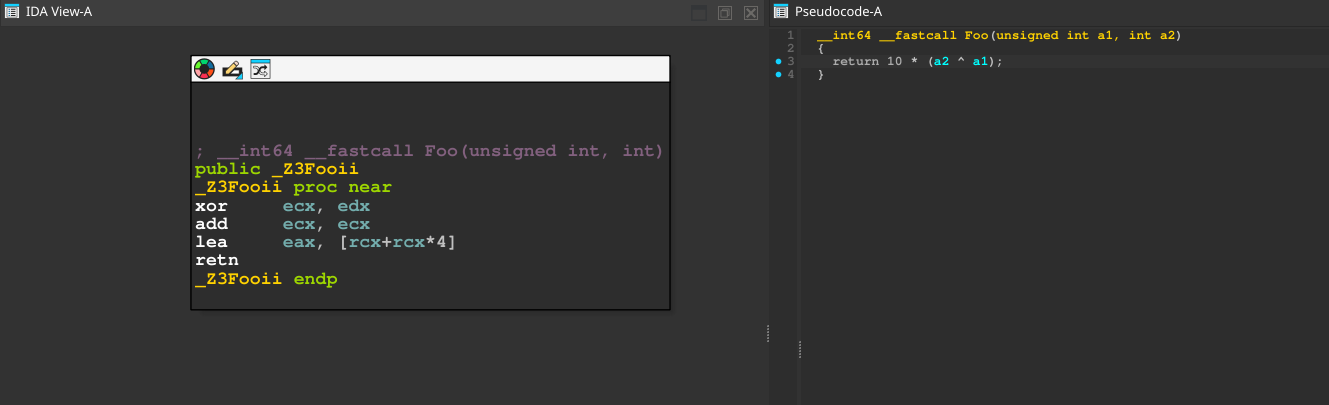 Prima del pass |
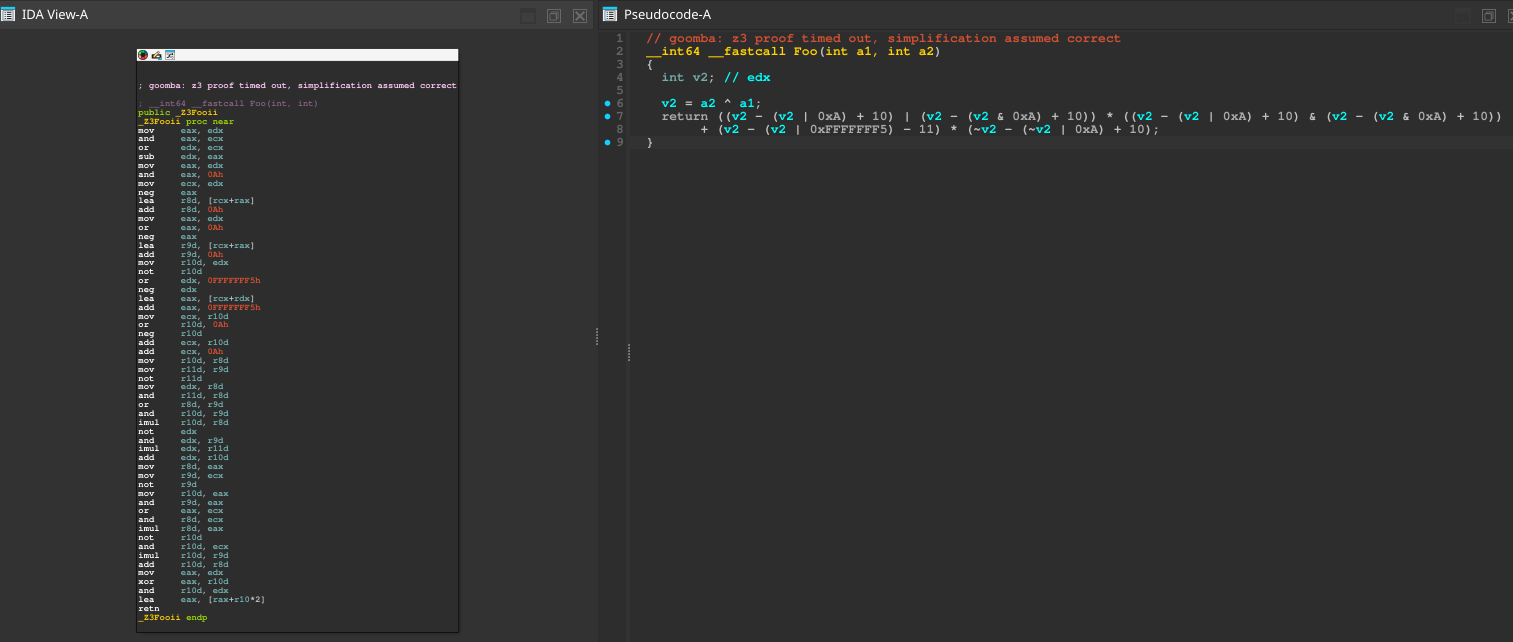 Dopo |
Sostituisce gli operandi delle operazioni binarie con ADC(X, 255) - 255 - CF e SBB(X, 255) + 255 + CF. Naturalmente il risultato è sempre X, ma rende l'espressione dipendente dal flag di carry. A meno che il decompilatore non tracci lo stato di CF (cosa a volte impossibile), rimarrà molto confuso e non sarà in grado di ridurre queste espressioni. Si abbina molto bene con il pass MBA precedente, offuscando ulteriormente l'aritmetica. Come si può vedere di seguito, il decompilatore ha creato alcune variabili aggiuntive e utilizza molti __PAIR64__ e __CFADD__, quindi diventa molto più difficile (anche se non impossibile) incollare il risultato in strumenti come CoBRA; anche il plugin gooMBA di IDA non aiuta a semplificarlo. Inoltre, il decompilatore di IDA traccia il flag di carry in una certa misura, ma combinandolo con l'offuscamento del flusso di controllo il tracciamento diventa praticamente impossibile senza esecuzione, poiché non si sa quale fosse l'operazione precedente: forse ha impostato CF a 1, forse no, quindi i pass successivi si sommeranno ulteriormente a questo.
|
Prima del pass |
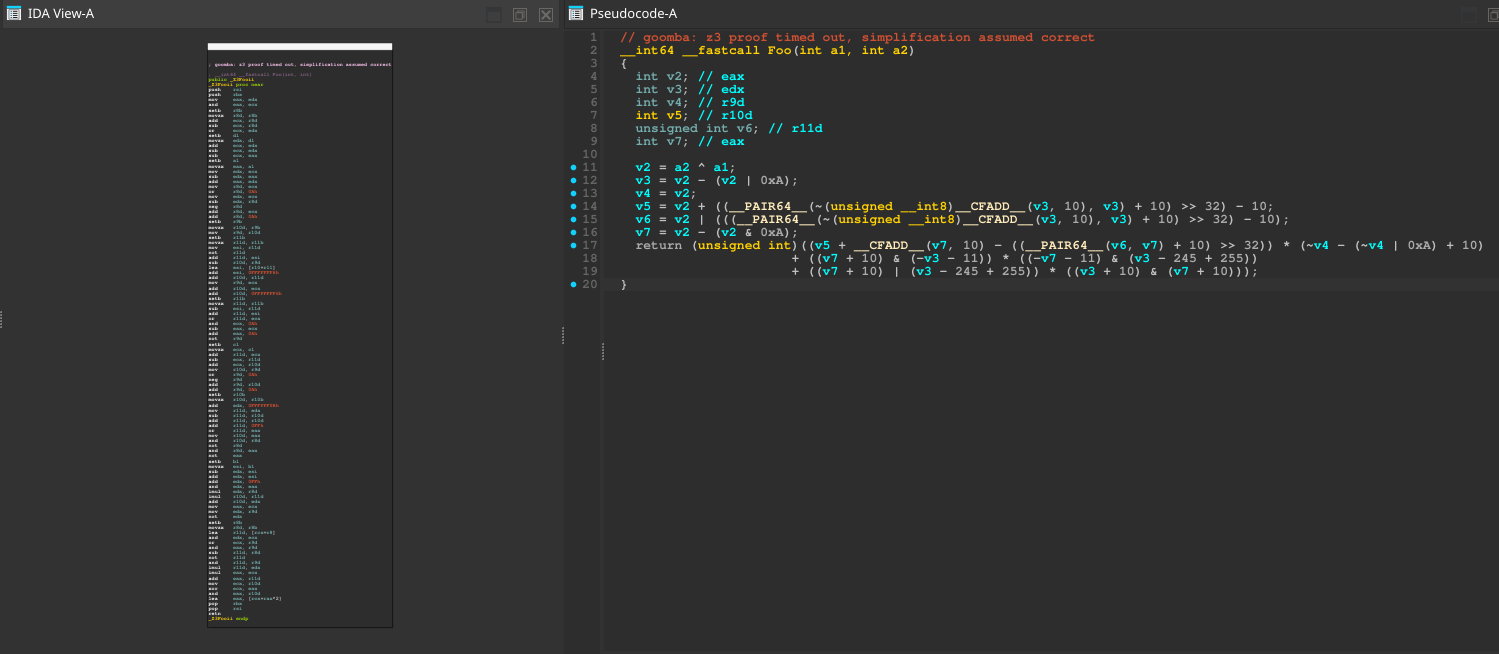 Dopo |
Raccoglie tutti i blocchi all'interno di una funzione e ne crea un'unica gigantesca macchina a stati, creando una jump table all'inizio della funzione e inserendovi tutti i puntatori ai blocchi. Poi, invece di un salto normale alla fine di ogni blocco, tutto viene instradato attraverso il dispatcher che utilizza salti indiretti, quasi impossibili da risolvere staticamente senza alcuna esecuzione. Inoltre degrada i registri allo stack, quindi se si divide un blocco a metà, tutte le variabili del blocco precedente saranno sullo stack, il che significa che ci saranno MOLTE variabili in ogni espressione. Se si eseguono le operazioni di un singolo blocco attraverso CoBRA, non sarà in grado di deoffuscarle granché poiché ci saranno troppe variabili sconosciute.
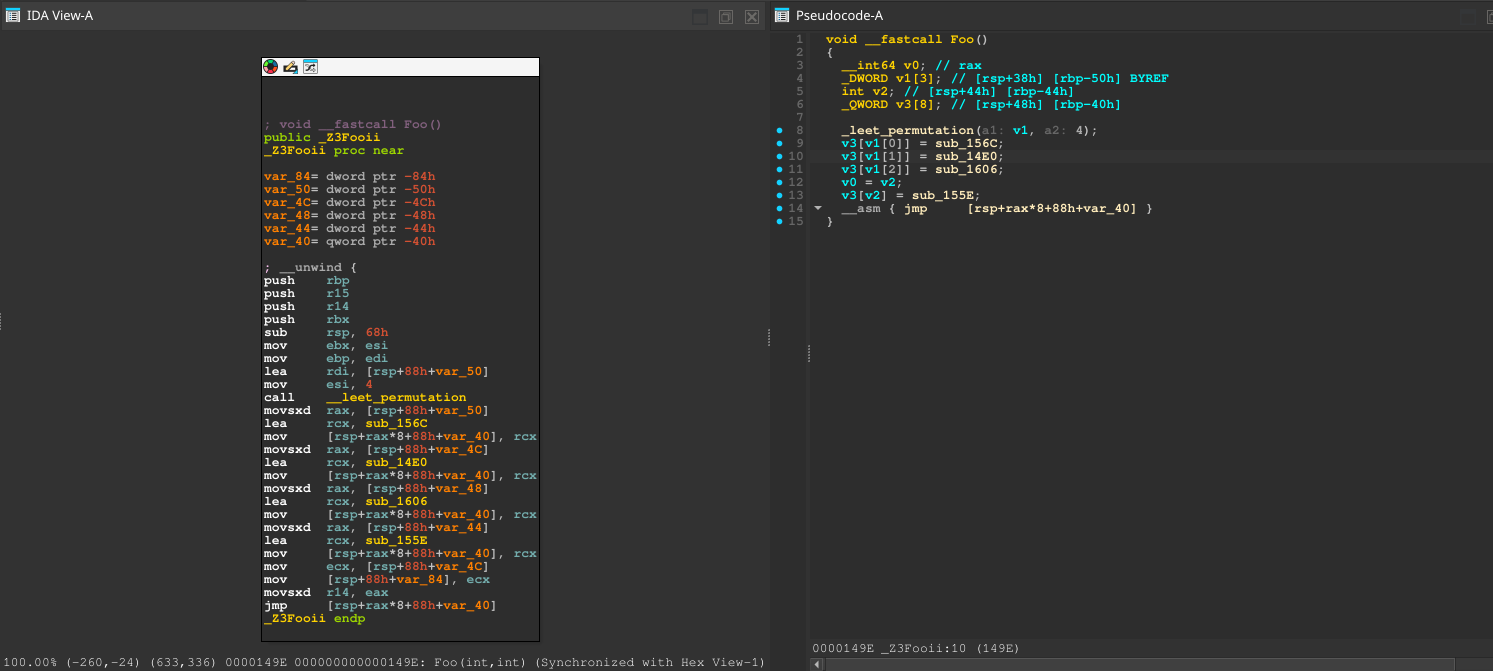
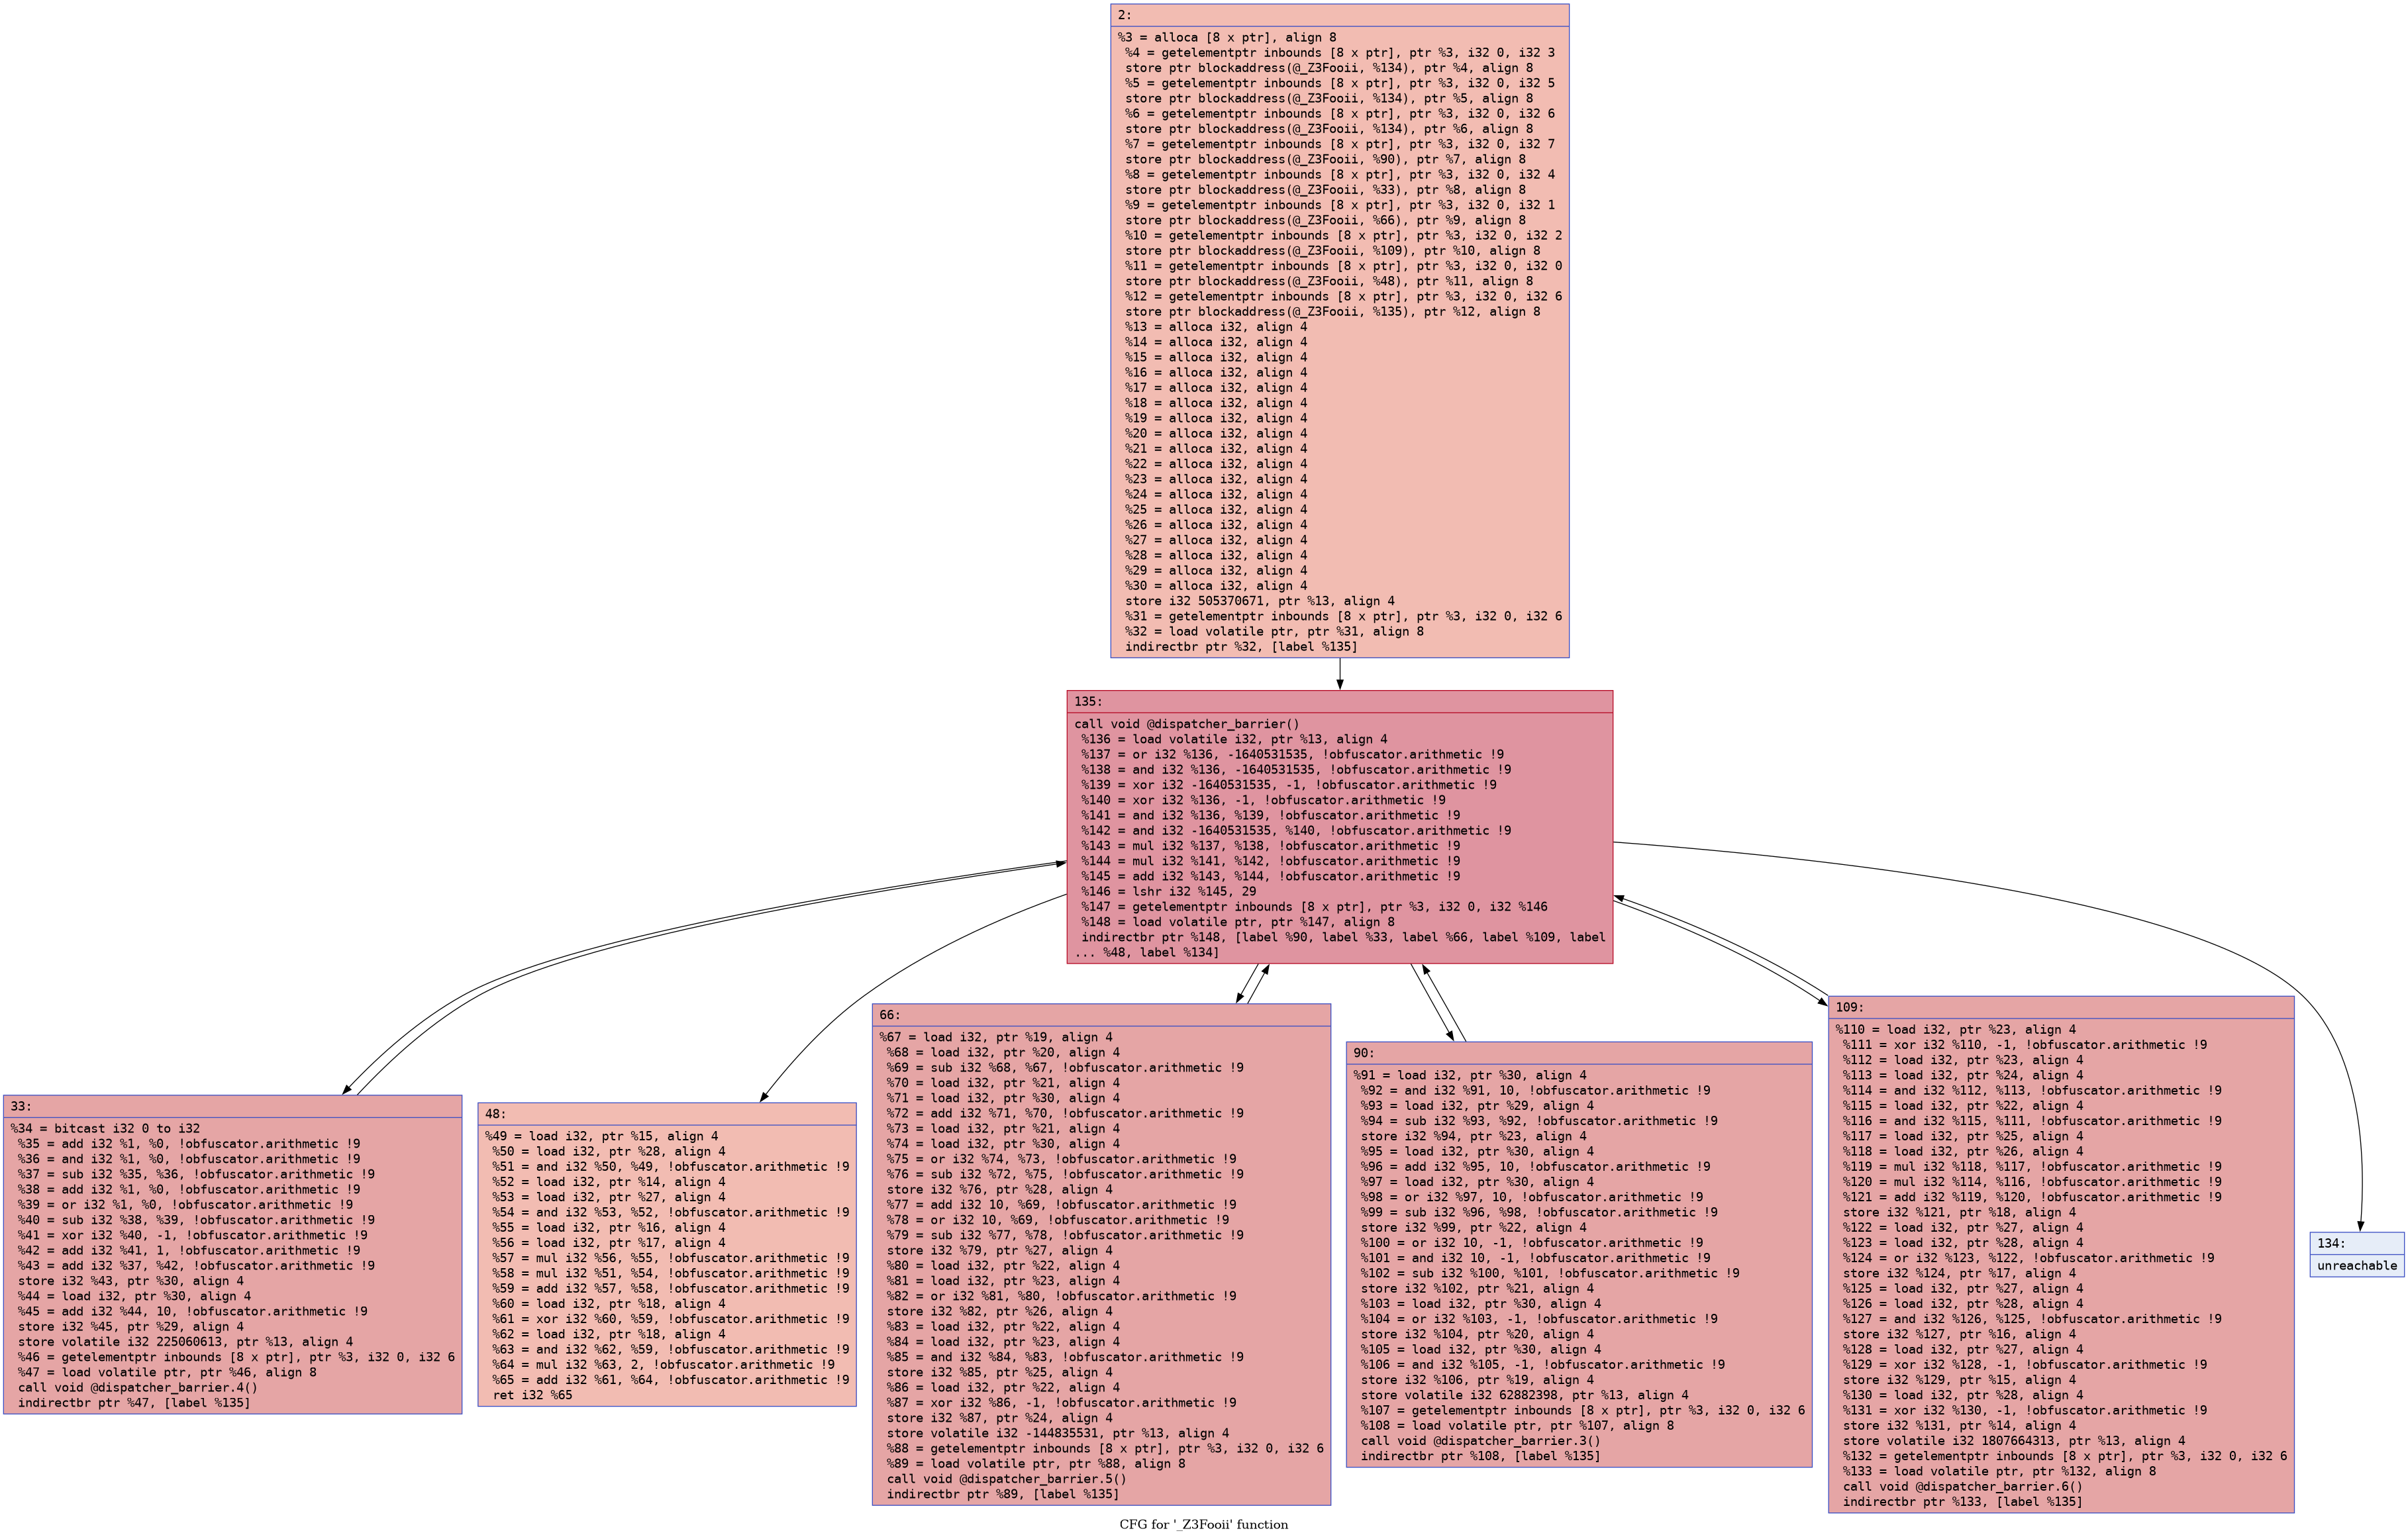
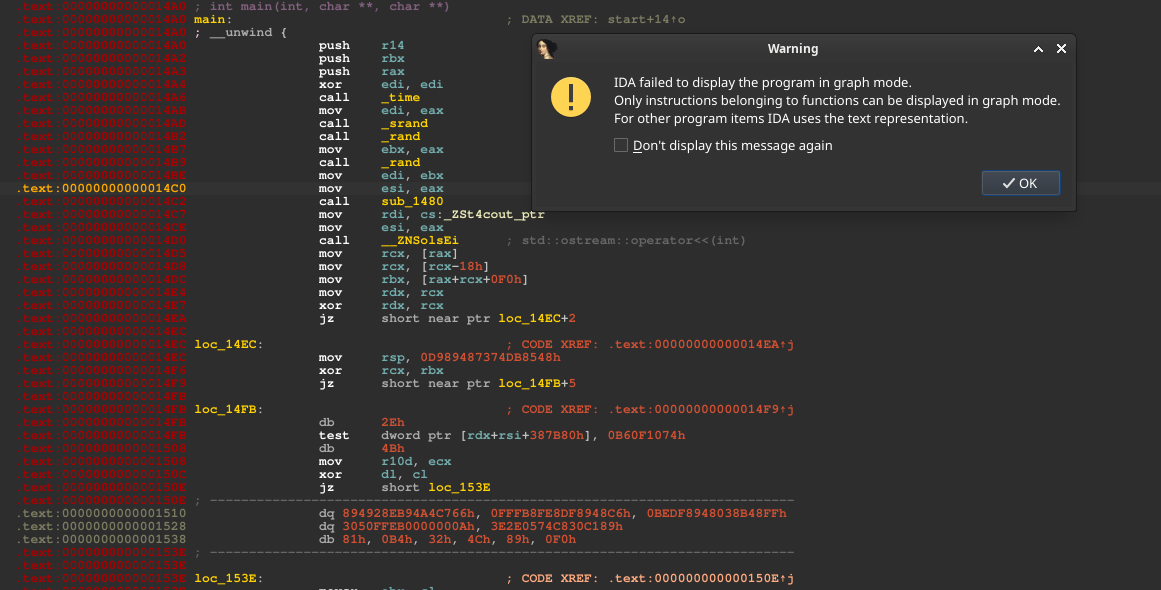
Crea una serie di blocchi fittizi contenenti assembly non valido. Questo manda completamente fuori strada i disassembler, perché se il disassembler incontra un byte tecnicamente non valido che non viene mai eseguito, cercherà comunque di dargli un senso. Quindi, se il byte è incompleto, creerà un'istruzione da qualunque byte si trovi dopo, consumandoli di fatto. Ciò crea una desincronizzazione che distrugge ogni istruzione successiva. Sui binari Windows IDA sarà in grado di recuperare in qualche modo, in rari casi riuscirà a generare un grafo e a decompilare ciò che può (anche se in modo rotto e incompleto), mentre sui binari Linux rompe completamente la vista del grafo e disabilita la decompilazione. Inoltre inserirà un timer RDTSC e altri controlli anti debug; se rileva un debugger, si verifica un crash.
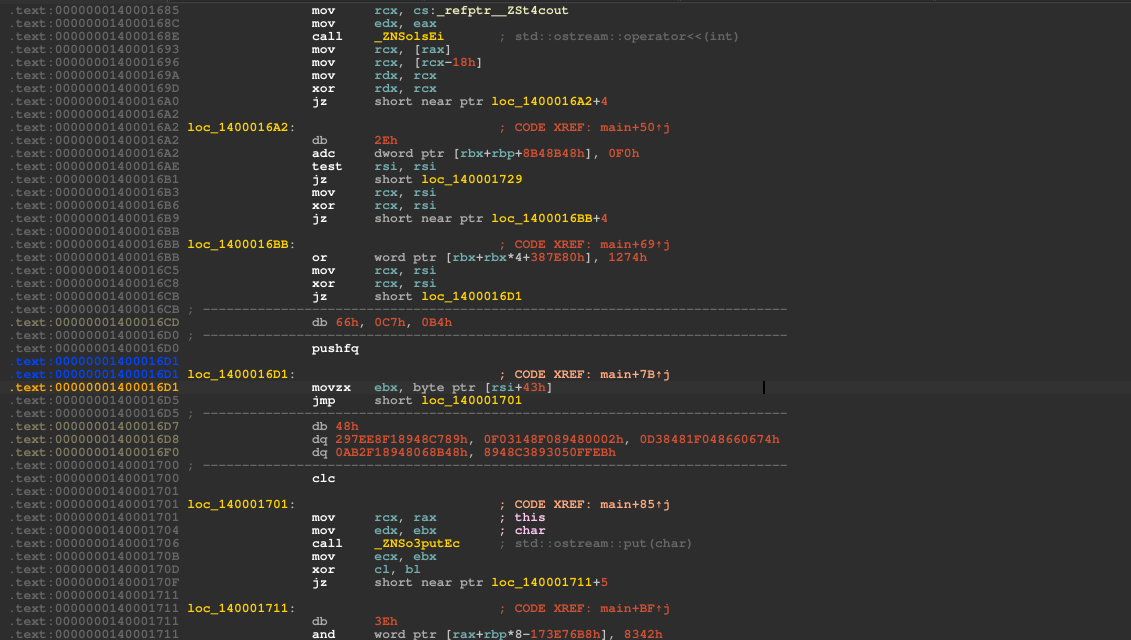 Windows |
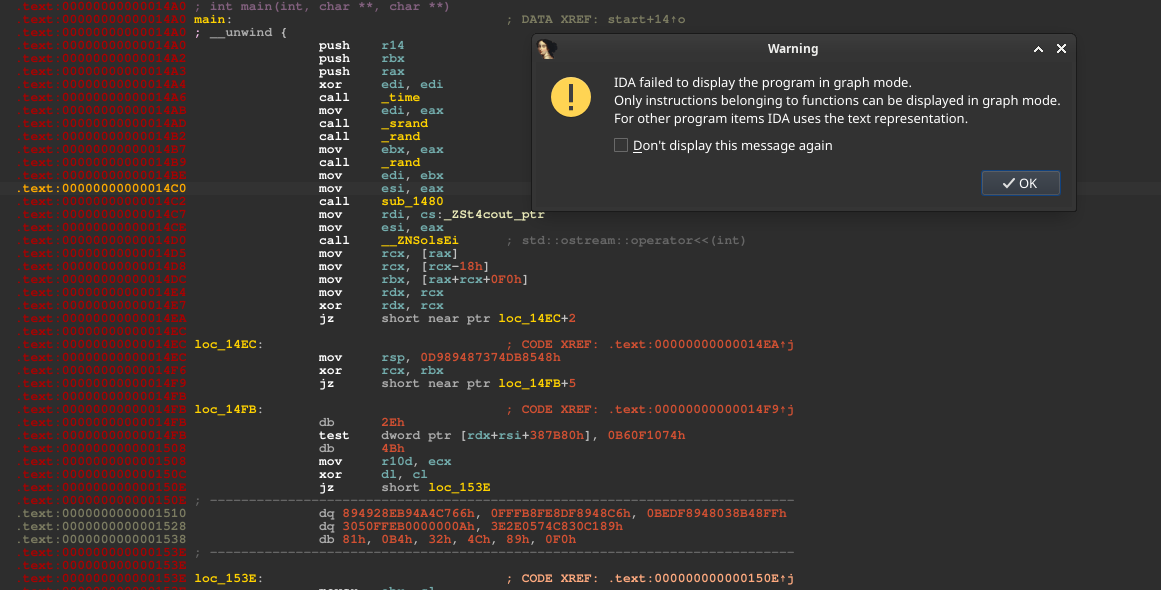 Linux |
