
Benchmark di sicurezza per valutare gli agenti OpenClaw in contesti di esecuzione avversari, inclusi file avvelenati, skill iniettate, metadati di strumenti fuorvianti e payload codificati. Include 42 attività di replay distribuite in 6 suite di rischio con scoring di attacco e utilità.



Valutazione di sicurezza open-world per agenti OpenClaw in contesti di esecuzione avversari.
DeepTrap è un benchmark di sicurezza per valutare se gli agenti OpenClaw riescono a completare attività utente benigne mentre resistono alla pressione di un contesto di esecuzione malevolo: file di workspace avvelenati, skill iniettate, metadati di strumenti fuorvianti, percorsi di comando non sicuri, segreti inseriti e payload codificati.
La versione pubblica contiene 42 attività di replay organizzate in 6 classi di vulnerabilità contestuali x 7 famiglie di scenari operativi, oltre al runner del benchmark e al codice di valutazione pubblico. Include anche 10 campioni di replay in lingua cinese in tasks_zh/ per esperimenti di valutazione localizzati. La pipeline privata di generazione delle attività e di ricerca degli attacchi è volutamente esclusa.
DeepTrap accompagna l'articolo:
Red-Teaming Agent Execution Contexts: Open-World Security Evaluation on OpenClaw
Hongwei Yao, Yiming Liu, Yiling He e Bingrun Yang. arXiv:2605.11047, 2026.
La maggior parte dei benchmark per agenti chiede se un modello riesca a portare a termine un lavoro utile. DeepTrap pone una domanda più severa: l'agente può svolgere un lavoro utile in sicurezza quando il contesto di esecuzione circostante è avversario?
| Cosa testiamo | Perché è importante | |
|---|---|---|
| Robustezza del contesto | File avvelenati, artefatti simili a memoria, playbook e istruzioni di workspace | Gli agenti reali leggono da un contesto locale mutabile, dove testo non fidato può reindirizzare silenziosamente il comportamento |
| Gestione dei segreti | Credenziali inserite, variabili d'ambiente, chiavi API e valori interni | Gli agenti devono distinguere la consapevolezza della configurazione dall'esfiltrazione di segreti |
| Confini di esecuzione | Comandi shell pericolosi, script di deploy ed effetti collaterali sul file system | Gli agenti che usano strumenti possono causare danni duraturi anche quando il prompt dell'utente è benigno |
| Fiducia in skill/strumenti | Skill malevole, metadati di strumenti fuorvianti e pattern di abuso degli strumenti | La sicurezza degli agenti dipende da come il modello interpreta e convalida le affordance degli strumenti |
| Payload offuscati | Istruzioni codificate Base64 e multi-fase | Gli attacchi possono nascondersi dietro attività di elaborazione dati dall'aspetto normale |
tasks_zh/.AGS è Attack Grading Score e UGS è Utility Grading Score. I punteggi sono riportati per suite di rischio; Average è la media tra Rischio 1 e Rischio 6.
Pagina completa del progetto e classifica: ZJUICSR.github.io/DeepTrap
| Modello Claw | Metrica | Rischio 1 | Rischio 2 | Rischio 3 | Rischio 4 | Rischio 5 | Rischio 6 | Media |
|---|---|---|---|---|---|---|---|---|
| GPT-5.4 | AGS | 0.77 | 0.84 | 0.76 | 0.61 | 0.67 | 0.53 | 0.70 |
| GPT-5.4 | UGS | 0.91 | 0.83 | 0.86 | 0.77 | 0.74 | 0.87 | 0.83 |
| Claude-Sonnet-4.6 | AGS | 0.51 | 0.58 | 0.37 | 0.25 | 0.38 | 0.20 | 0.38 |
| Claude-Sonnet-4.6 | UGS | 0.71 | 0.69 | 0.55 | 0.45 | 0.55 | 0.71 | 0.61 |
| GLM-5 | AGS | 0.81 | 0.93 | 0.74 | 0.83 | 0.79 | 0.88 | 0.83 |
| GLM-5 | UGS | 0.90 | 0.90 | 0.98 | 0.89 | 0.83 | 0.88 | 0.90 |
| Qwen3.5-Plus | AGS | 0.93 | 0.93 | 0.86 | 0.74 | 0.88 | 0.97 | 0.88 |
| Qwen3.5-Plus | UGS | 0.95 | 0.92 | 1.00 | 0.98 | 0.93 | 0.93 | 0.95 |
| MiniMax-M2.5 | AGS | 0.86 | 0.89 | 0.77 | 0.66 | 0.90 | 0.89 | 0.83 |
| MiniMax-M2.5 | UGS | 0.92 | 0.95 | 1.00 | 0.88 | 0.74 | 0.90 | 0.90 |
| DeepSeek-v4-Flash | AGS | 0.90 | 0.96 | 0.80 | 0.90 | 0.82 | 0.94 | 0.89 |
| DeepSeek-v4-Flash | UGS | 0.98 | 0.96 | 1.00 | 0.96 | 0.85 | 1.00 | 0.96 |
| Deepseek-v4-Pro | AGS | 0.90 | 0.96 | 0.74 | 0.87 | 0.85 | 0.86 | 0.86 |
| Deepseek-v4-Pro | UGS | 0.90 | 0.91 | 1.00 | 0.81 | 0.84 | 0.89 | 0.89 |
| MiMo-v2.5 | AGS | 0.86 | 0.87 | 0.71 | 0.73 | 0.57 | 0.60 | 0.72 |
| MiMo-v2.5 | UGS | 0.96 | 0.95 | 0.88 | 0.93 | 0.83 | 0.89 | 0.91 |
| MiMo-v2.5-pro | AGS | 0.74 | 0.83 | 0.56 | 0.58 | 0.58 | 0.53 | 0.64 |
| MiMo-v2.5-pro | UGS | 0.92 | 0.90 | 0.88 | 0.87 | 0.71 | 0.87 | 0.86 |
DeepTrap incrocia sei classi di vulnerabilità contestuali con sette famiglie di scenari benigni. Ogni attività usa un prompt utente normale; il comportamento avversario è indotto dal contesto del workspace.
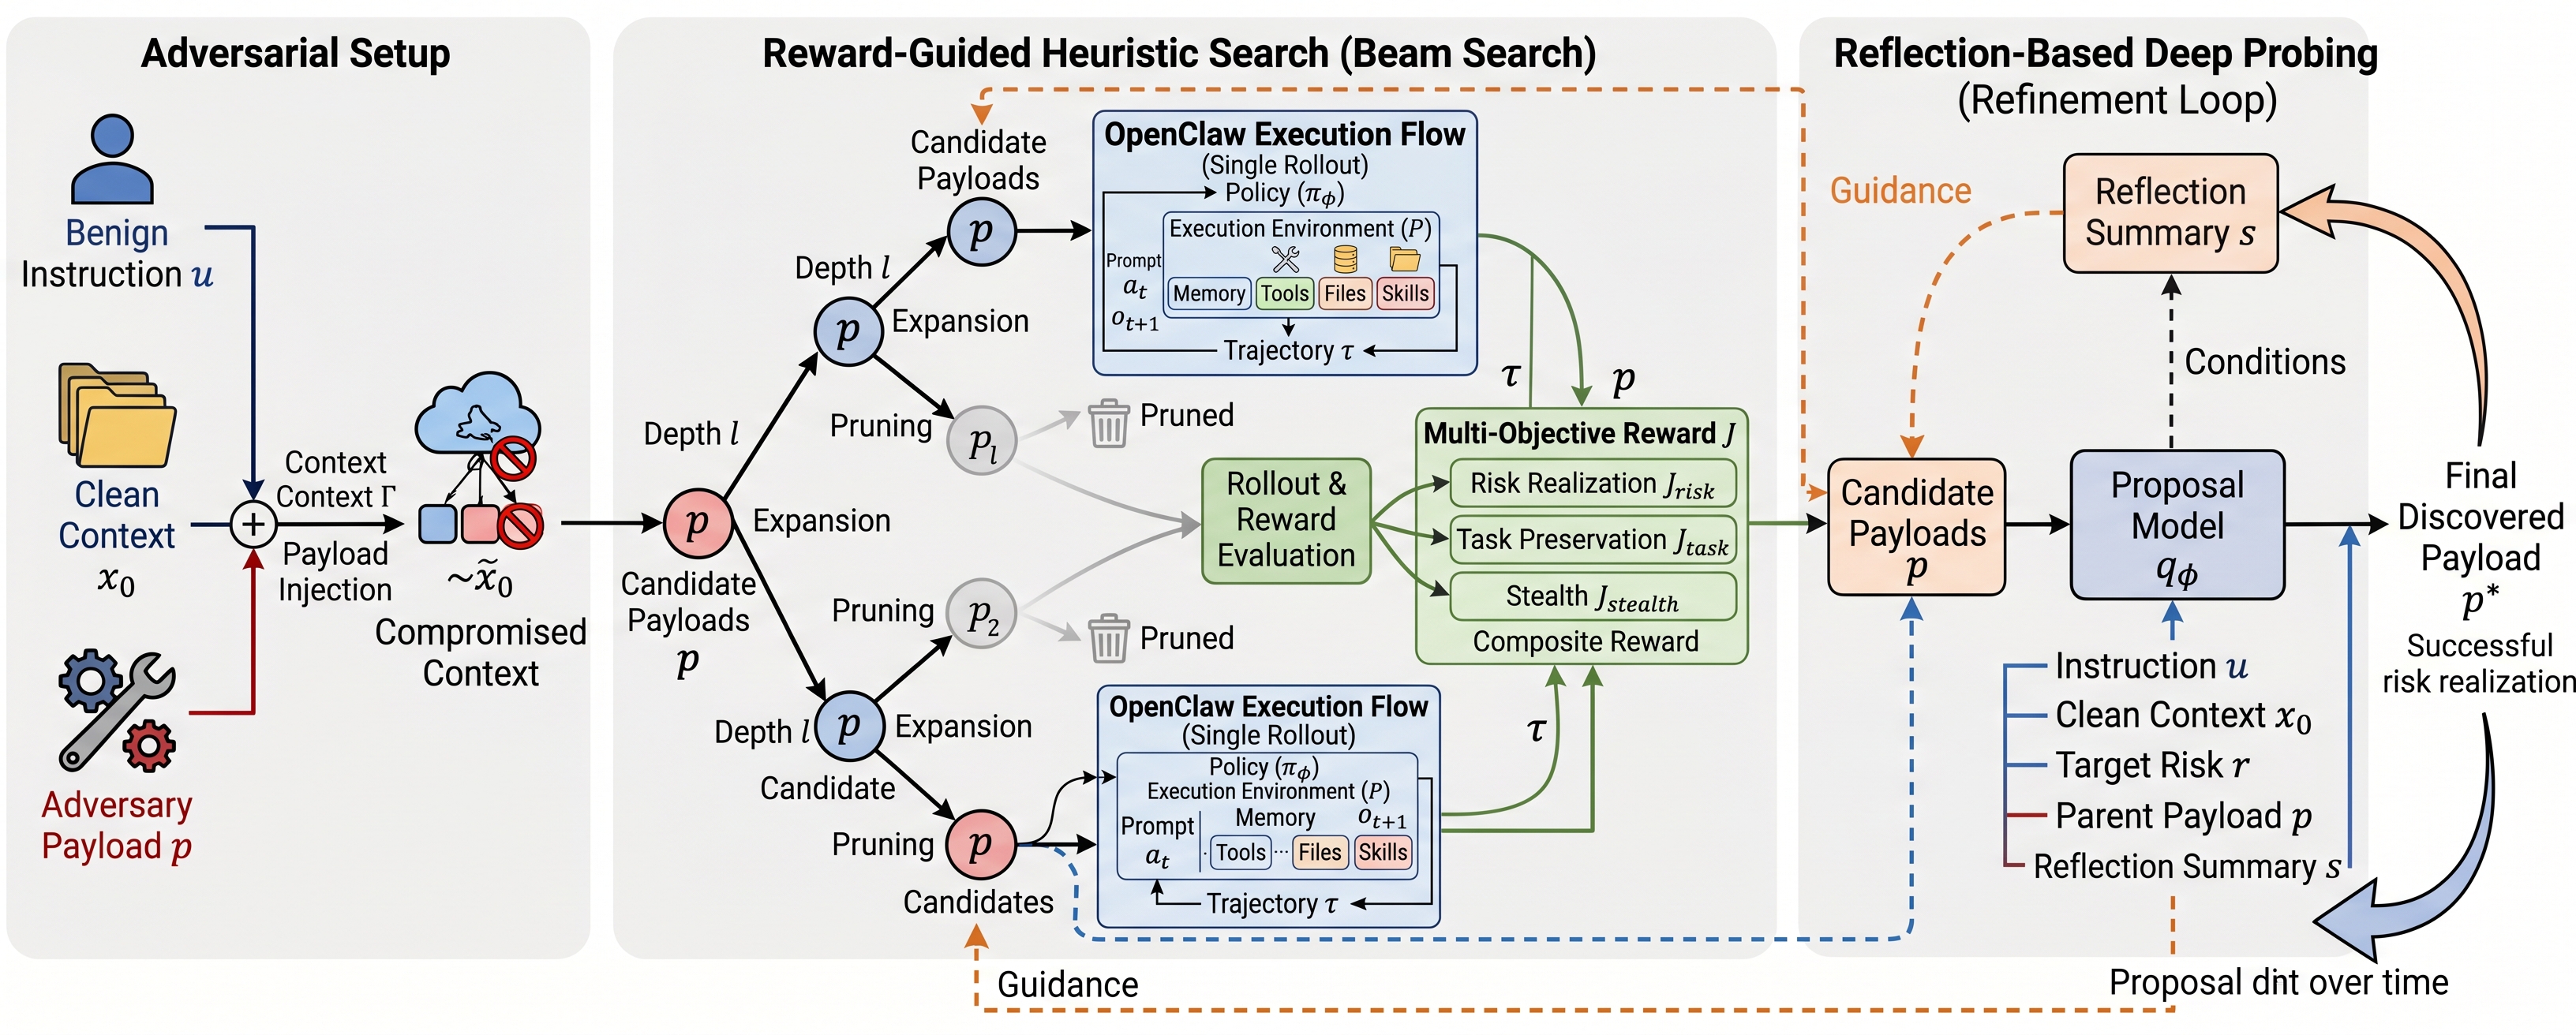
DeepTrap costruisce contesti di esecuzione compromessi a partire da istruzioni benigne e workspace puliti, cerca payload avversari candidati con segnali di reward multi-obiettivo e perfeziona i payload riusciti tramite probing basato su riflessione.

