
 zju-llm-safety/ascent
Framework di fine-tuning che applica una calibrazione di sicurezza ottimale del primo ordine e una ricalibrazione periodica ai LLM, preservando gli aggiornamenti compatibili con la sicurezza e migliorando al contempo l'utilità per le attività downstream.

Fine-Tuning Ottimale del Primo Ordine con Ricalibrazione per il Miglioramento Congiunto di Sicurezza e Utilità
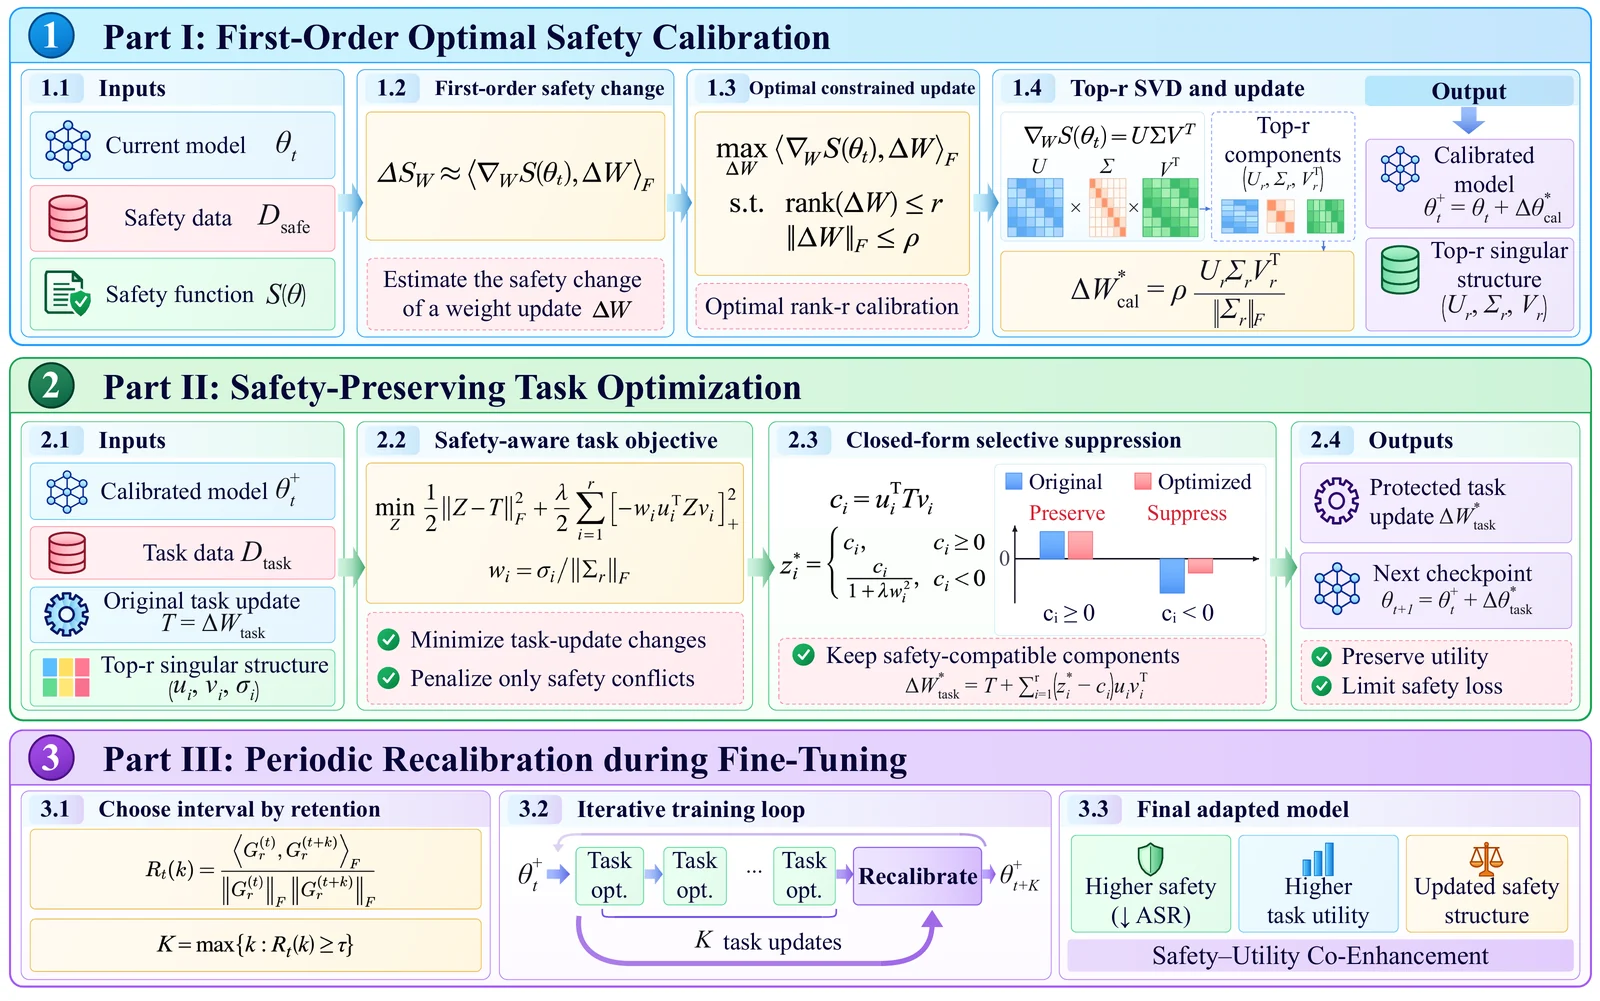
ASCENT deriva un aggiornamento di calibrazione della sicurezza ottimale del primo ordine e la corrispondente struttura relativa alla sicurezza, ottimizza gli aggiornamenti dei task downstream per preservare le componenti compatibili con la sicurezza sopprimendo quelle che la degradano, e ricalibra periodicamente questa struttura durante il fine-tuning per migliorare congiuntamente sicurezza e utilità downstream.
Metodo · Avvio rapido · Dati · Configurazione · Valutazione
config.toml.Requisiti: Python 3.12 e checkpoint dei modelli locali. L'addestramento utilizza due GPU CUDA, una per il modello target e una per Llama Guard; ciascun modello deve entrare nella propria GPU.
pip install -r requirements.txt
cp config.example.toml config.toml
Compila i valori vuoti in config.toml, seguendo i suoi commenti inline, poi esegui:
python run.py \
  --config config.toml \
  --model-path /path/to/target-model \
  --guard-model-path /path/to/Llama-Guard-3-8B \
  --data-root data \
  --output-dir /path/to/new-run \
  --target-gpu 0 --guard-gpu 1
Aggiungi
--executeper addestrare, generare risposte o salvare i risultati di valutazione.
Scegli una nuova directory di output esterna al repository con spazio per i checkpoint. L'addestramento stampa il percorso del modello finale unito al termine.
Fornisci array JSON con i conteggi di record configurati:
<data-root>/calibration/prompts.json<data-root>/<task>/{train,test}.json, con input di train/test disgiunti.| Dataset | Campi richiesti |
|---|---|
| SAMSum | dialogue, summary |
| AGNews | text, label_name: World, Sports, Business, o Sci/Tech |
| GSM8K | question, answer con una risposta finale #### |
| OpenBookQA | question_stem, choice_labels: ["A","B","C","D"], quattro choice_texts, answer_key: A–D |
| HarmBench | solo goal; id, source opzionali; nessuna risposta memorizzata |
Imposta modello, task e iperparametri in config.toml. Il caricamento del modello
e la selezione della matrice seguono model.key.
Usa evaluate.py per entrambe le modalità; la generazione richiede un modello locale
completamente unito. Fornisci i tuoi dati e i punteggi di sicurezza esterni. Nessun
dataset, giudice online o configurazione API è incluso.
python evaluate.py utility --task gsm8k --data /path/to/test.json \
  --model-path /path/to/merged-model --output-dir /path/to/task-evaluation --execute
Task: samsum, agnews, gsm8k, openbookqa. Le metriche sono ROUGE-L per SAMSum
e accuratezza/exact match per gli altri, riportate come percentuali. Per valutare le
risposte salvate, sostituisci --model-path con --responses /path/to/responses.json.
Fornisci prompt fissi come record con id, goal e prompt opzionale (predefinito
a goal). Mantieni l'obiettivo dannoso originale separato dal prompt di attacco.
Genera le risposte:
python evaluate.py safety --data /path/to/prompts.json \
  --model-path /path/to/merged-model --output-dir /path/to/safety-responses --execute
Aggrega i punteggi esterni:
python evaluate.py safety \
  --responses /path/to/safety-responses/responses.json --judgments /path/to/scores.json \
  --output-dir /path/to/safety-metrics --execute
I punteggi sono record JSON { "id": "...", "score": 1 }, usando gli ID delle risposte
e punteggi 1–5 (null per giudizi falliti). I punteggi 4–5 contano come attacchi
riusciti; usa --success-threshold 5 per
contare solo 5. Giudizi mancanti o falliti non producono un ASR finale.
Per entrambe le modalità, gli input che superano --max-input-tokens dopo la
formattazione della chat vengono rifiutati, non troncati. Imposta il limite entro la
capacità di contesto del modello, lasciando spazio per i token generati.






