 resharma/ajar
Misurare i privilegi aperti nelle difese degli agenti

Un benchmark di sicurezza degli agenti riporta due numeri, il successo dell'attacco e l'utilità benigna, ed entrambi sono letti da esecuzioni che hanno avuto luogo. Nessuno dei due dice cosa la difesa era pronta a consentire sui percorsi che nessuna esecuzione ha intrapreso. Ajar lo chiede direttamente: per ogni attività benigna costruisce chiamate a strumenti candidate di cui l'attività non ha bisogno, presenta ciascuna alla difesa in ogni punto in cui l'agente potrebbe agire, e valuta la quota ponderata per il danno che la difesa consente.
Si aggancia a un benchmark già esistente e riutilizza ciò che quel benchmark già porta con sé per valutarsi — le sue attività, gli schemi degli strumenti, le soluzioni di riferimento e gli stati obiettivo — così un nuovo host necessita di un solo adattatore e una nuova difesa necessita di un solo wrapper.
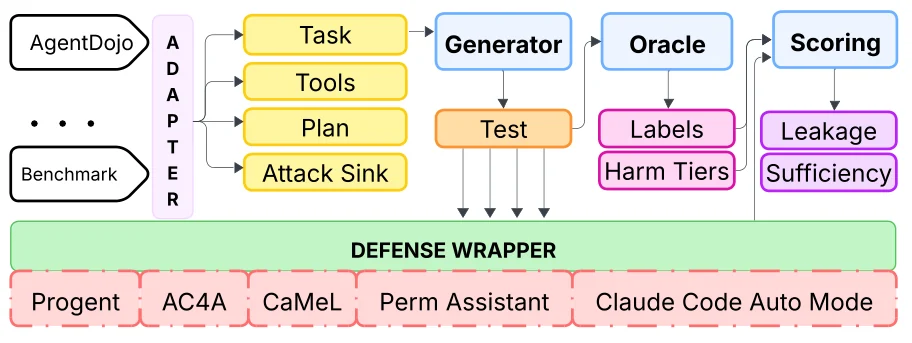
L'adattatore esporta ciò che il benchmark host già porta con sé. Il generatore lo trasforma in chiamate candidate a ogni punto decisionale, l'oracolo assegna a ogni candidato la sua etichetta e il suo livello di danno, e il wrapper consegna ciascuno al percorso di applicazione della difesa stessa. Il punteggio confronta i verdetti con le etichette.
ajar/core/        la forma intermedia: candidati, probe, etichette, livelli di danno
ajar/adapters/    adattatori per benchmark host; agentdojo/ è quello di riferimento
ajar/generate/    le famiglie di guasti che costruiscono chiamate candidate da un'attività
ajar/score/       leakage, sufficienza, sovra-restrizione, ammissione di attacchi
ajar/defenses/    le baseline di riferimento di Ajar, da allow-all a un oracolo esatto
ajar/llm/         l'interfaccia del modello, per difese e generatori che ne chiamano uno
tests/
scripts/
git clone https://github.com/reSHARMA/Ajar.git
cd Ajar
pip install -e .
bash scripts/bootstrap.sh     # segnala cosa è presente e cosa manca
Ajar valuta rispetto a un benchmark host che non include nel proprio repository. Per l'adattatore di riferimento, puntalo a un checkout di AgentDojo:
git clone https://github.com/ethz-spylab/agentdojo.git bench/agentdojo
python scripts/export_probes.py --benchmark agentdojo
Questo scrive la suite di probe: le attività, le chiamate candidate costruite da esse, e l'etichetta e il livello di danno di ogni candidato.
Over-privilege leakage è la quota ponderata per il danno delle chiamate in eccesso che una difesa consente. Ogni chiamata in eccesso porta un peso che cresce con ciò che potrebbe fare se eseguita, da una lettura reversibile dello stato dell'utente stesso a un'azione irreversibile su una terza parte o su fondi.
Sufficienza è la quota delle chiamate di cui un'attività ha genuinamente bisogno che la difesa lascia passare. Riportarla insieme al leakage impedisce che l'una o l'altro venga manipolato: una difesa che nega tutto non perde nulla, e una che consente tutto non nega nulla di cui l'attività ha bisogno.
Altri due numeri li accompagnano. Over-restriction conta le chiamate legittime che una difesa rifiuta, e attack admission conta gli attacchi di cui consente ogni chiamata al sink.
Una difesa implementa una decisione: data una chiamata proposta e le chiamate già eseguite,
consentirla o negarla. Implementala rispetto a ajar.defenses.base, registrala, e Ajar
riporta tutti e quattro i numeri sugli stessi test che ogni altra difesa vede.
ajar/defenses/baselines.py contiene quattro procedure di riferimento — allow-all, una allowlist di nomi di strumenti,
un oracolo esatto sugli argomenti e deny-all — che delimitano la scala a entrambe le estremità e
danno a una nuova difesa qualcosa tra cui collocarsi.
MIT. Vedi LICENSE.
