 pvharmo2/gha-lab-e8902eccd3
Laboratorio di ricerca sulla sicurezza: riproduzione di CVE-2025-52467 (esecuzione di codice nel workflow pull_request_target di pgai / esfiltrazione di GITHUB_TOKEN) — snapshot di timescale/pgai

Artefatto di ricerca automatizzato — non è il progetto upstream.
Questo repository è un laboratorio monouso costruito da un sistema automatizzato per una tesi magistrale presso l'Université Laval sulla riproduzione di vulnerabilità pubblicate nei workflow di GitHub Actions. È uno snapshot integrale di
timescale/pgaial commit2a209b058c60823b57e8b7775b10244ff340eb8b(2025-05-14), ridistribuito sotto la licenza del progetto stesso, il cui file è incluso invariato in questo snapshot.Il progetto upstream non è coinvolto, non è mai preso di mira, e la vulnerabilità studiata qui è già pubblica. Ogni segreto e variabile in questo repository è un valore fittizio generato casualmente — nessuna credenziale reale è presente. I riferimenti alle action e le immagini dei runner sono bloccati a ciò a cui risolvevano il 2025-05-14; consulta
pinning.mdnell'output del sistema per ogni modifica apportata allo snapshot.Domande o obiezioni: [email protected]
Una libreria Python che trasforma PostgreSQL in un robusto motore di retrieval pronto per la produzione, per applicazioni RAG e Agentic.
🔄 Crea e sincronizza automaticamente gli embedding vettoriali dai dati PostgreSQL e dai documenti S3. Gli embedding si aggiornano automaticamente al variare dei dati.
🔍 Potente ricerca vettoriale e semantica con pgvector e pgvectorscale.
🛡️ Pronto per la produzione fin da subito: supporta l'elaborazione batch per una generazione efficiente degli embedding, con gestione integrata di errori del modello, limiti di frequenza e picchi di latenza.
🐘 Funziona con qualsiasi database PostgreSQL, inclusi Timescale Cloud, Amazon RDS, Supabase e altri.
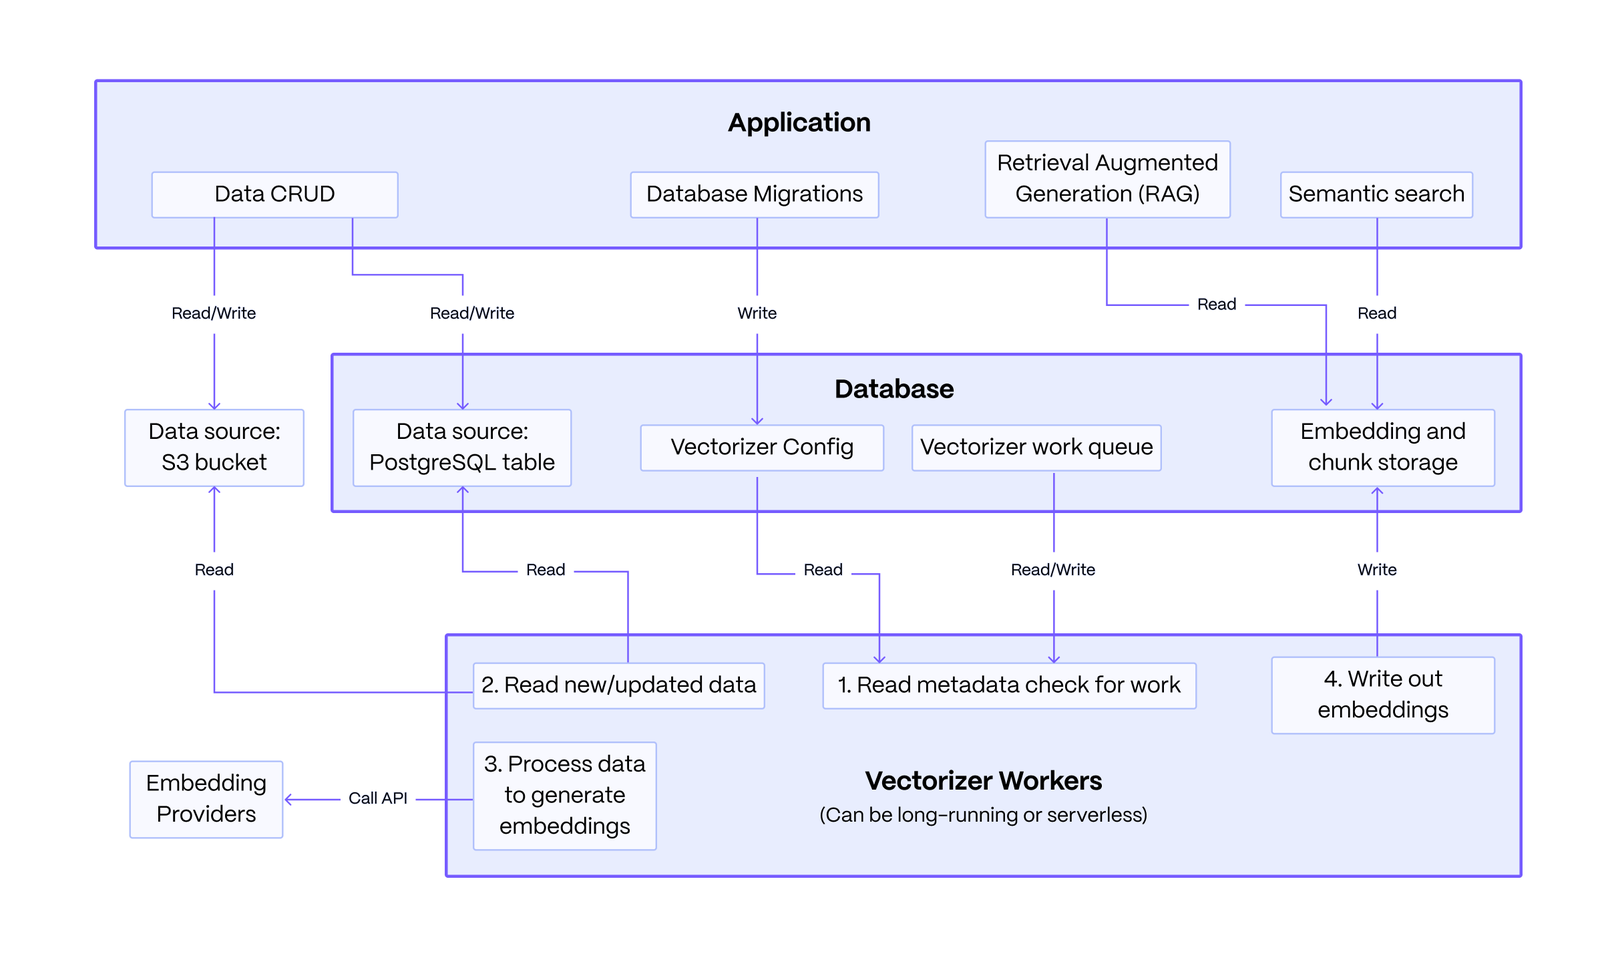
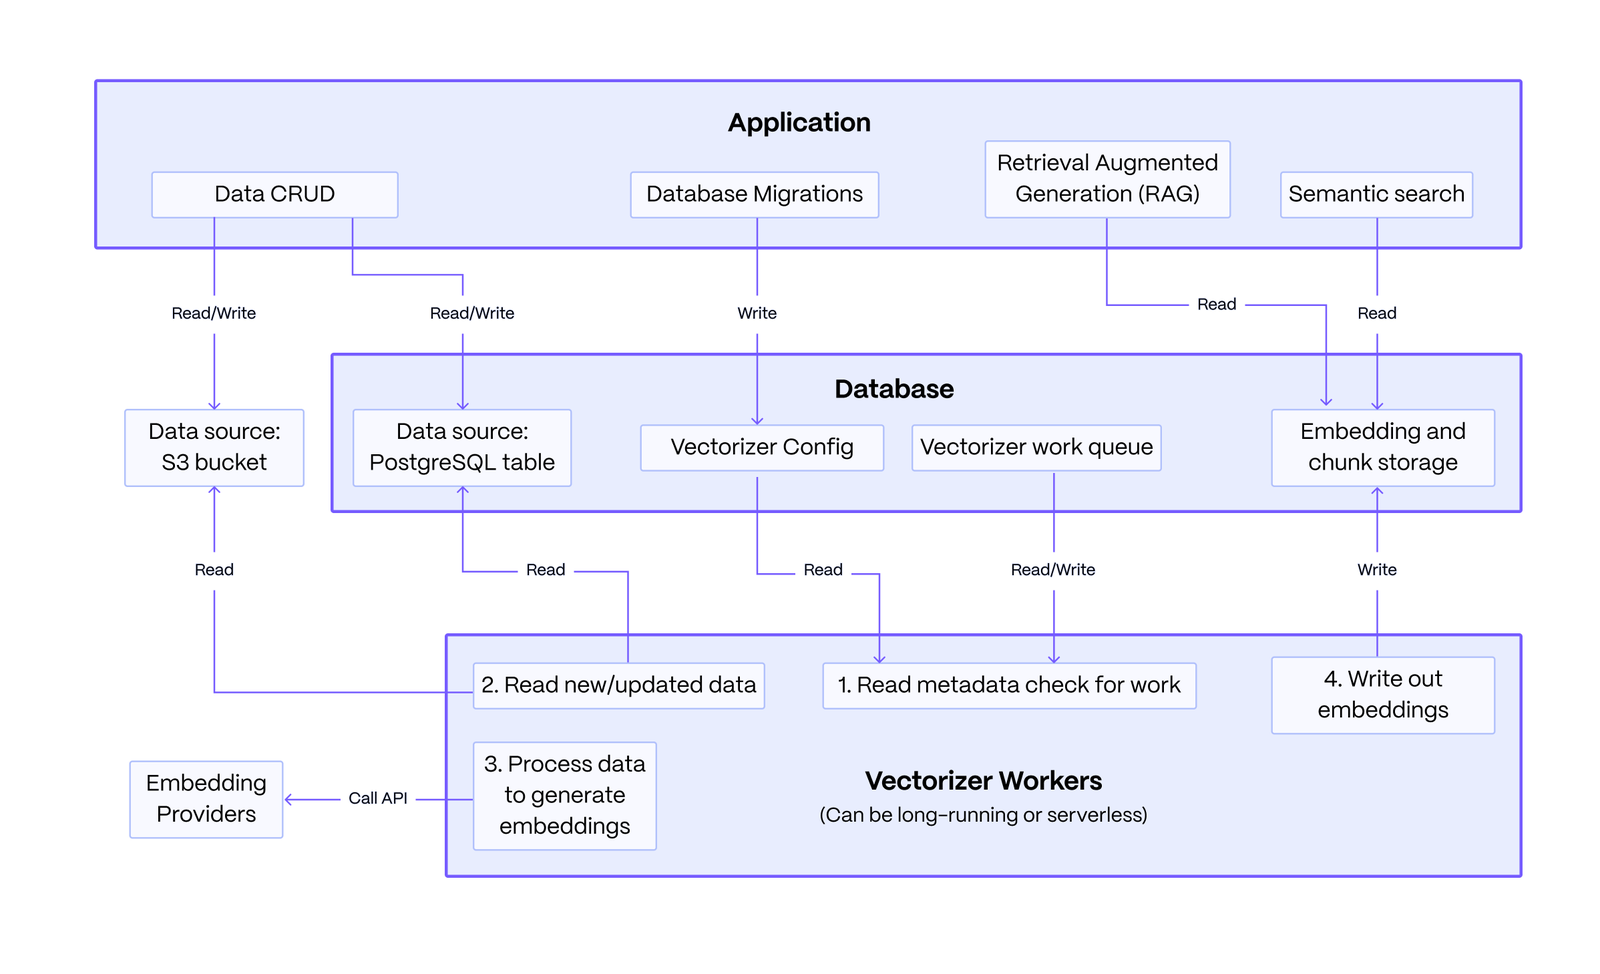
Architettura di base: Il sistema è composto da un'applicazione che scrivi tu, un database PostgreSQL e worker vectorizer senza stato. L'applicazione definisce una configurazione del vectorizer per incorporare dati da fonti come PostgreSQL o S3. I worker leggono questa configurazione, elaborano la coda di dati trasformandoli in embedding e testo a chunk, e riscrivono i risultati. L'applicazione interroga quindi questi dati per alimentare RAG e la ricerca semantica.
Il punto di forza di questa architettura risiede nella sua resilienza: le modifiche ai dati apportate dall'applicazione sono disaccoppiate dal processo di embedding, garantendo che i guasti nel servizio di embedding non influiscano sulle operazioni dati principali.
Per prima cosa, installa il pacchetto pgai.``` pip install pgai
Quindi, installa i componenti del database pgai. Puoi farlo dal terminale utilizzando la CLI oppure nel codice della tua applicazione Python utilizzando il pacchetto Python pgai.```
# from the cli
pgai install -d <database-url>

# or from the python package, often done as part of your application setup
import pgai
pgai.install(DB_URL)
Questa guida rapida dimostra come pgai Vectorizer abiliti la ricerca semantica e il RAG sui dati PostgreSQL creando e sincronizzando automaticamente gli embedding man mano che i dati cambiano.
Il "segreto" fondamentale di pgai Vectorizer è il suo approccio dichiarativo alla generazione degli embedding. Definisci semplicemente la tua pipeline e lascia che Vectorizer gestisca la complessità operativa di mantenere sincronizzati gli embedding, anche quando gli endpoint di embedding non sono affidabili. Puoi definire una versione semplice della pipeline come segue:```sql CREATE TABLE IF NOT EXISTS wiki ( id INTEGER PRIMARY KEY GENERATED ALWAYS AS IDENTITY, url TEXT NOT NULL, title TEXT NOT NULL, text TEXT NOT NULL )
SELECT ai.create_vectorizer( 'wiki'::regclass, loading => ai.loading_column(column_name=>'text'), destination => ai.destination_table(target_table=>'wiki_embedding_storage'), embedding => ai.embedding_openai(model=>'text-embedding-ada-002', dimensions=>'1536') )
Il vectorizer creerà automaticamente gli embedding per tutte le righe nella
tabella `wiki` e, cosa ancora più importante, manterrà gli embedding sincronizzati con
i dati sottostanti man mano che cambiano. **Pensalo quasi come se dichiarassi un indice** sulla
tabella `wiki`, ma invece di essere il database a gestire la struttura dati dell'indice
per te, è il Vectorizer a gestire gli embedding.

## Esecuzione della guida rapida

**Prerequisiti:**
- Un database PostgreSQL ([istruzioni per Docker](https://docs.timescale.com/self-hosted/latest/install/installation-docker/)).
- Una chiave API OpenAI (nella guida rapida usiamo openai per gli embedding, ma puoi usare [più provider](#modelli-di-embedding-supportati)).

Crea un file `.env` con il seguente contenuto:```
OPENAI_API_KEY=<your-openai-api-key>
DB_URL=<your-database-url>
Puoi scaricare il codice Python completo e il requirements.txt dall'esempio di avvio rapido ed eseguirli nella stessa directory del file .env.
