 praetorian-inc/noseyparker
Nosey Parker è uno strumento a riga di comando che trova segreti e informazioni sensibili nei dati testuali e nella cronologia di Git.

Vedi il nostro annuncio https://www.praetorian.com/blog/titus-open-source-secret-scanner/. Il repository Titus si trova su https://github.com/praetorian-inc/titus
Nosey Parker è uno strumento CLI che trova segreti e informazioni sensibili in dati testuali.
È essenzialmente uno strumento specializzato tipo grep per il rilevamento di segreti.
È stato progettato per la sicurezza offensiva (ad esempio, consentendo il movimento laterale nei red team), ma può essere utile anche per test di sicurezza difensiva. Ha trovato segreti in centinaia di engagement di sicurezza offensiva presso Praetorian.
Caratteristiche principali:
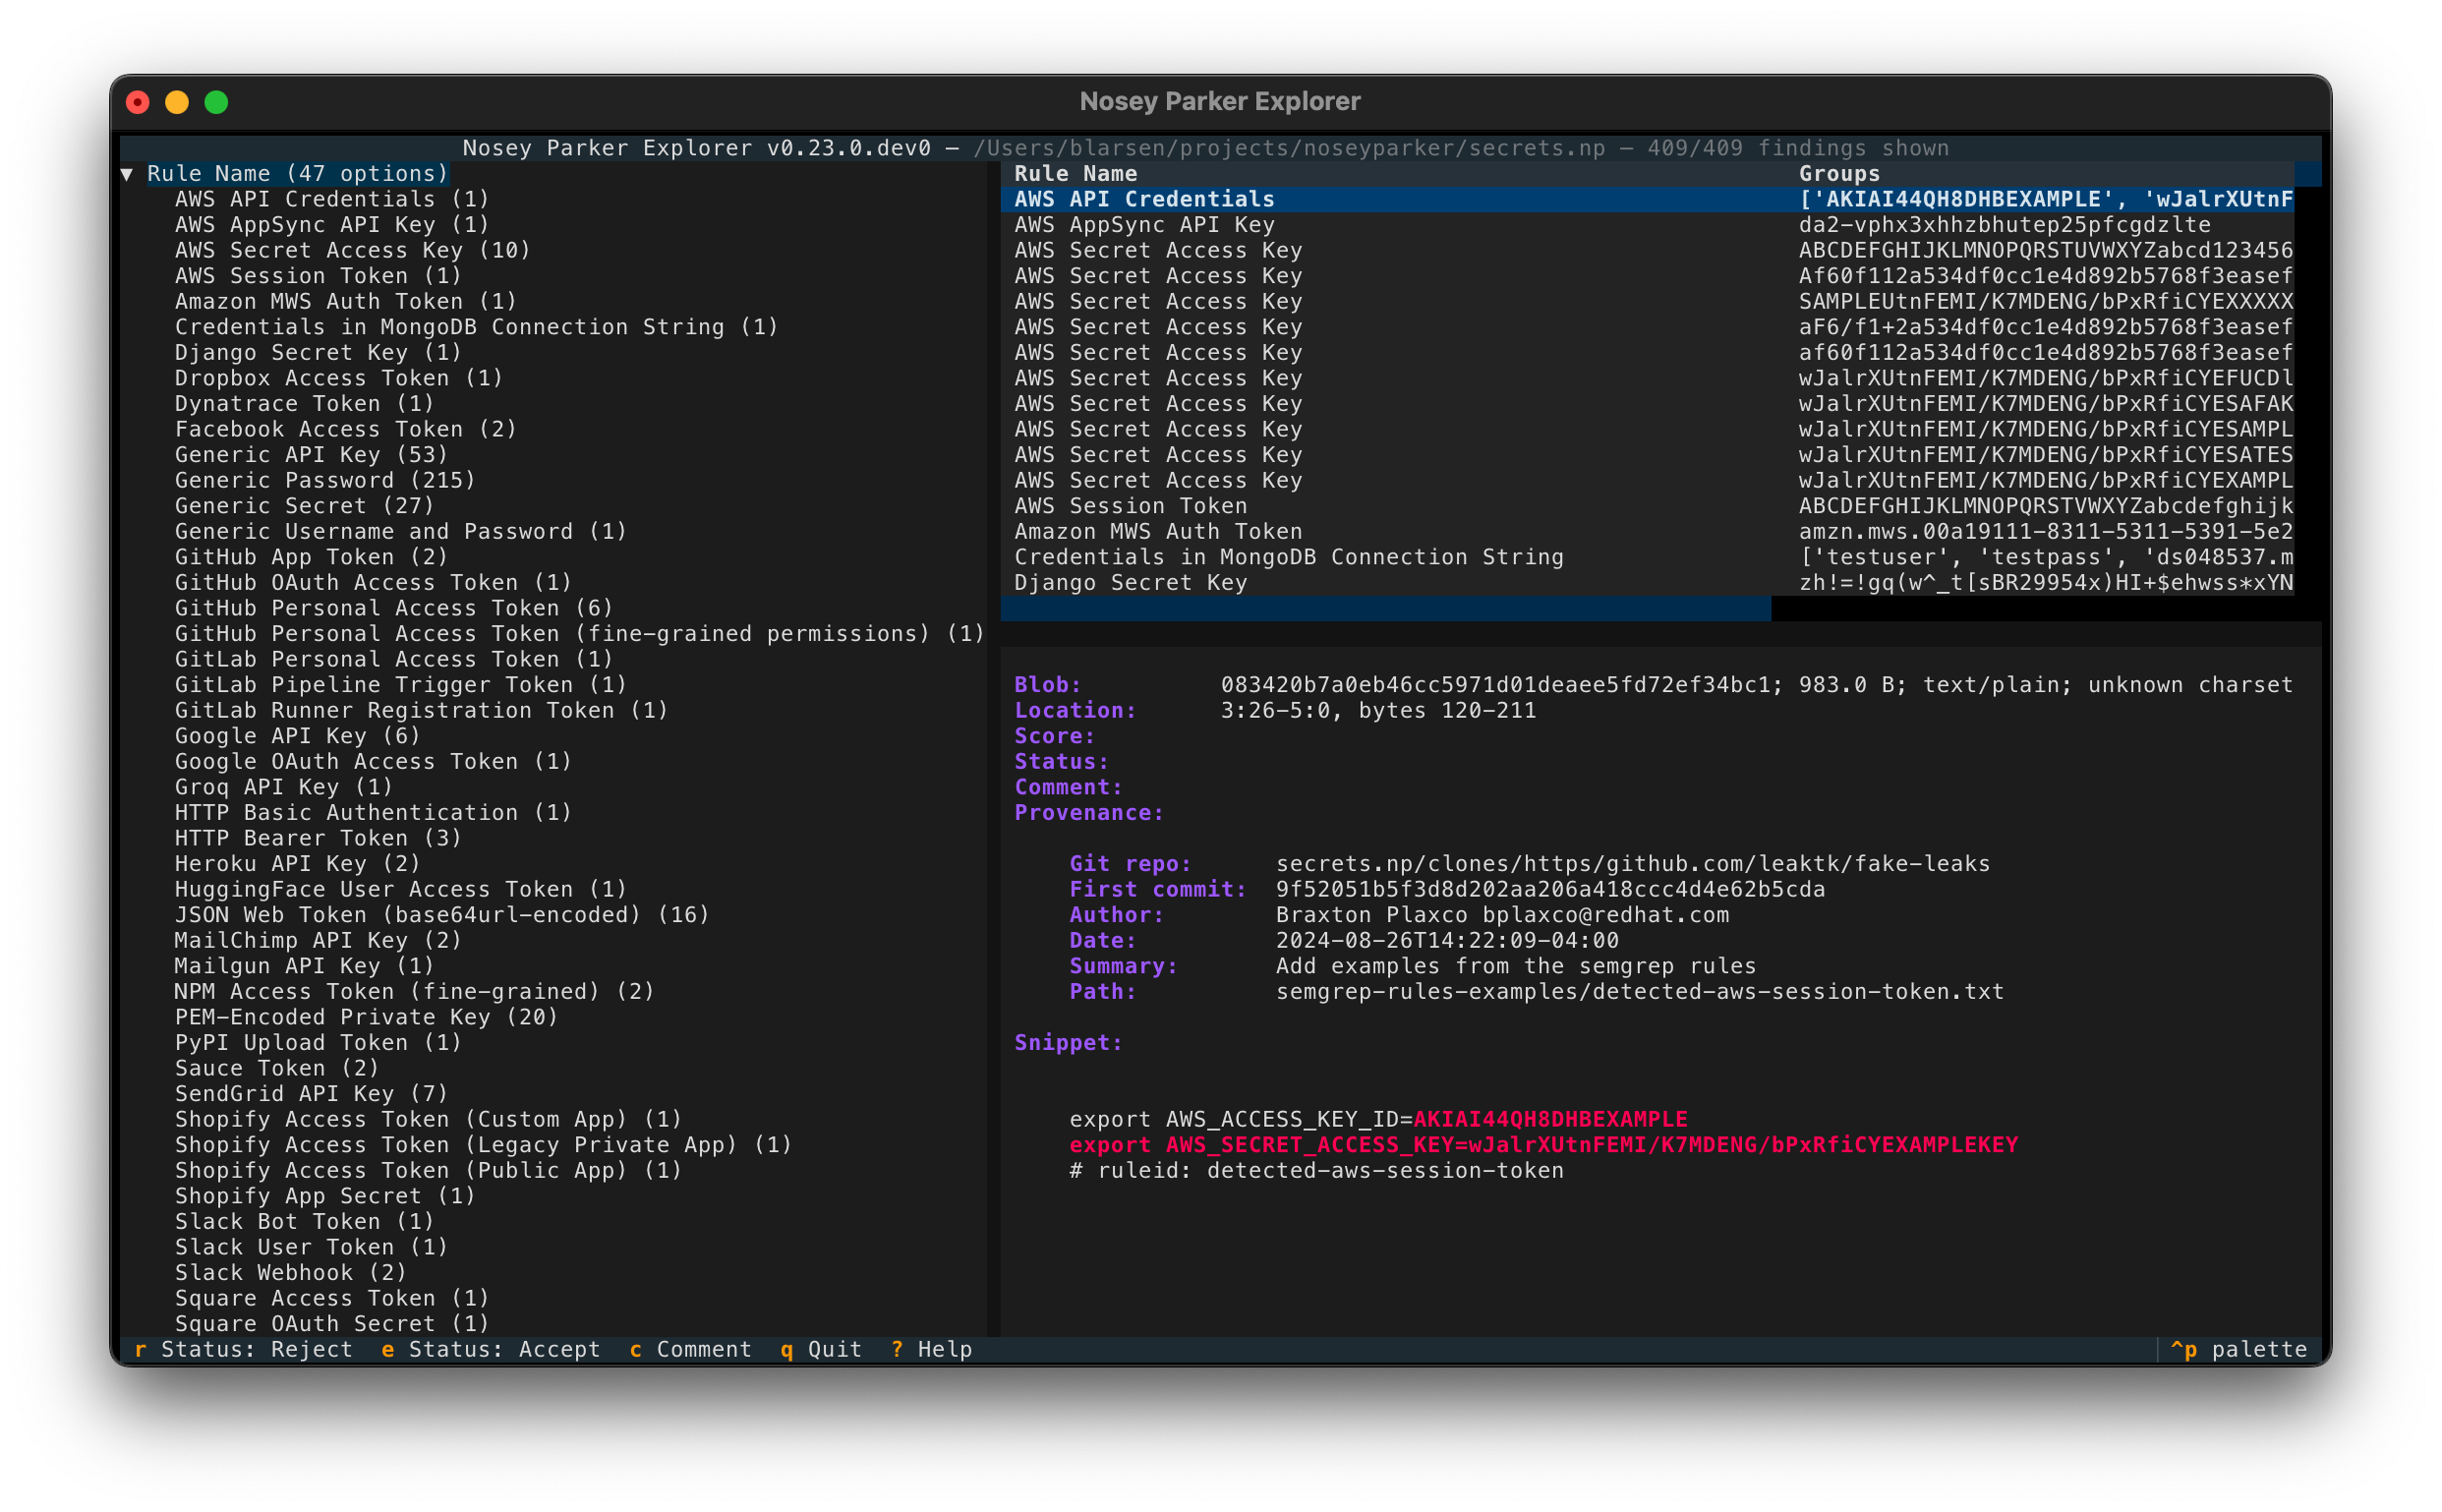
Il flusso di lavoro tipico è in tre fasi:
scanreportbrew install noseyparker
La pagina dell'ultima release contiene binari precompilati per x86_64/aarch64 Linux e macOS.
docker pull ghcr.io/praetorian-inc/noseyparker:latest
Anche il commit più recente è disponibile tramite il tag main.
docker pull ghcr.io/praetorian-inc/noseyparker-alpine:latest
Anche il commit più recente è disponibile tramite il tag main.
https://aur.archlinux.org/packages/noseyparker
Nosey Parker non viene compilato nativamente su Windows (#121). È possibile eseguirlo su Windows usando WSL1 e la release nativa Linux.
È stato testato con diverse versioni di Ubuntu Linux e macOS sia su x86_64 che aarch64.
Dipendenze richieste:
cargo: approccio consigliato: installare da https://rustup.rscmake: necessario per compilare la crate vectorscan-sys e alcune altre dipendenzeboost: necessario per compilare la crate vectorscan-sys (versione supportata >=1.57)git: necessario per incorporare le informazioni sulla versione nella CLI noseyparkerpatch: necessario per compilare la crate vectorscan-syspkg-config: necessario per compilare la crate vectorscan-syssha256sum: necessario per calcolare i digest (spesso fornito dal pacchetto coreutils)zsh: necessario per gli script di buildcreate-release.zsh$ rm -rf release && ./scripts/create-release.zsh
Se ha successo, produrrà una struttura di directory in release popolata con gli artefatti della release.
Il programma da riga di comando sarà in release/bin/noseyparker.
Eseguire il binario noseyparker senza argomenti stampa l'aiuto di alto livello ed esce.
È possibile ottenere aiuto abbreviato per un comando particolare eseguendo noseyparker COMANDO -h.
Aiuto più dettagliato è disponibile con il comando help o l'opzione --help estesa.
Le release precompilate includono anche pagine man che raccolgono l'aiuto da riga di comando in un unico posto. Queste pagine man convertite in formato Markdown sono anche incluse nel repository qui.
Se hai una domanda a cui non viene data risposta da questa documentazione, per favore avvia una discussione.
Il datastore è una directory speciale che Nosey Parker utilizza per registrare i suoi risultati e mantenere il suo stato interno.
Un datastore verrà creato implicitamente dal comando scan se necessario.
Ogni input scansionato è chiamato blob. Ogni blob ha un ID blob univoco, che è un digest SHA-1 calcolato allo stesso modo di come fa git.
Ogni blob ha una o più voci di provenienza associate. Una voce di provenienza è un metadato che descrive come l'input è stato scoperto, ad esempio un file sul filesystem o un file nella cronologia di un repository Git.
Nosey Parker è un sistema basato su regole che utilizza espressioni regolari.
Ogni regola ha un singolo pattern con almeno un gruppo di cattura che isola il contenuto della corrispondenza dal contesto circostante.
Puoi elencare le regole disponibili con noseyparker rules list.
Una raccolta di regole è organizzata in un ruleset.
Il ruleset predefinito di Nosey Parker include regole che rilevano cose che sembrano essere segreti.
Altri ruleset sono disponibili; puoi elencarli con noseyparker rules list.
Quando il pattern di una regola corrisponde a un input, produce una corrispondenza. Una corrispondenza è definita in modo univoco da una regola, un ID blob, un offset di byte iniziale e un offset di byte finale; questi campi vengono utilizzati per calcolare un identificatore univoco della corrispondenza.
Le corrispondenze che condividono una regola e gruppi di cattura vengono combinate in un risultato. In altre parole, un risultato è un gruppo di corrispondenze. Questa è l'unità di segnalazione di primo livello di Nosey Parker.
Quando si utilizza l'immagine Docker, sostituire noseyparker nei comandi seguenti con un'invocazione Docker che utilizza un volume montato:
docker run -v "$PWD":/scan ghcr.io/praetorian-inc/noseyparker:latest <ARGS>
Il container Docker viene eseguito con /scan come directory di lavoro, quindi montare $PWD in /scan nel container farà sì che il completamento con tab e i percorsi relativi nella tua invocazione da riga di comando funzionino.
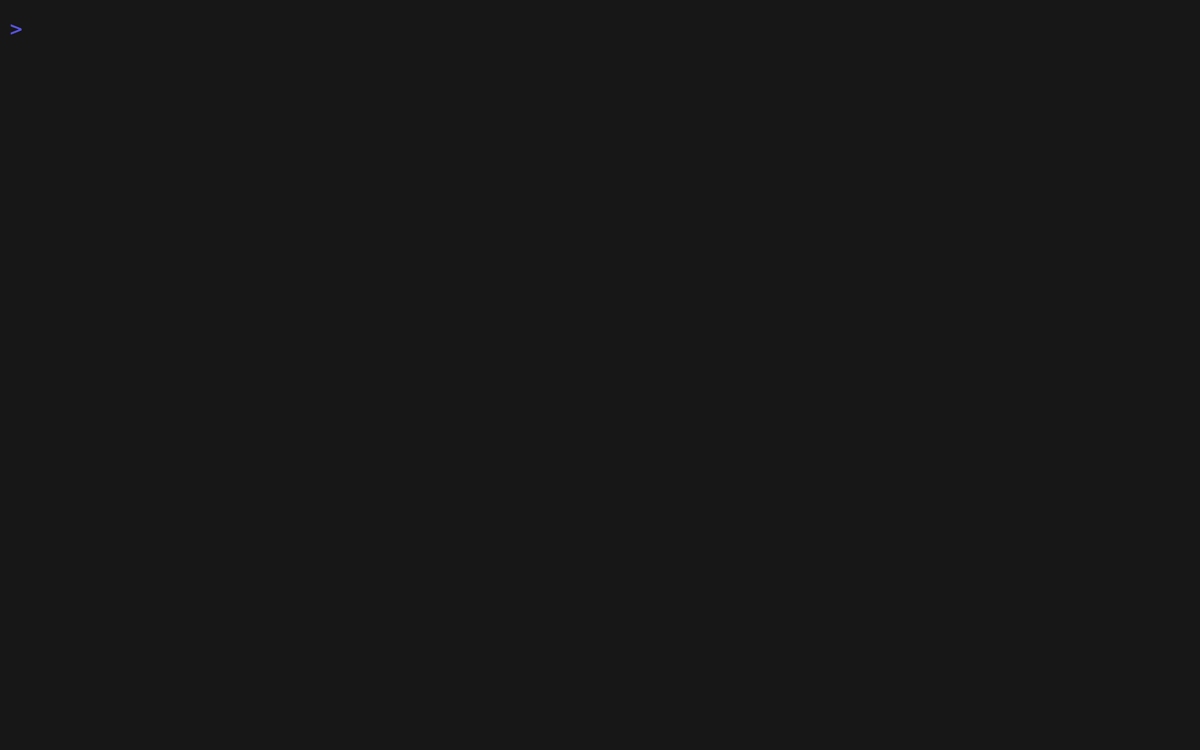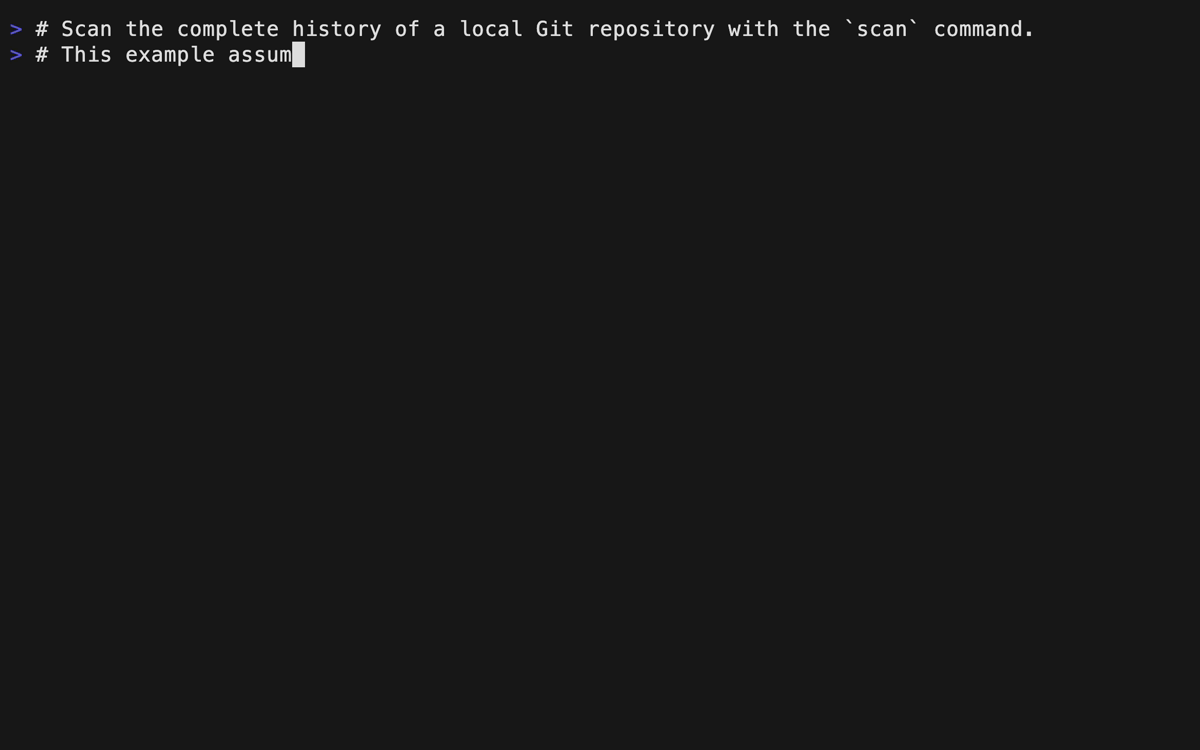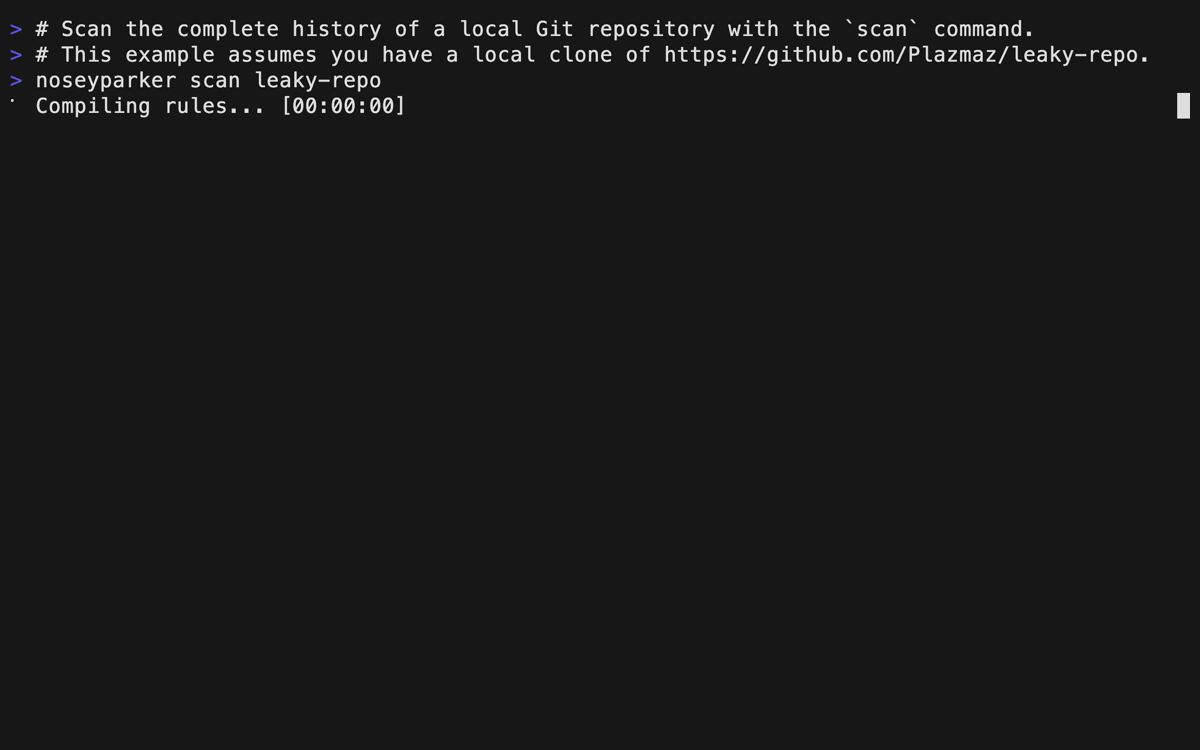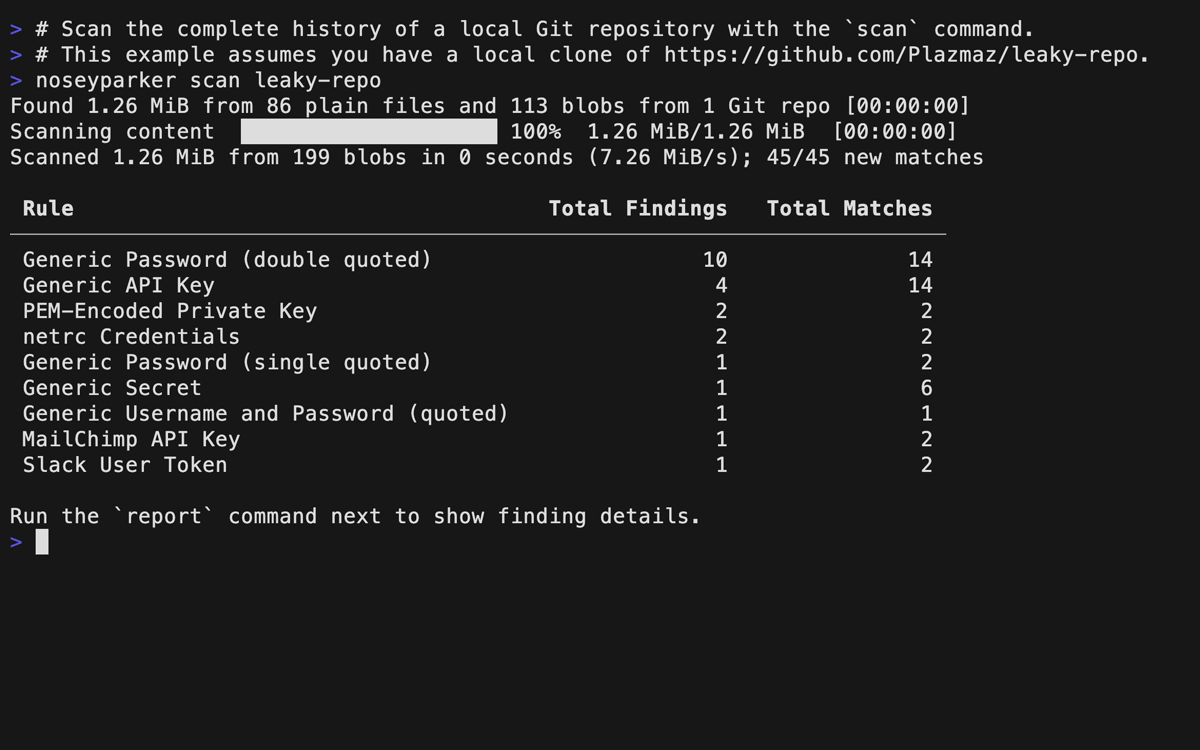
Nosey Parker ha supporto nativo per la scansione di file, directory e l'intera cronologia di repository Git.
Ad esempio, se hai un clone Git di CPython localmente in cpython.git, puoi scannerizzarlo con il comando scan.
Nosey Parker creerà un nuovo datastore in cpython.np e salverà lì i suoi risultati.
(Il nome cpython.np non è essenziale e può essere quello che vuoi.)
$ noseyparker scan -d cpython.np cpython.git
Scansionati 19.19 GiB da 335,849 blob in 17 secondi (1.11 GiB/s); 2,178/2,178 nuove corrispondenze
