AV Chaos Monkey
Piattaforma distribuita di chaos engineering per il test di carico di sistemi di videoconferenza. Simula oltre 1500 partecipanti WebRTC con flussi H.264/Opus e inietta picchi di caos di rete per convalidare la resilienza del sistema in condizioni degradate.
Architettura
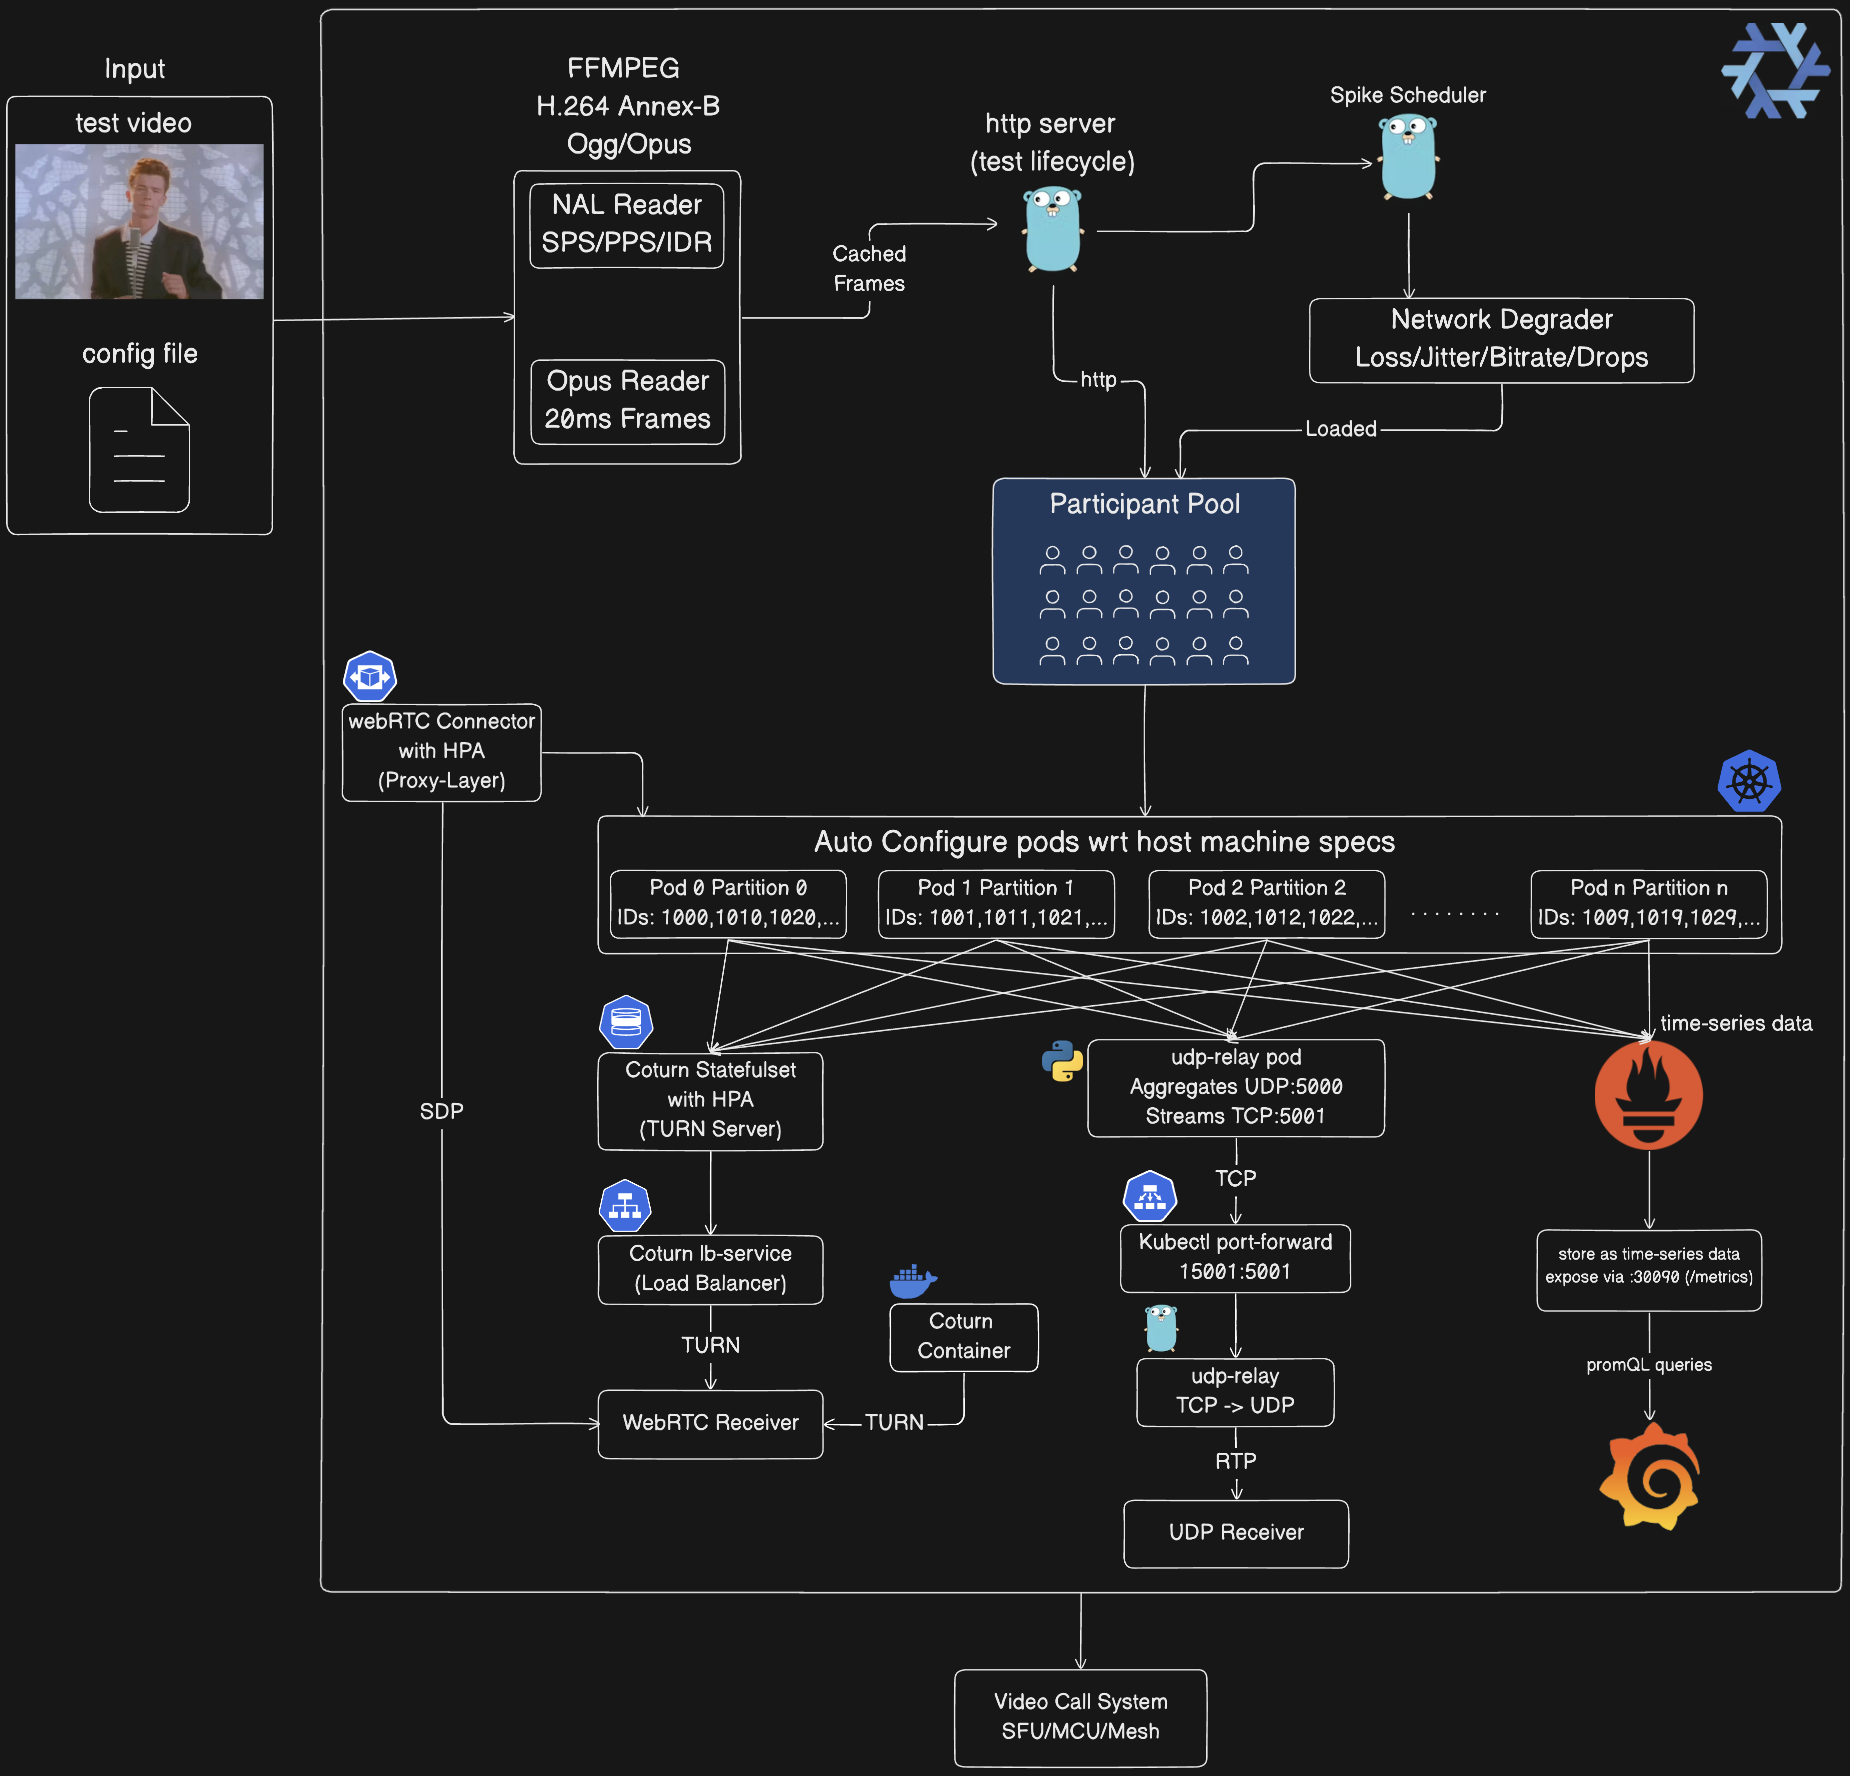
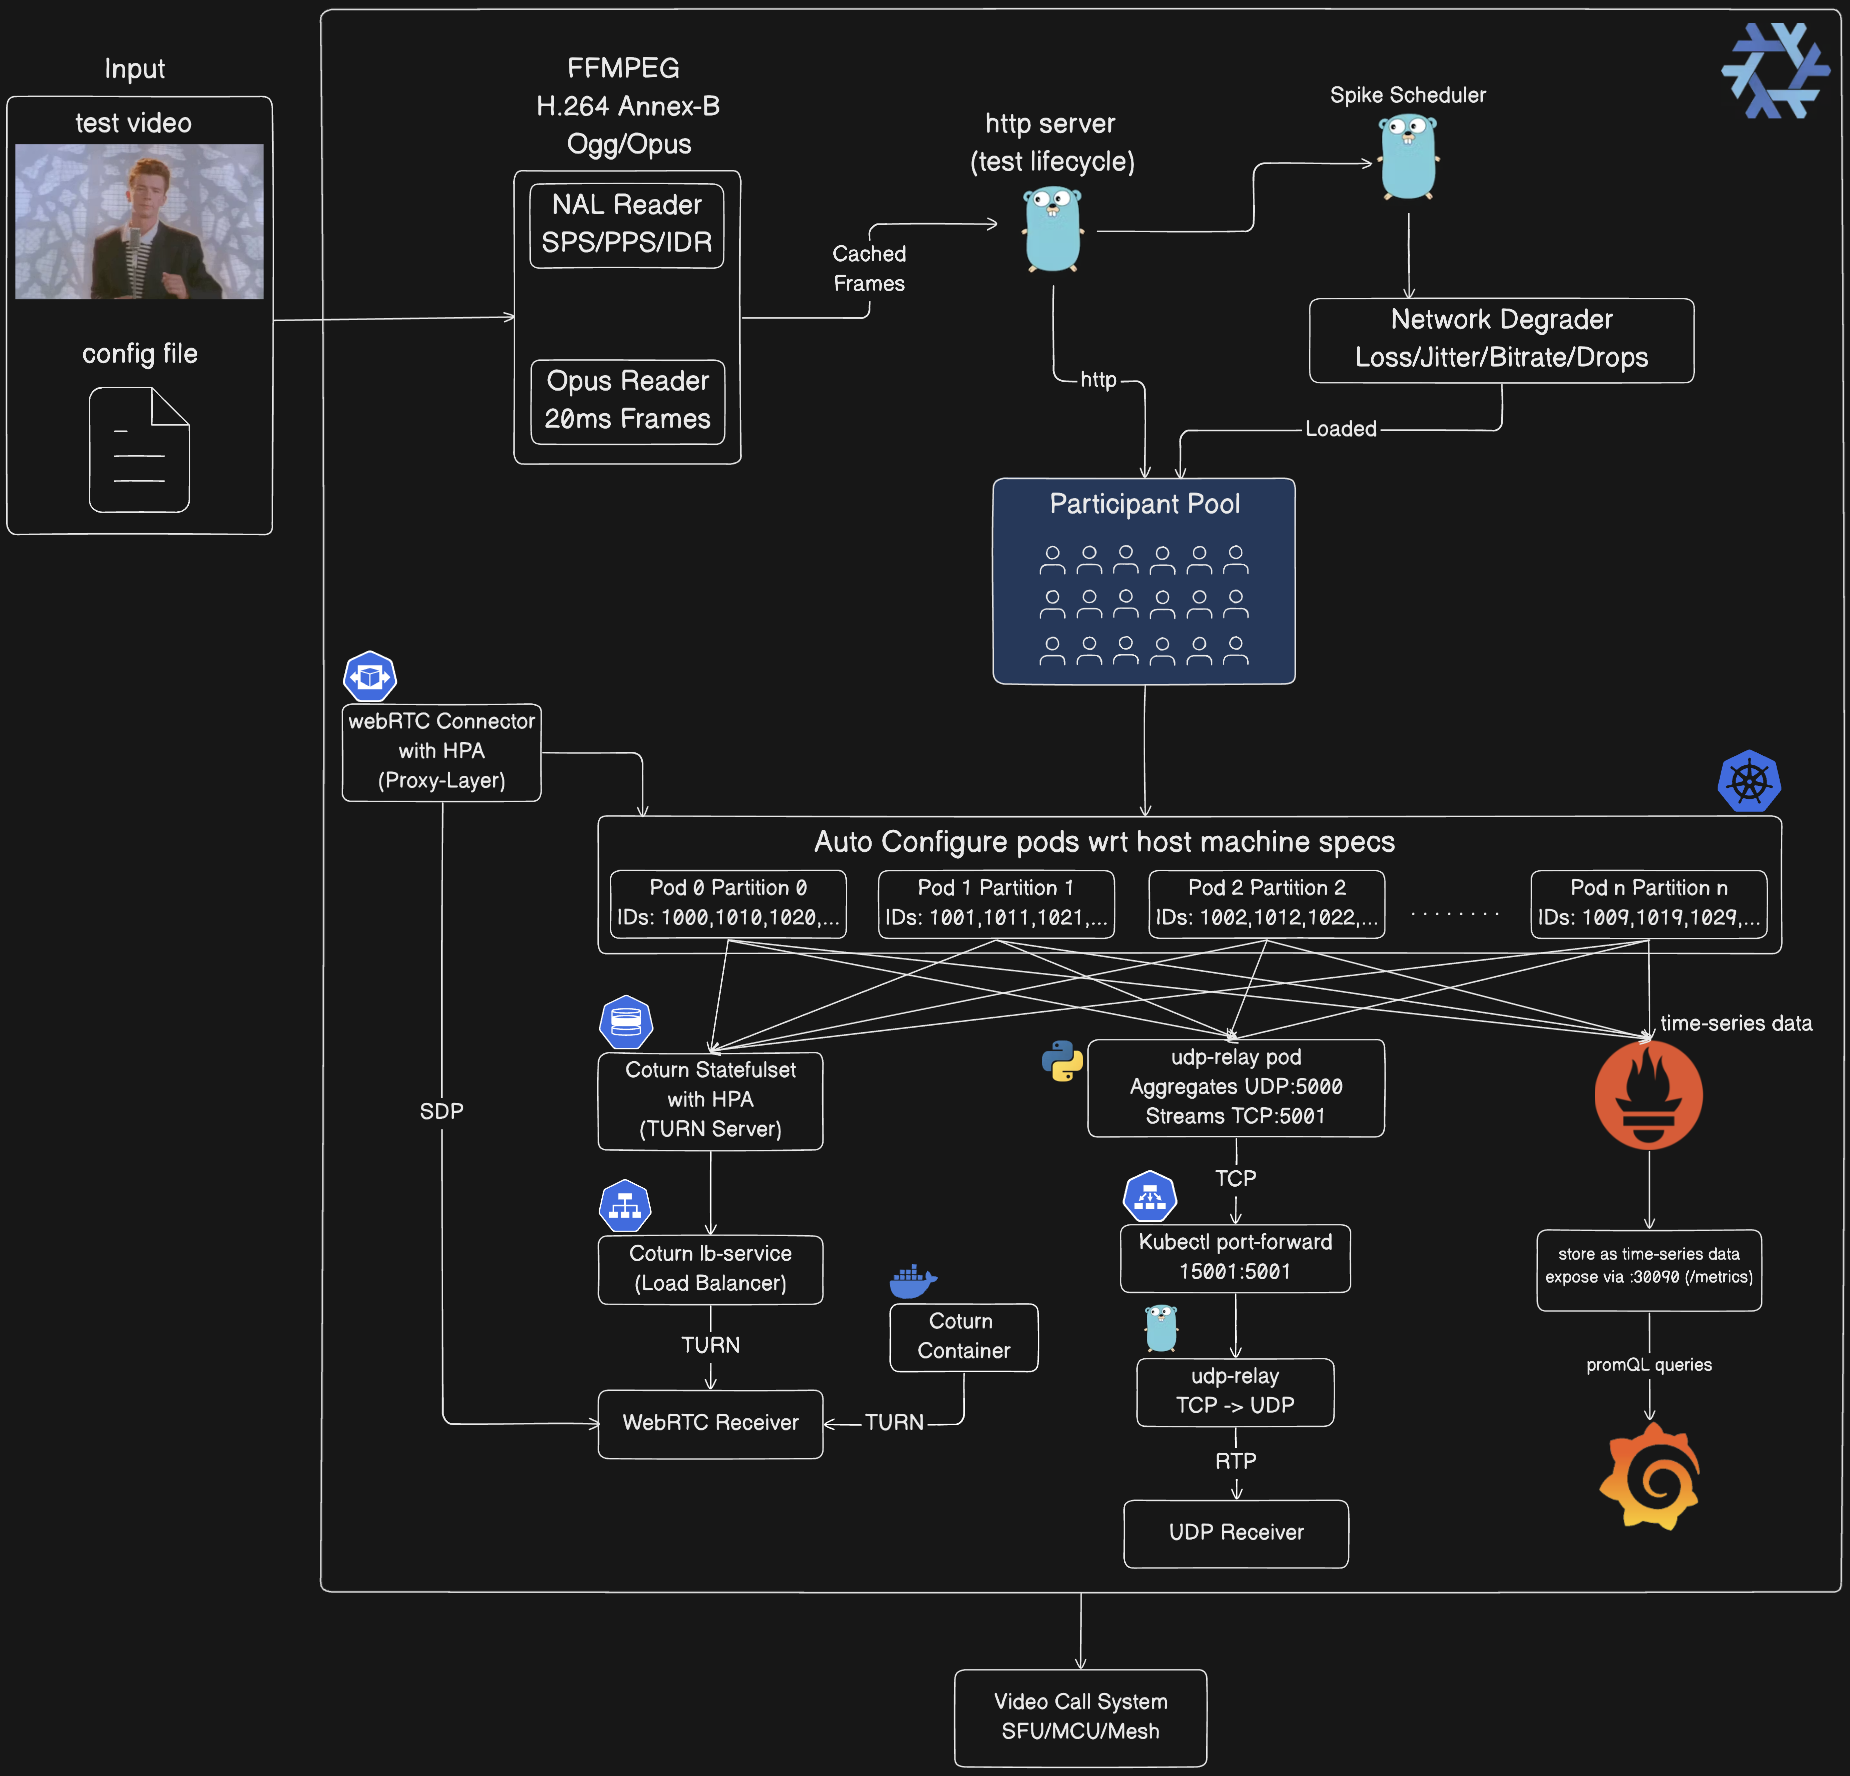
-
Pipeline di elaborazione multimediale:
- FFmpeg converte il video in ingresso in H.264 Annex-B e Ogg/Opus all'avvio
- NAL Reader analizza il flusso H.264 (SPS/PPS/IDR/Slices)
- Opus Reader estrae frame audio da 20ms dal contenitore Ogg
- I frame vengono memorizzati nella cache, condivisi tra tutti i partecipanti (zero-copy)
- Riduce la CPU di ~90% rispetto alla codifica per partecipante
-
Piano di controllo:
- Server HTTP (:8080) gestisce il ciclo di vita del test tramite API REST
- Spike Scheduler distribuisce gli eventi di caos (even/random/front/back/legacy)
- Network Degrader applica il caos: perdita di pacchetti (1-25%), jitter (10-50ms), riduzione del bitrate (30-80%), frame drop (10-60%)
- La configurazione di caos caricata viene applicata al pool di partecipanti
-
Pool di partecipanti:
- Suddivisione automatica tra i pod utilizzando:
participant_id % total_partitions = partition_id
- Ogni partecipante genera flussi RTP (PT=96 video, PT=111 audio)
- ID del partecipante incorporato nell'intestazione di estensione RTP (ID=1)
- Dimensione del pool: 1-100 (locale), 100-500 (Docker), 500-1500 (Kubernetes)
-
Auto-configurazione Kubernetes:
- I pod rilevano automaticamente l'ID di partizione dal nome del pod:
orchestrator-3 → PARTITION_ID=3
- Allocazione delle porte:
base_port + (partition_id × 10000) + participant_index
- Esempio: Partizione 0 utilizza 5000-14999, Partizione 1 utilizza 15000-24999
- StatefulSet con 10 repliche, ognuna gestisce ~150 partecipanti
- Risorse: 1-4 CPU, 2-4Gi di memoria per pod
- Si configura automaticamente in base alle specifiche della macchina host
-
Catena di relay UDP (solo Kubernetes):
Orchestrator Pods (10×) → UDP :5000 → udp-relay Pod (Python)
→ Length-Prefixed TCP :5001 → kubectl port-forward 15001:5001
→ tools/udp-relay (Go) → UDP :5002 → Your Receiver
- Perché: kubectl port-forward supporta solo TCP, non UDP
- Relay in-cluster: Lo script Python aggrega UDP da tutti i pod, lo streamma come TCP con prefisso di lunghezza a 2 byte
- Relay locale: Il tool Go riconverte il flusso TCP in pacchetti UDP
- Aggrega 1500 flussi di partecipanti in una singola connessione
-
Infrastruttura WebRTC:
- Coturn StatefulSet: 3 repliche iniziali, HPA scala da 1 a 10 in base al carico (~500 partecipanti/replica)
- coturn-lb Service: Bilancia il traffico TURN tra le repliche
- webrtc-connector: Layer proxy opzionale (Deployment + HPA 2-10 repliche), gestisce la segnalazione SDP
- Docker Mode: Singolo contenitore Coturn per test locali
- Porte: 3478 (TURN), 49152-65535 (intervallo relay)
- Credenziali: webrtc/webrtc123
-
Integrazione client:
- UDP Receiver: Riceve il flusso RTP aggregato da tutti i partecipanti tramite la catena di relay
- WebRTC Receiver: Stabilisce connessioni WebRTC 1:1 tramite scambio SDP attraverso server TURN
- Entrambi inoltrano al sistema di videochiamata in test (SFU/MCU/Mesh)
-
Stack di osservabilità (Opzionale):
- Prometheus: Raccoglie l'endpoint
/metrics da tutti i pod orchestrator ogni 5 secondi
- Grafana: Visualizza le metriche tramite dashboard preconfigurata (admin/admin)
- Metriche esposte: conteggio partecipanti, pacchetti inviati, byte inviati, spike attivi, percentuale di perdita pacchetti, jitter, punteggio MOS
- Accesso: Prometheus su :30090, Grafana su :30030 (NodePort)
- Pod orchestrator annotati per auto-scoperta:
prometheus.io/scrape: "true"
Concetti fondamentali
Simulazione dei partecipanti
Ogni partecipante virtuale genera flussi multimediali reali:
- Video: Unità NAL H.264 da file video reali, pacchettizzati secondo RFC 6184
- Audio: Frame Opus da contenitori Ogg, pacchettizzati secondo RFC 7587
- RTP: Intestazioni conformi agli standard con estensioni ID partecipante
- Temporizzazione: Temporizzazione accurata al frame (30fps video, pacchetti audio da 20ms)
Iniezione di caos
Cinque tipi di spike simulano condizioni di rete reali:
- Packet Loss: Elimina pacchetti RTP a livello applicativo (1-100%)
- Network Jitter: Aggiunge variazione di latenza (ritardo base + jitter gaussiano)
- Bitrate Reduction: Limita la codifica video (riduzione 30-80%)
- Frame Drops: Salta frame video (tasso di drop 10-60%)
- Bandwidth Limiting: Limita la velocità effettiva totale
Strategie di distribuzione
Gli spike vengono distribuiti durante la durata del test utilizzando strategie configurabili:
- Even: Spaziatura uniforme con jitter (carico prevedibile)
- Random: Tempistica imprevedibile (caos realistico)
- Front-loaded: Spike densi all'inizio (test di recupero)
- Back-loaded: Baseline poi caos (test di confronto)
- Legacy: Tick a intervallo fisso (iniezione runtime)
Partizionamento
Le distribuzioni Kubernetes utilizzano il partizionamento dei partecipanti per la scalabilità orizzontale:
- Ogni pod gestisce
participant_id % total_partitions == partition_id
- Allocazione delle porte:
base_port + (partition_id * 10000) + participant_index
- Distribuzione automatica del carico su 1-10 pod
- Scalabilità fino a oltre 1500 partecipanti (150 per pod)
Esecuzione del sistema
1. Sviluppo locale (Go nativo)
Ideale per: Sviluppo, debugging, test su piccola scala (1-100 partecipanti)
# Avvia orchestrator
go run cmd/main.go

# In un altro terminale: Avvia UDP receiver
go run examples/go/udp_receiver.go 5002

# Modifica config/config.json per impostare num_participants: 10
# Esegui test di caos
go run tools/chaos-test/main.go -config config/config.json
Cosa succede:
- Singolo processo orchestrator su
:8080
- I partecipanti inviano UDP a
127.0.0.1:5002
- Gli spike di caos vengono iniettati tramite API HTTP
- Metriche in tempo reale visualizzate ogni 2 secondi
Configurazione (config/config.json):
{
  "base_url": "http://localhost:8080",
  "media_path": "public/rick-roll.mp4",
  "num_participants": 10,
  "duration_seconds": 300,
  "spikes": {
    "count": 20,
    "interval_seconds": 5,
    "types": { "rtp_packet_loss": {...}, "network_jitter": {...} }
  },
  "spike_distribution": {
    "strategy": "random",
    "min_spacing_seconds": 5,
    "jitter_percent": 15
  }
}
2. Docker Compose (containerizzato)
Ideale per: Test isolati, CI/CD, test su media scala (100-500 partecipanti)
Prerequisiti:
- Docker Desktop con allocazione di memoria 8-16 GB
docker-compose installato
# Costruisci e avvia il container orchestrator
./scripts/start_everything.sh build

# In un altro terminale: Avvia UDP receiver
go run examples/go/udp_receiver.go 5002

# Modifica config/config.json per impostare num_participants: 100
# Esegui test di caos (punta al container)
go run tools/chaos-test/main.go -config config/config.json
Limiti di risorse (modifica docker-compose.yaml):
services:
  orchestrator:
    deploy:
      resources:
        limits:
          cpus: "14.0"
          memory: 6G  # Aumenta per più partecipanti
Guida alla scalabilità:
| Memoria Docker | Partecipanti massimi | Core CPU |
|---|
| 8 GB | ~100 | 4 |
| 16 GB | ~250 | 8 |
| 24 GB | ~400 | 12 |
| 32 GB | ~500 | 14 |
3. Kubernetes con Nix (scala di produzione)
 mdsadiqmd/av-chaos-monkey







