 jaidedai/easyocr
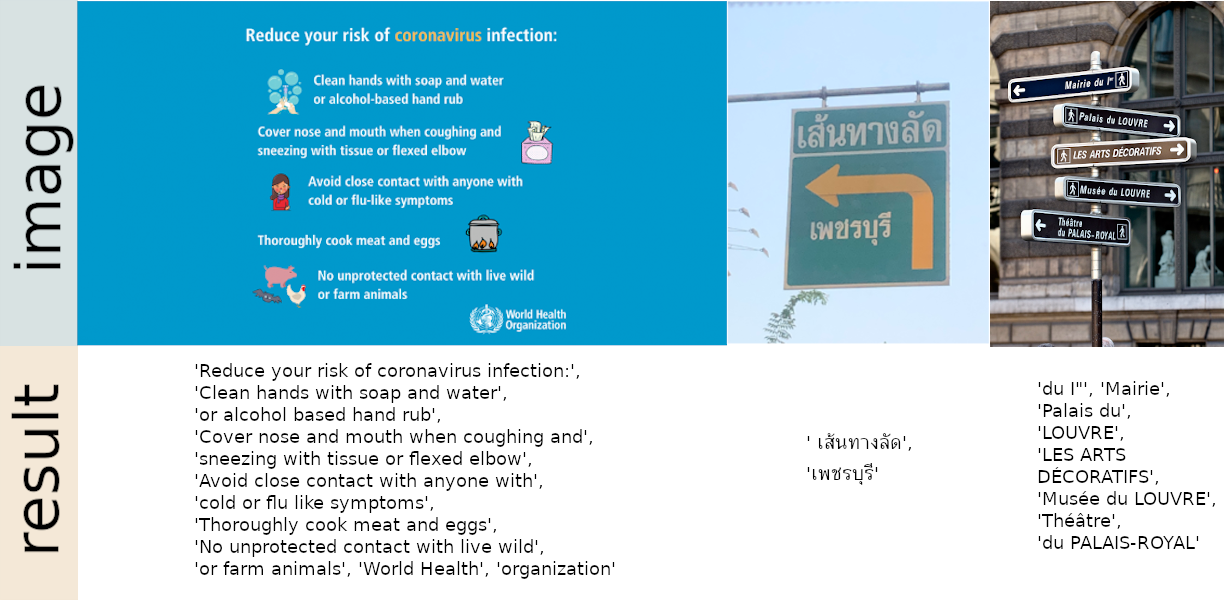
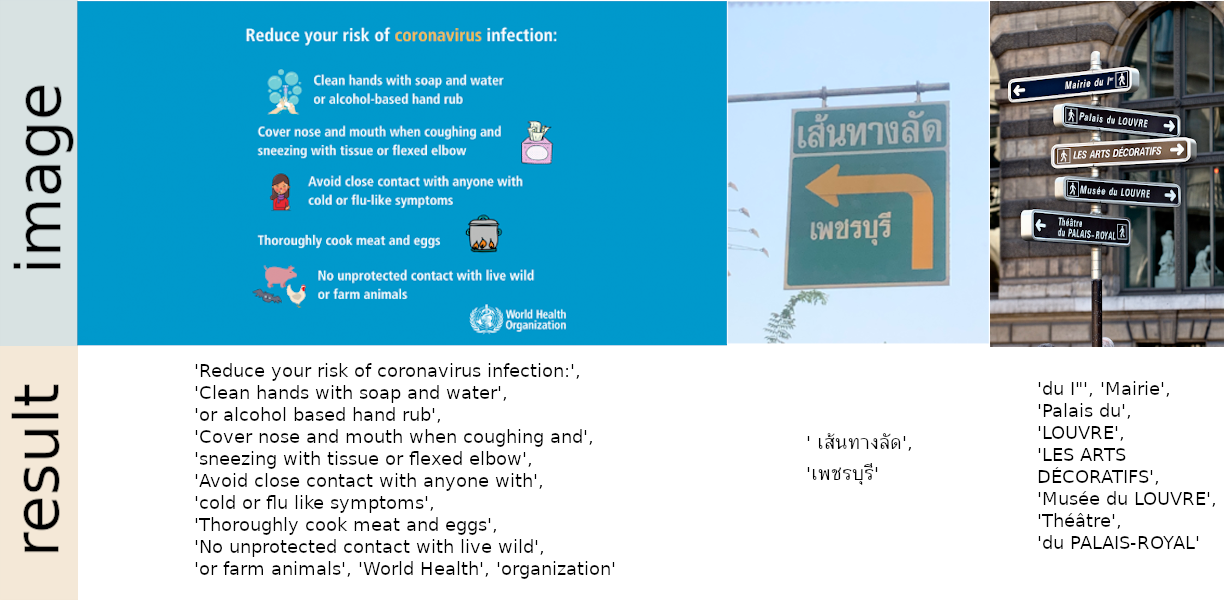
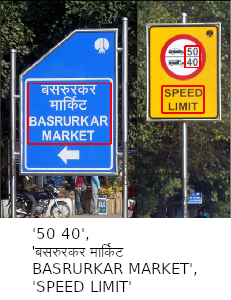
OCR pronto all'uso con oltre 80 lingue supportate e tutti i sistemi di scrittura più diffusi, tra cui latino, cinese, arabo, devanagari, cirillico, ecc.


OCR pronto all'uso con oltre 80 lingue supportate e tutti i principali sistemi di scrittura, tra cui: latino, cinese, arabo, devanagari, cirillico, ecc.
Prova la demo sul nostro sito web
Integrato in Huggingface Spaces 🤗 tramite Gradio. Prova la demo web:
24 settembre 2024 - Versione 1.7.2
Installa usando pip
Per l'ultima versione stabile:
pip install easyocr
Per la versione di sviluppo più recente:
pip install git+https://github.com/JaidedAI/EasyOCR.git
Nota 1: Per Windows, installare prima torch e torchvision seguendo le istruzioni ufficiali qui https://pytorch.org. Sul sito web di pytorch, assicurarsi di selezionare la versione CUDA corretta in uso. Se si intende eseguire solo in modalità CPU, selezionare CUDA = None.
Nota 2: Forniamo anche un Dockerfile qui.
Nota 3: Il rilevatore opzionale DBNet (detect_network='dbnet18') compila le sue operazioni C++/CUDA al primo utilizzo, il che richiede lo strumento di build Ninja. Per installarlo insieme a EasyOCR, usare pip install "easyocr[dbnet]".
import easyocr
reader = easyocr.Reader(['ch_sim','en']) # this needs to run only once to load the model into memory
result = reader.readtext('chinese.jpg')
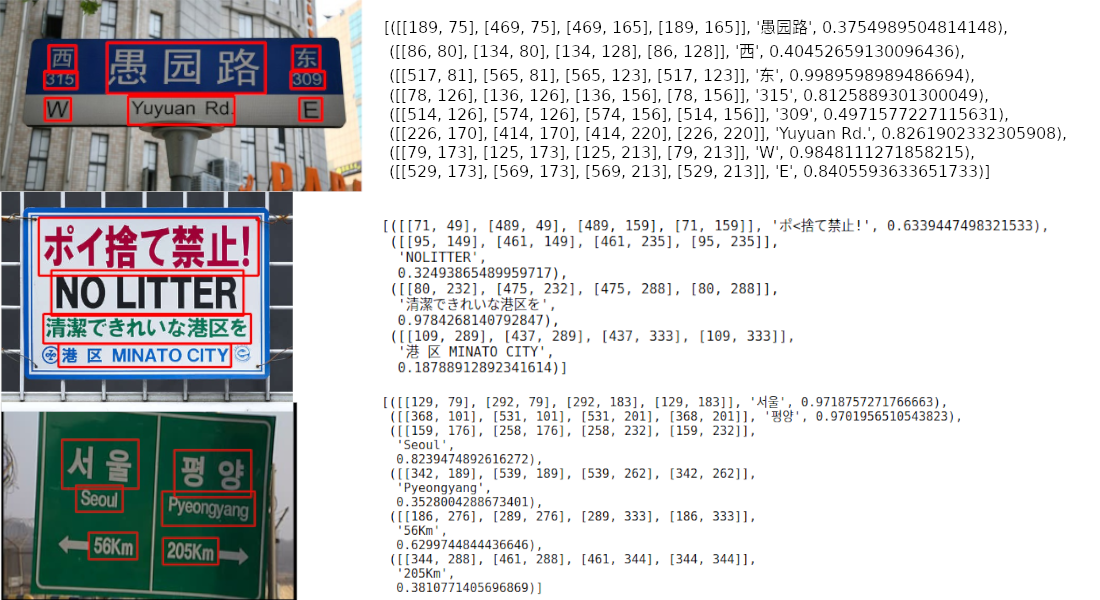
L'output sarà in formato elenco, ogni elemento rappresenta rispettivamente un bounding box, il testo rilevato e il livello di confidenza.
[([[189, 75], [469, 75], [469, 165], [189, 165]], '愚园路', 0.3754989504814148),
 ([[86, 80], [134, 80], [134, 128], [86, 128]], '西', 0.40452659130096436),
 ([[517, 81], [565, 81], [565, 123], [517, 123]], '东', 0.9989598989486694),
 ([[78, 126], [136, 126], [136, 156], [78, 156]], '315', 0.8125889301300049),
 ([[514, 126], [574, 126], [574, 156], [514, 156]], '309', 0.4971577227115631),
 ([[226, 170], [414, 170], [414, 220], [226, 220]], 'Yuyuan Rd.', 0.8261902332305908),
 ([[79, 173], [125, 173], [125, 213], [79, 213]], 'W', 0.9848111271858215),
 ([[529, 173], [569, 173], [569, 213], [529, 213]], 'E', 0.8405593633651733)]
Nota 1: ['ch_sim','en'] è la lista delle lingue che vuoi leggere. Puoi passare più lingue contemporaneamente, ma non tutte le lingue possono essere usate insieme. L'inglese è compatibile con ogni lingua e le lingue che condividono caratteri comuni sono solitamente compatibili tra loro.
Nota 2: Invece del percorso del file chinese.jpg, puoi anche passare un oggetto immagine OpenCV (array numpy) o un file immagine come bytes. È accettabile anche un URL a un'immagine raw.
Nota 3: La riga reader = easyocr.Reader(['ch_sim','en']) serve a caricare un modello in memoria. Richiede un po' di tempo ma deve essere eseguita solo una volta.
Puoi anche impostare detail=0 per un output più semplice.
reader.readtext('chinese.jpg', detail = 0)
Risultato:
['愚园路', '西', '东', '315', '309', 'Yuyuan Rd.', 'W', 'E']
I pesi del modello per la lingua scelta verranno scaricati automaticamente oppure puoi scaricarli manualmente dal model hub e inserirli nella cartella '~/.EasyOCR/model'
Nel caso in cui non disponi di una GPU, o la tua GPU ha poca memoria, puoi eseguire il modello in modalità solo CPU aggiungendo gpu=False.
reader = easyocr.Reader(['ch_sim','en'], gpu=False)
Per maggiori informazioni, consulta il tutorial e la Documentazione API.
$ easyocr -l ch_sim en -f chinese.jpg --detail=1 --gpu=True
Per il modello di riconoscimento, Leggi qui.
Per il modello di rilevamento (CRAFT), Leggi qui.
reader = easyocr.Reader(['en'], detection='DB', recognition = 'Transformer')
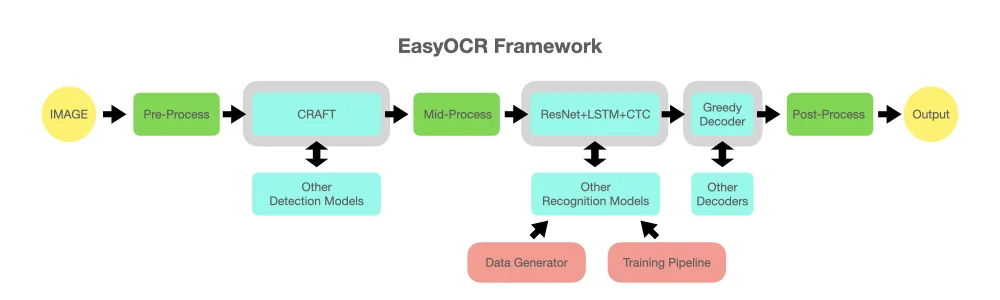
L'idea è poter collegare qualsiasi modello all'avanguardia in EasyOCR. Ci sono molti geni che cercano di realizzare modelli di rilevamento/riconoscimento migliori, ma noi non stiamo cercando di essere geni qui. Vogliamo solo rendere i loro lavori rapidamente accessibili al pubblico... gratuitamente. (beh, crediamo che la maggior parte dei geni voglia che il proprio lavoro crei un impatto positivo il più velocemente/ampiamente possibile) La pipeline dovrebbe essere qualcosa di simile al diagramma sottostante. Gli slot grigi sono segnaposto per moduli azzurri modificabili.
Questo progetto si basa su ricerche e codice provenienti da diversi articoli e repository open-source.
Tutta l'esecuzione del deep learning si basa su Pytorch. ❤️
L'esecuzione del rilevamento utilizza l'algoritmo CRAFT da questo repository ufficiale e dal loro articolo (Grazie @YoungminBaek di @clovaai). Utilizziamo anche il loro modello pre-addestrato. Lo script di addestramento è fornito da @gmuffiness.

