 hoodoer/colonelclustered
Un plugin Burp per Java che esegue il clustering del testo sulle risposte per identificare outlier/gruppi in base al contenuto effettivo delle risposte del server, ad esempio da un'esecuzione di Intruder.

Un'estensione di Burp Suite per raggruppare le risposte HTTP al fine di individuare gli outlier.
Questo è un plugin che ho pensato di realizzare per molti anni, semplicemente perché sono moderatamente infastidito da come analizziamo i risultati degli attacchi di fuzzing in Burp Intruder. Tipicamente cerchiamo cambiamenti nelle risposte del server nei nostri attacchi di fuzzing. E cerchiamo queste differenze osservando i codici di stato, i tempi di risposta e le dimensioni delle risposte. Tutte queste sono misure indirette del contenuto della risposta. Naturalmente, come pentester non abbiamo il tempo di leggere il contenuto di migliaia di risposte del server per cercare differenze nel contenuto delle risposte. Ma sicuramente possiamo far sì che siano gli algoritmi a farlo per noi.
È qui che entra in gioco questo plugin. Utilizza tecniche di clustering testuale per analizzare il contenuto delle risposte e raggrupparle in cluster in base alla loro similarità. Ti offre un altro modo per visualizzare i risultati dei tuoi attacchi di fuzzing con Intruder e per identificare rapidamente le risposte del server che sono diverse.
Colonel Clustered fornisce due diversi algoritmi per eseguire il clustering delle risposte. L'algoritmo predefinito è relativamente veloce, con un algoritmo opzionale di analisi approfondita che eccelle nell'individuare gli outlier, ma non scala bene. Beh, nessuno dei due scala bene, esiterei a sottoporre a questo plugin 50k risposte. L'algoritmo più veloce/predefinito ha una complessità O(n^2), mentre l'algoritmo di analisi approfondita è O(n^3). Quindi tienilo a mente mentre gli invii i risultati di Intruder da elaborare.
Tokenizzazione Content-Aware: L'estensione ispeziona prima l'header Content-Type di ogni risposta per applicare la strategia di tokenizzazione più intelligente:
Pre-Raggruppamento: Per rimanere veloce anche con migliaia di risposte, l'estensione esegue una singola passata per raggruppare tutte le risposte perfettamente identiche. Calcola un hash dell'insieme di token di ogni risposta e raggruppa tutti gli elementi che condividono lo stesso hash. Ciò significa che l'algoritmo di clustering costoso deve essere eseguito solo sul set molto più piccolo di corpi di risposta unici.
Doppio Algoritmo di Clustering: Colonel Clustered offre due distinti algoritmi di clustering:
Fast Scan (Predefinito): Un algoritmo basato su DBSCAN ad alte prestazioni viene eseguito automaticamente quando invii più richieste/risposte all'estensione.
Deep Analysis (Attivazione Manuale): L'algoritmo originale di clustering gerarchico, più intensivo dal punto di vista computazionale, è disponibile tramite un pulsante "Deep Analysis". Questa opzione è progettata per scenari che richiedono una prospettiva di clustering più granulare e potenzialmente diversa, utilizzando l'Average Linkage per una migliore coesione dei cluster.
Consolidamento degli Outlier: Dopo il clustering, qualsiasi gruppo risultante contenente un solo membro unico è considerato un outlier. Tutti questi outlier vengono poi consolidati in un unico e comodo gruppo "Outliers" nell'interfaccia utente.
Questi due algoritmi dovrebbero fornire un modo semplice per identificare automaticamente le risposte del server che differiscono nel contenuto, anche quando la dimensione della risposta è una misura inaffidabile delle differenze tra risposte.
Carica l'Estensione:
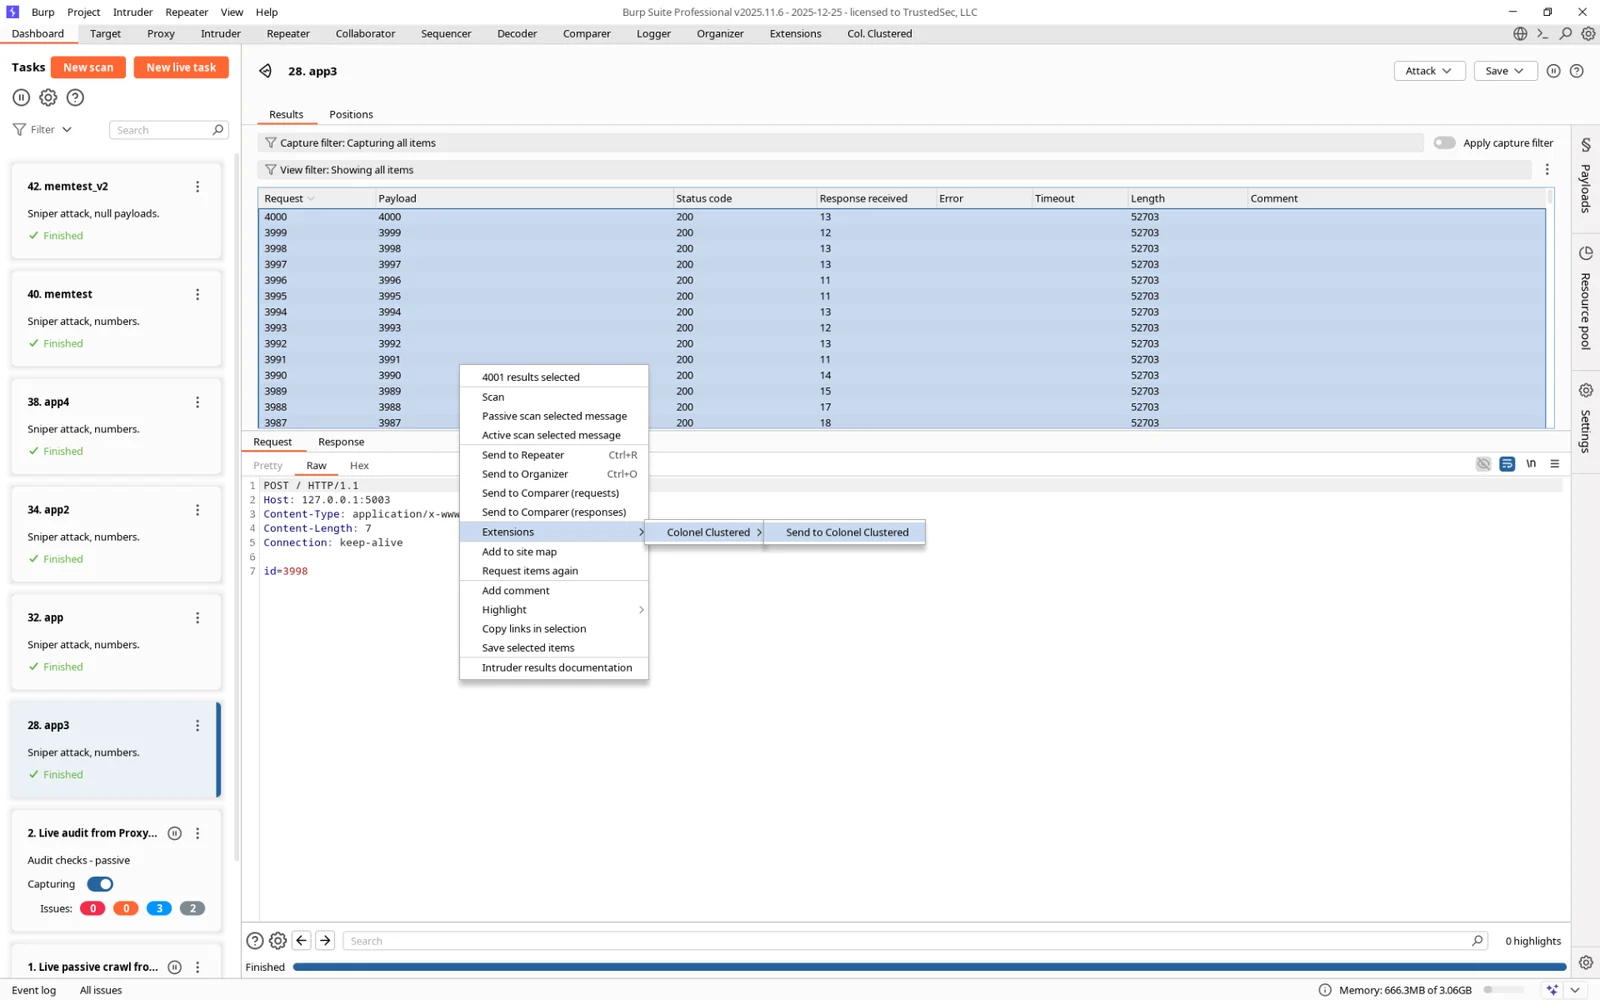
Invia le Risposte per l'Analisi:
Esegui la Deep Analysis (Opzionale):
Analizza i Risultati nell'Interfaccia a Quattro Pannelli:
Request/Response Pair: L'indice originale dell'elemento.Status Code: Il codice di stato della risposta HTTP.Length: La lunghezza del corpo della risposta in byte.Content-Type: L'header Content-Type della risposta.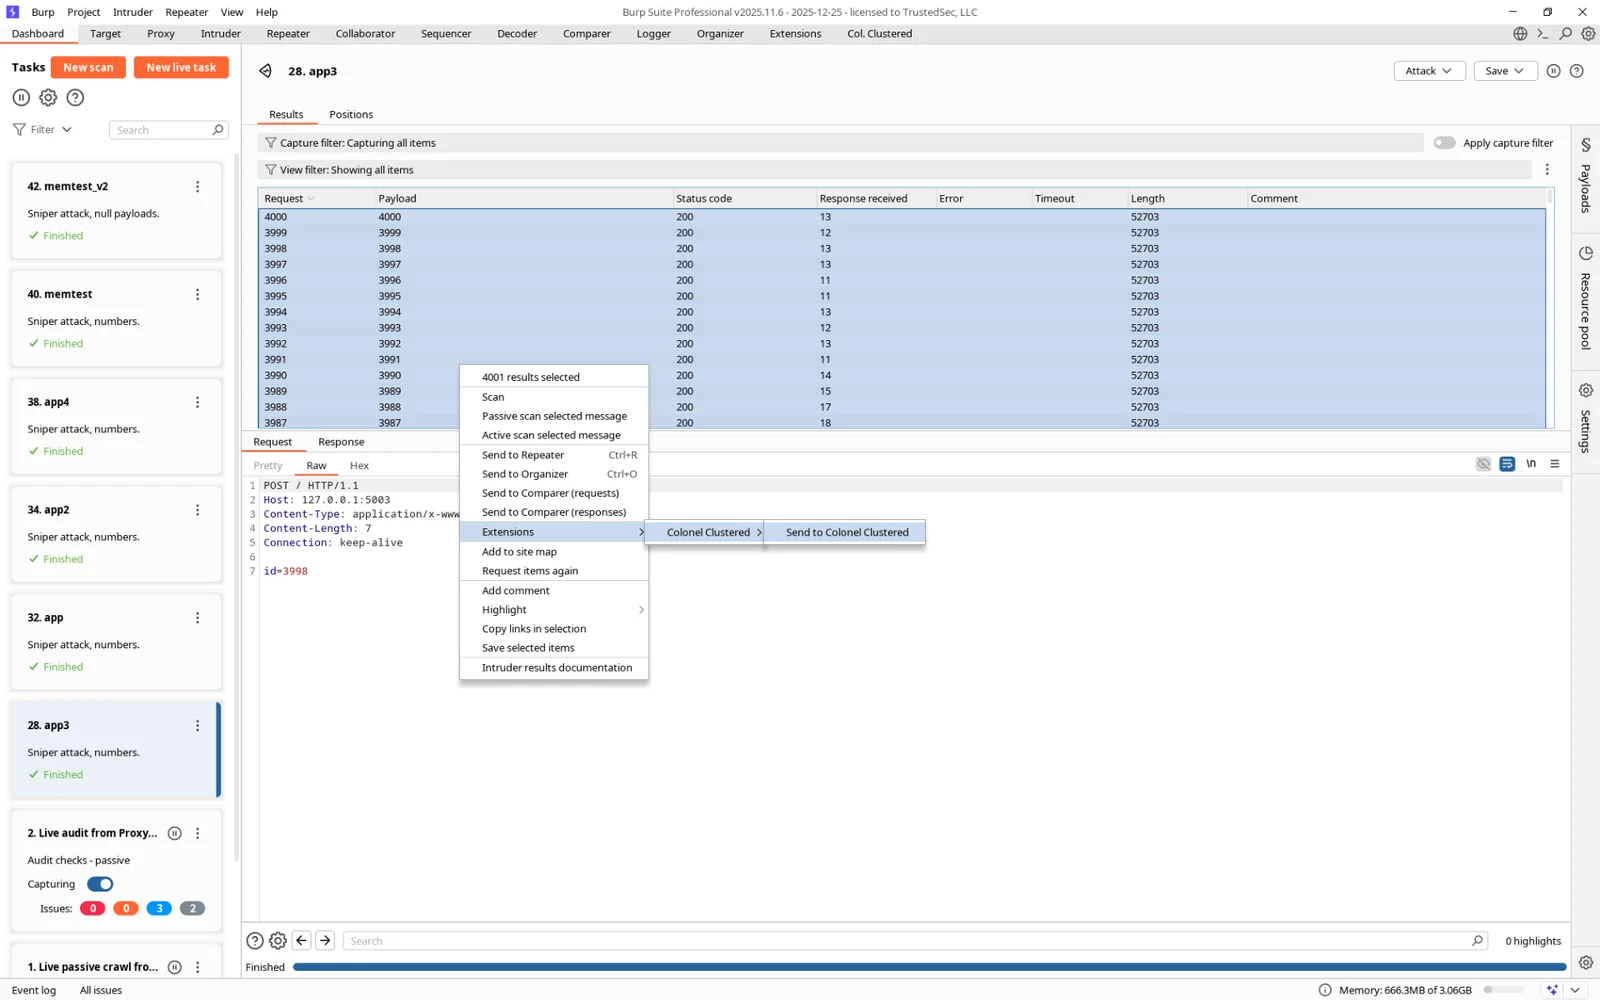
Questo progetto utilizza Gradle. È necessario avere installato JDK versione 17 per compilare il plugin.
