SOCMIntelligence
Strumento web SOCMINT / OSINT multipiattaforma.
Cos'è
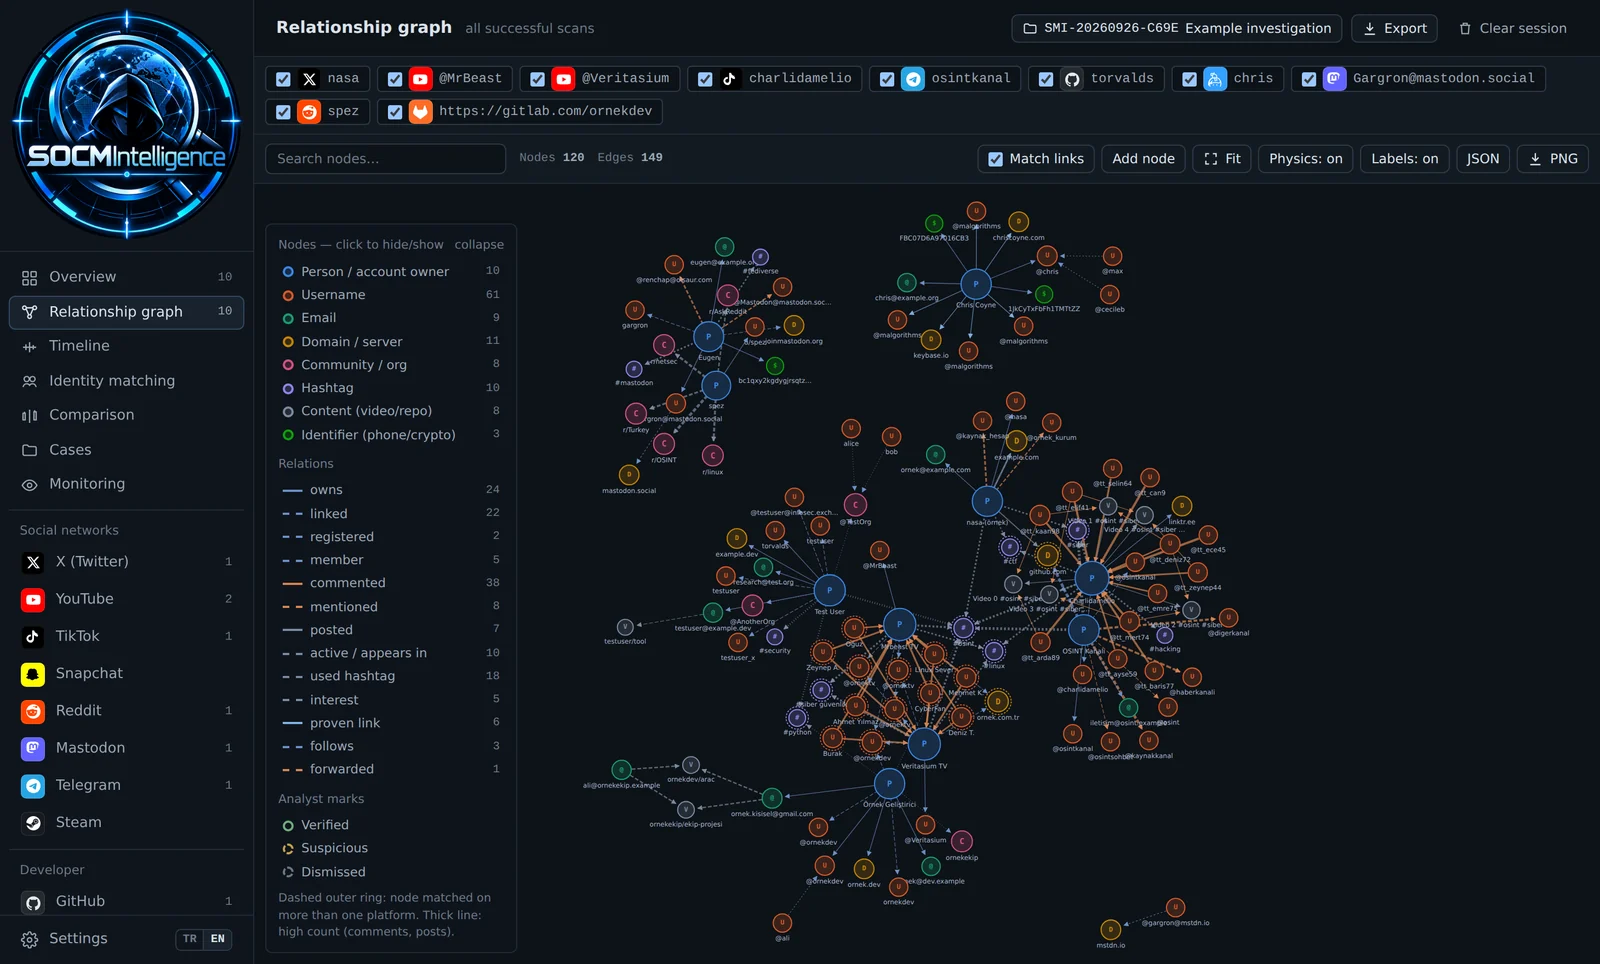
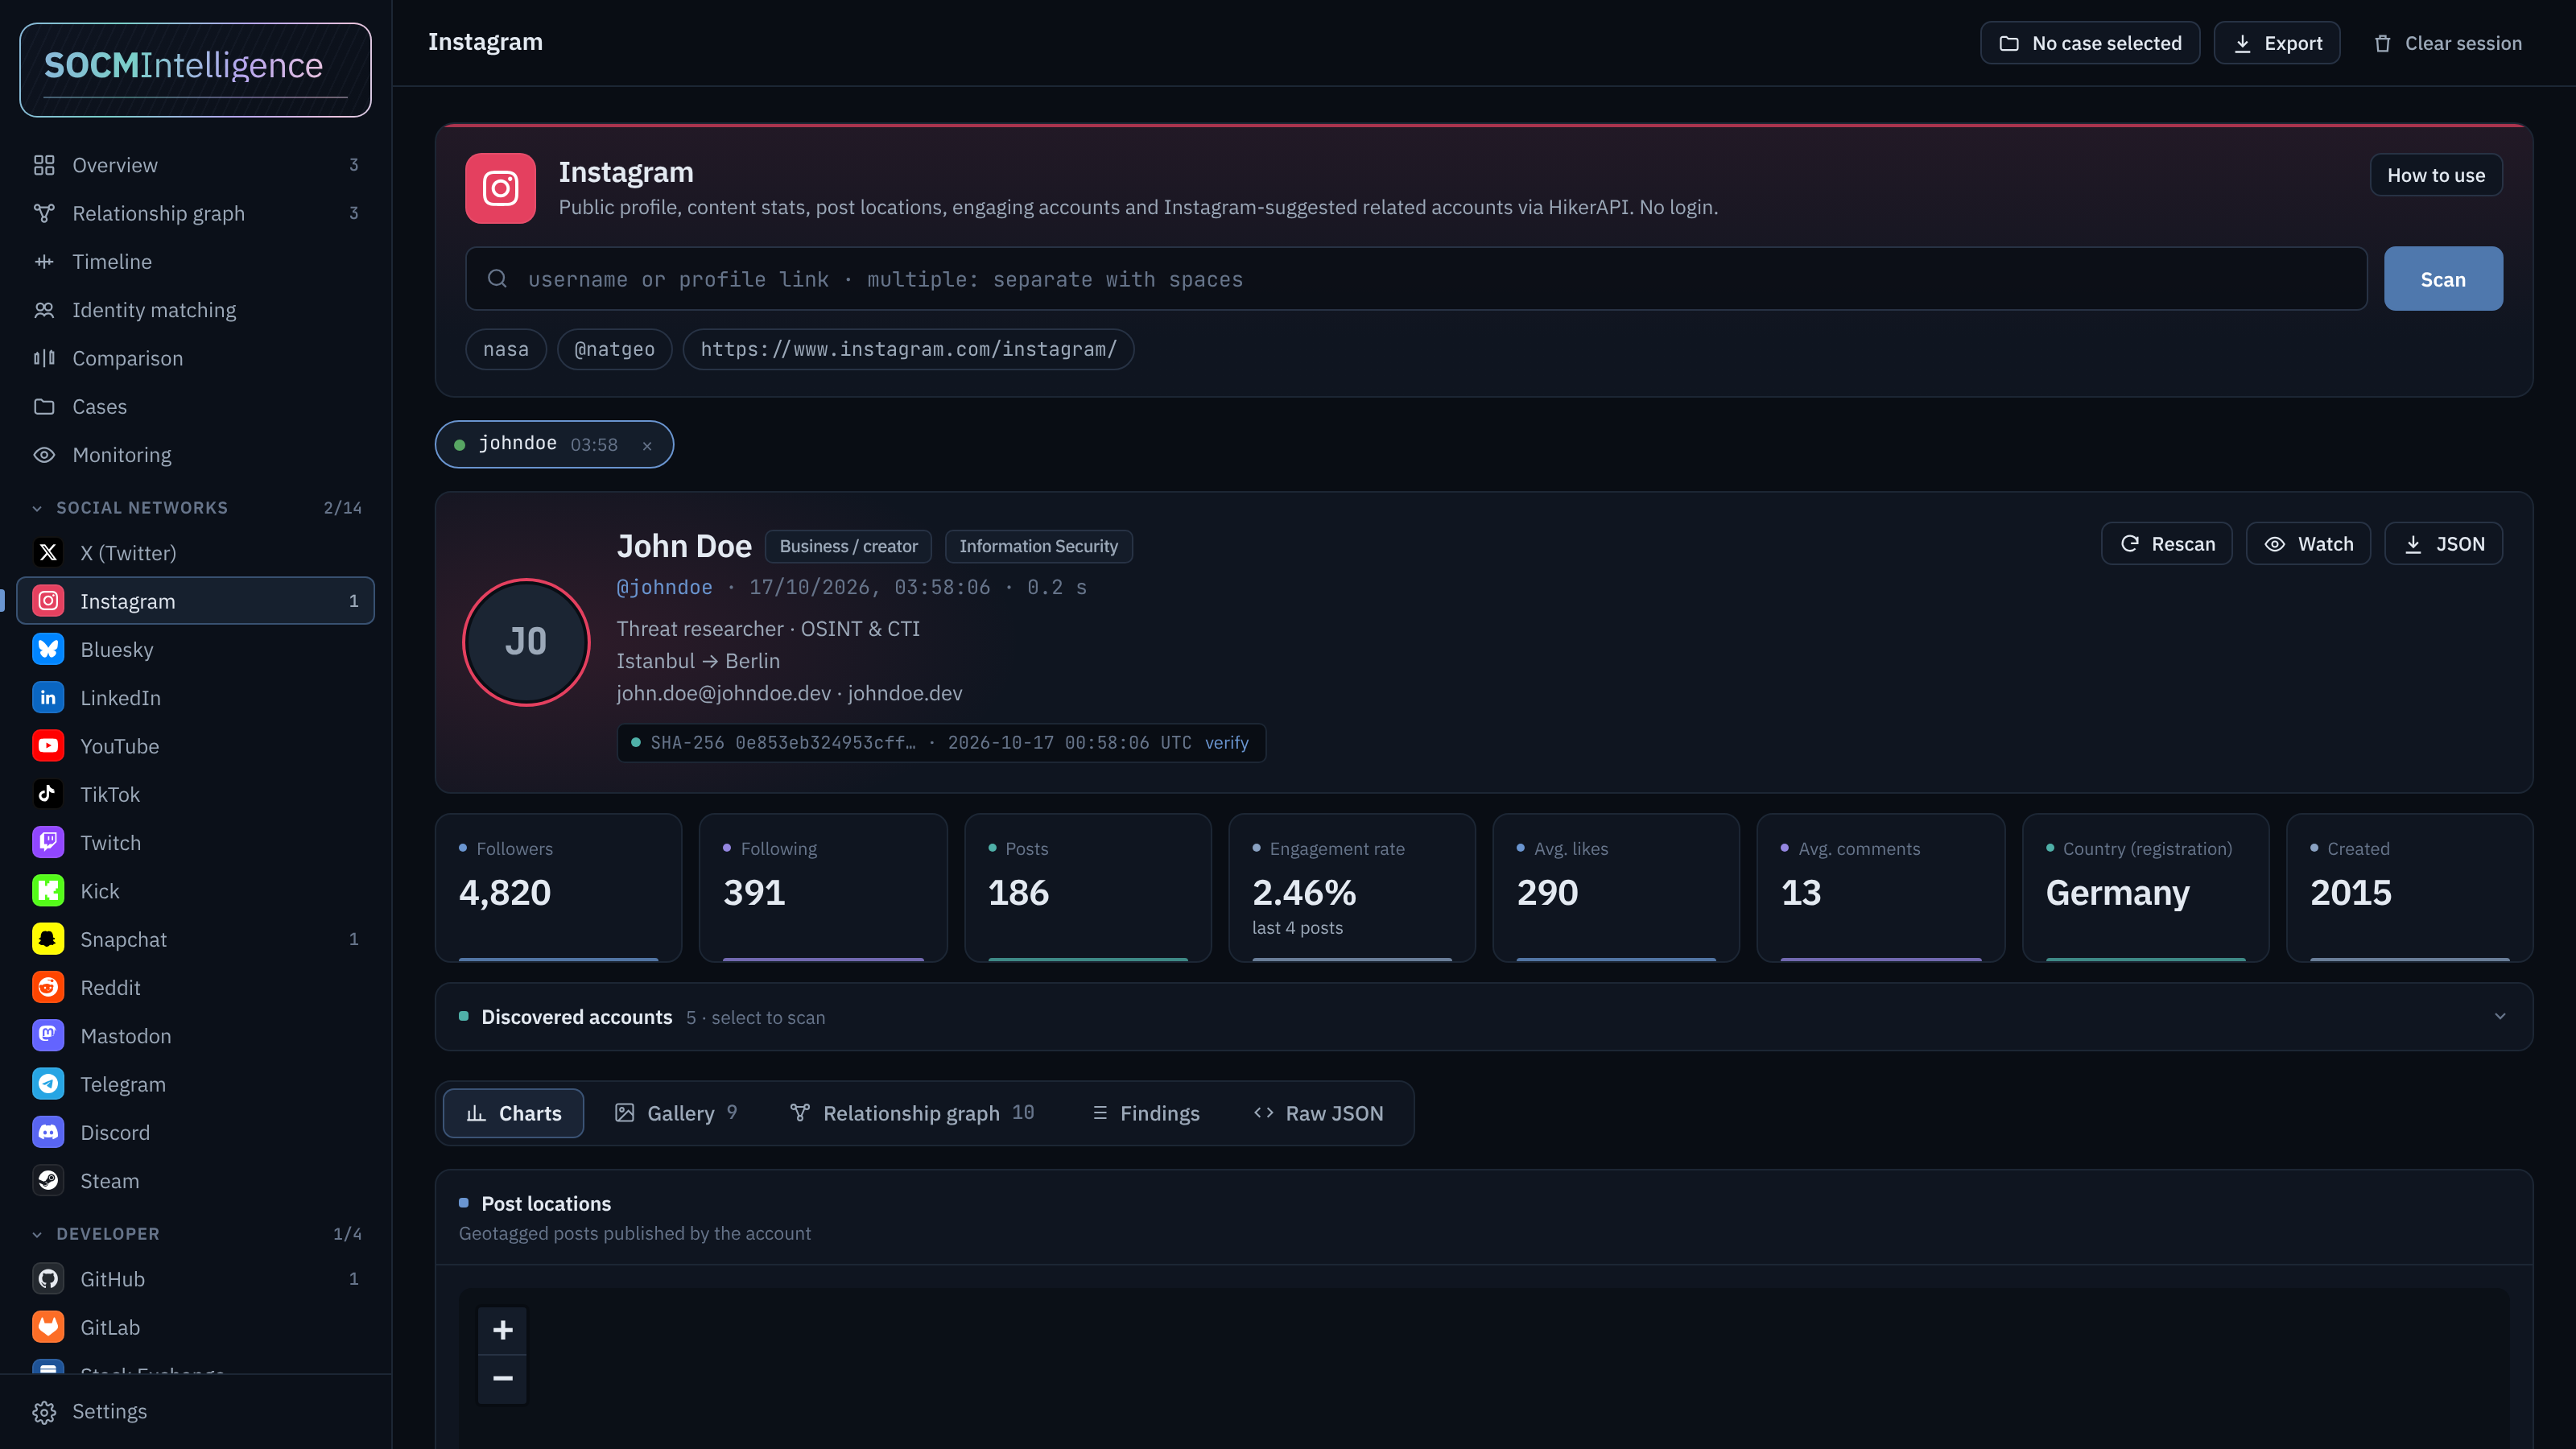
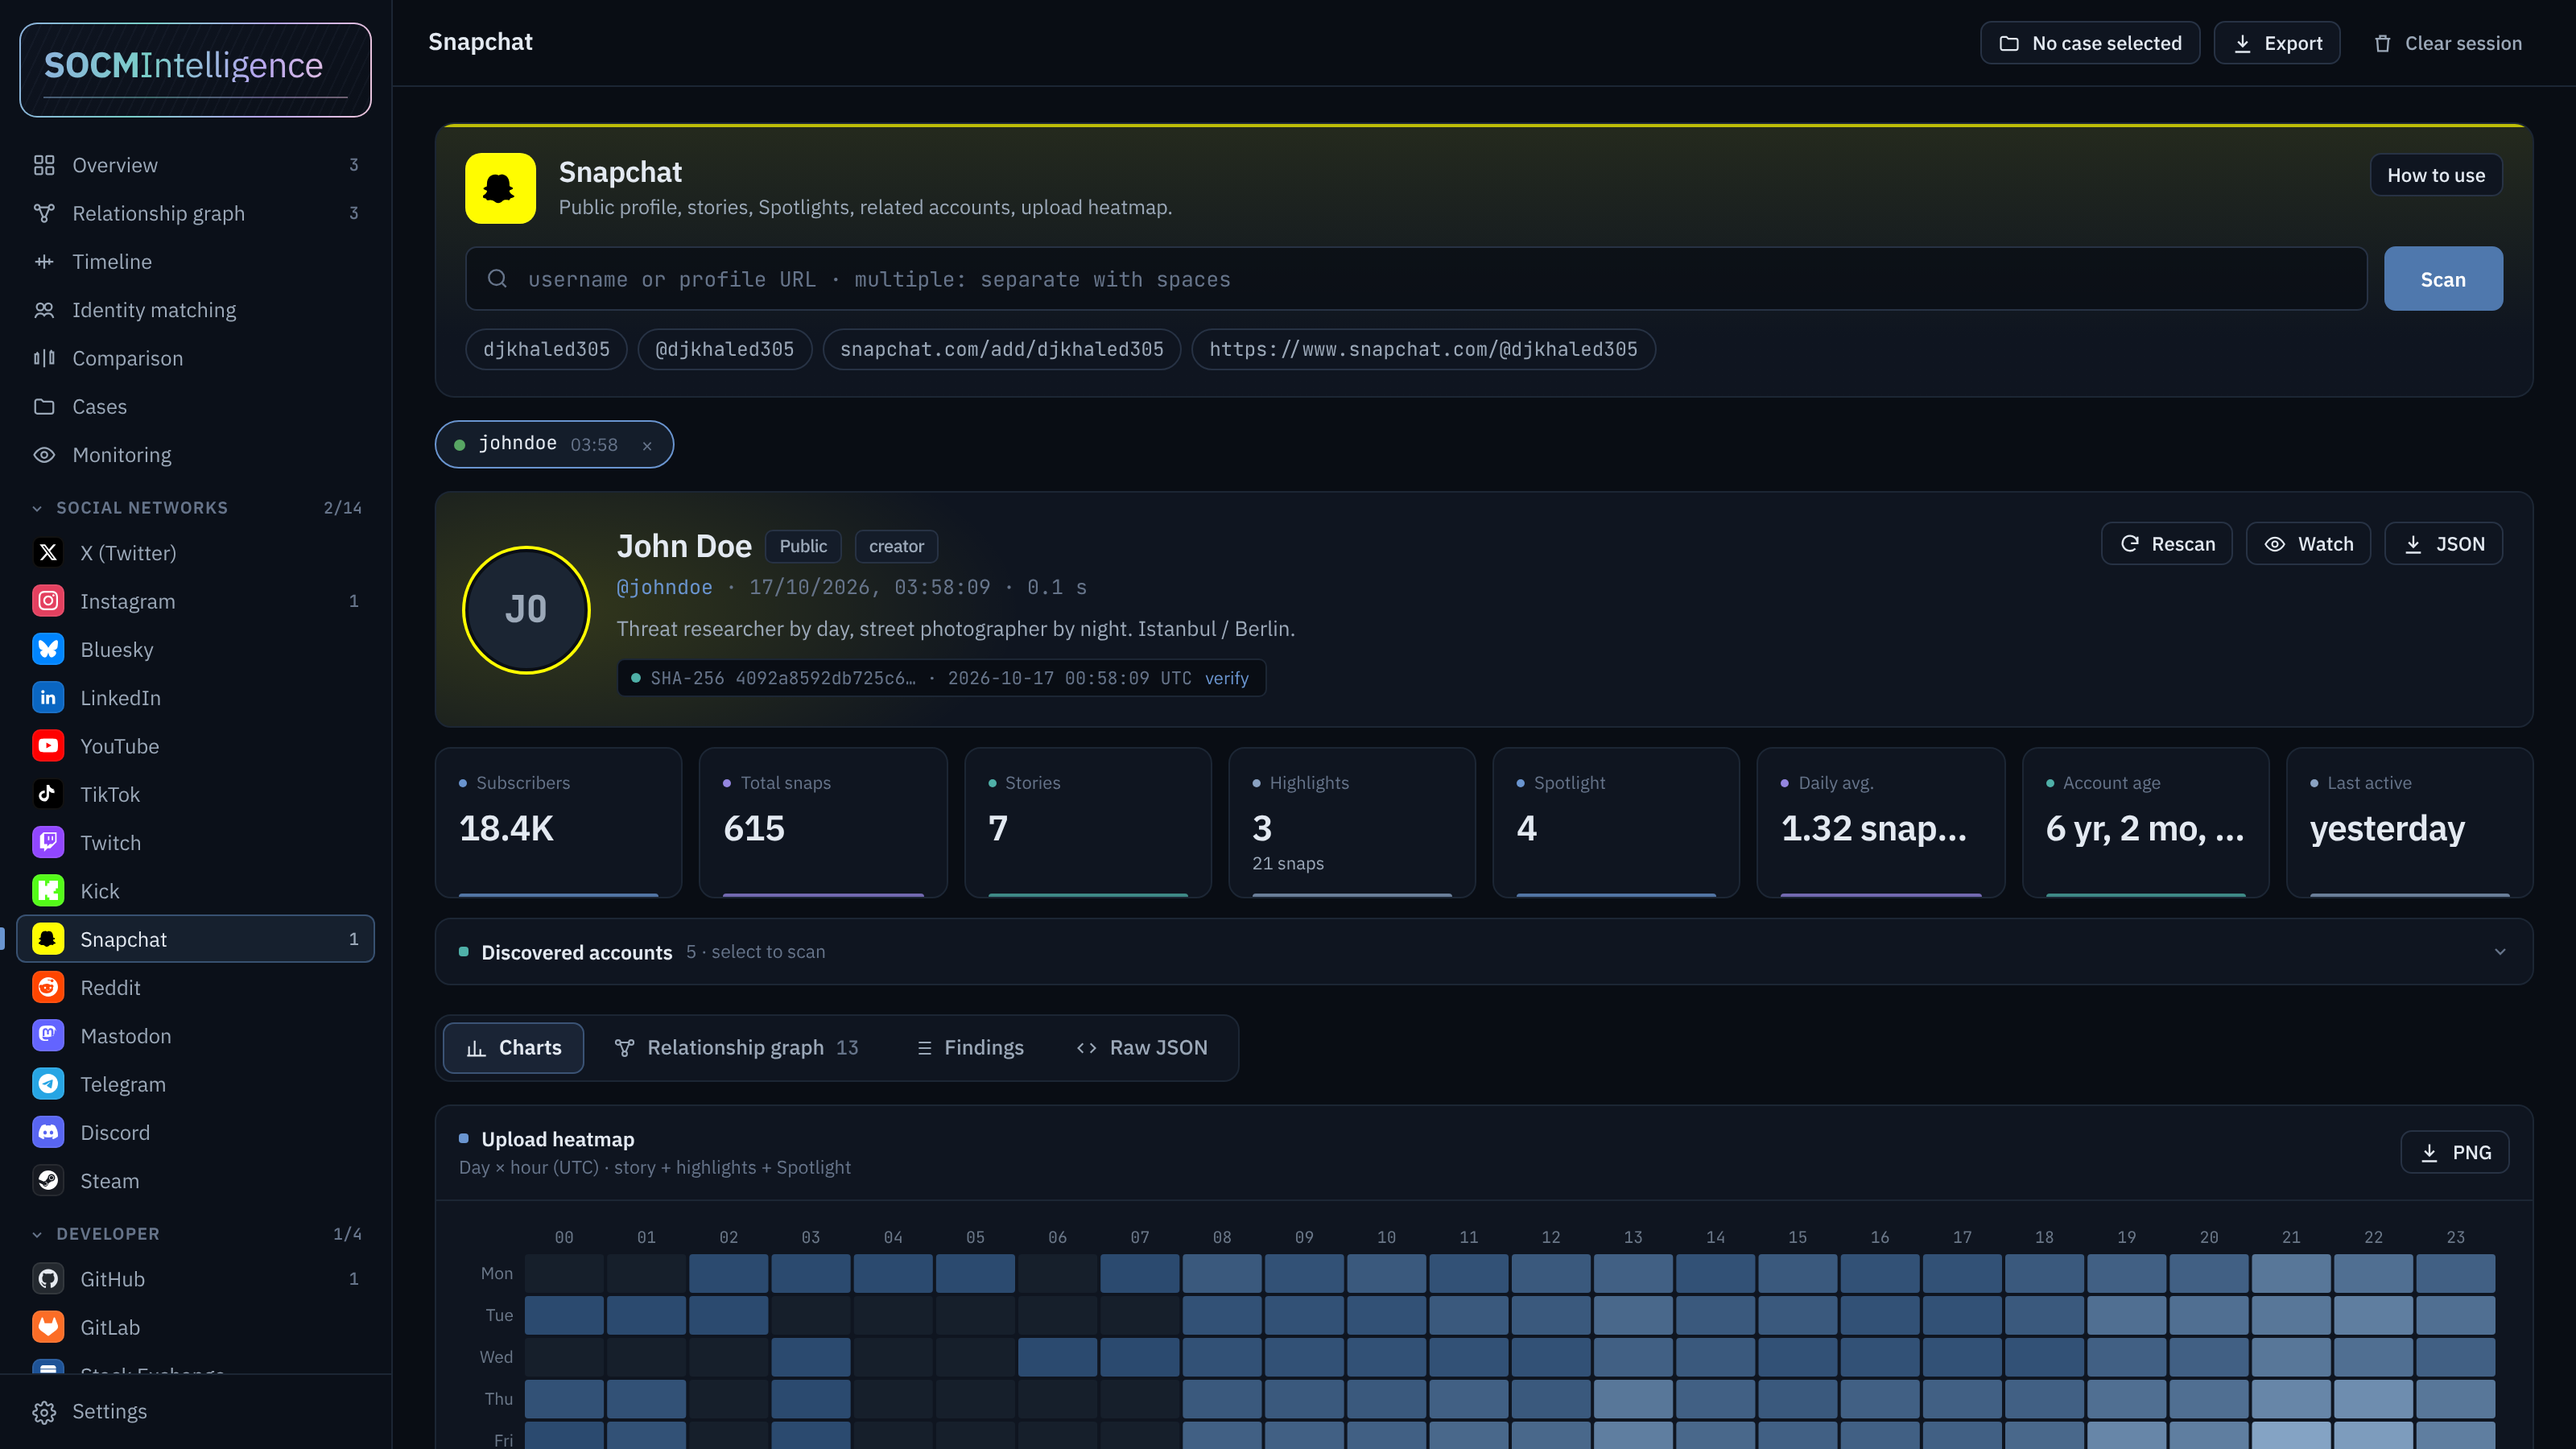
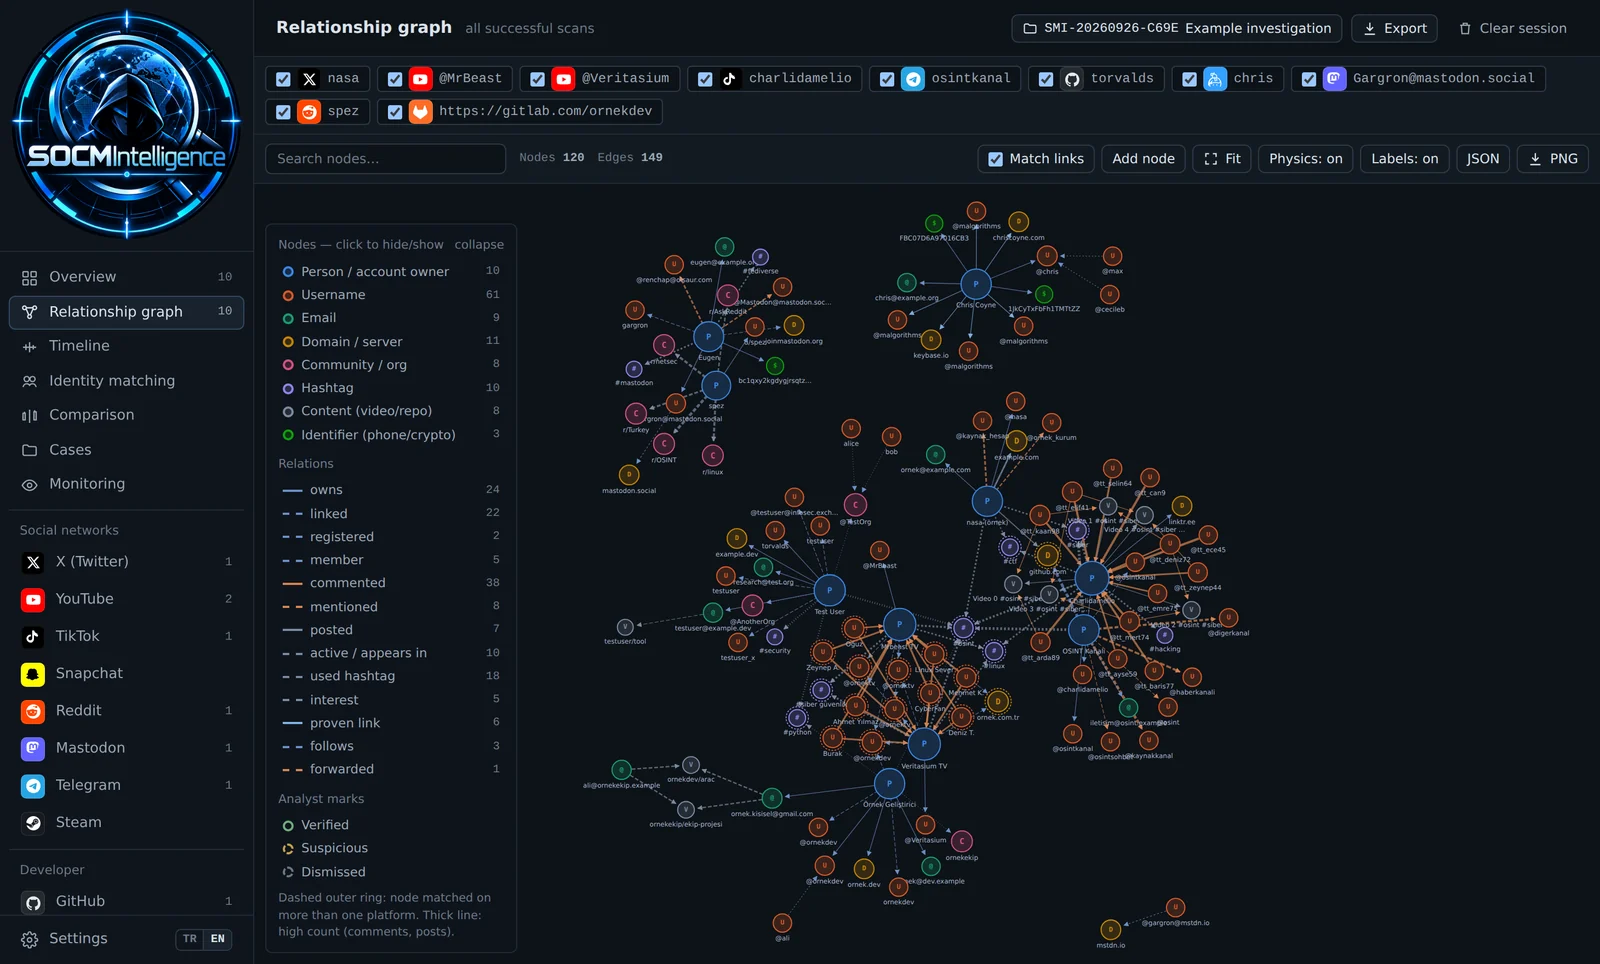
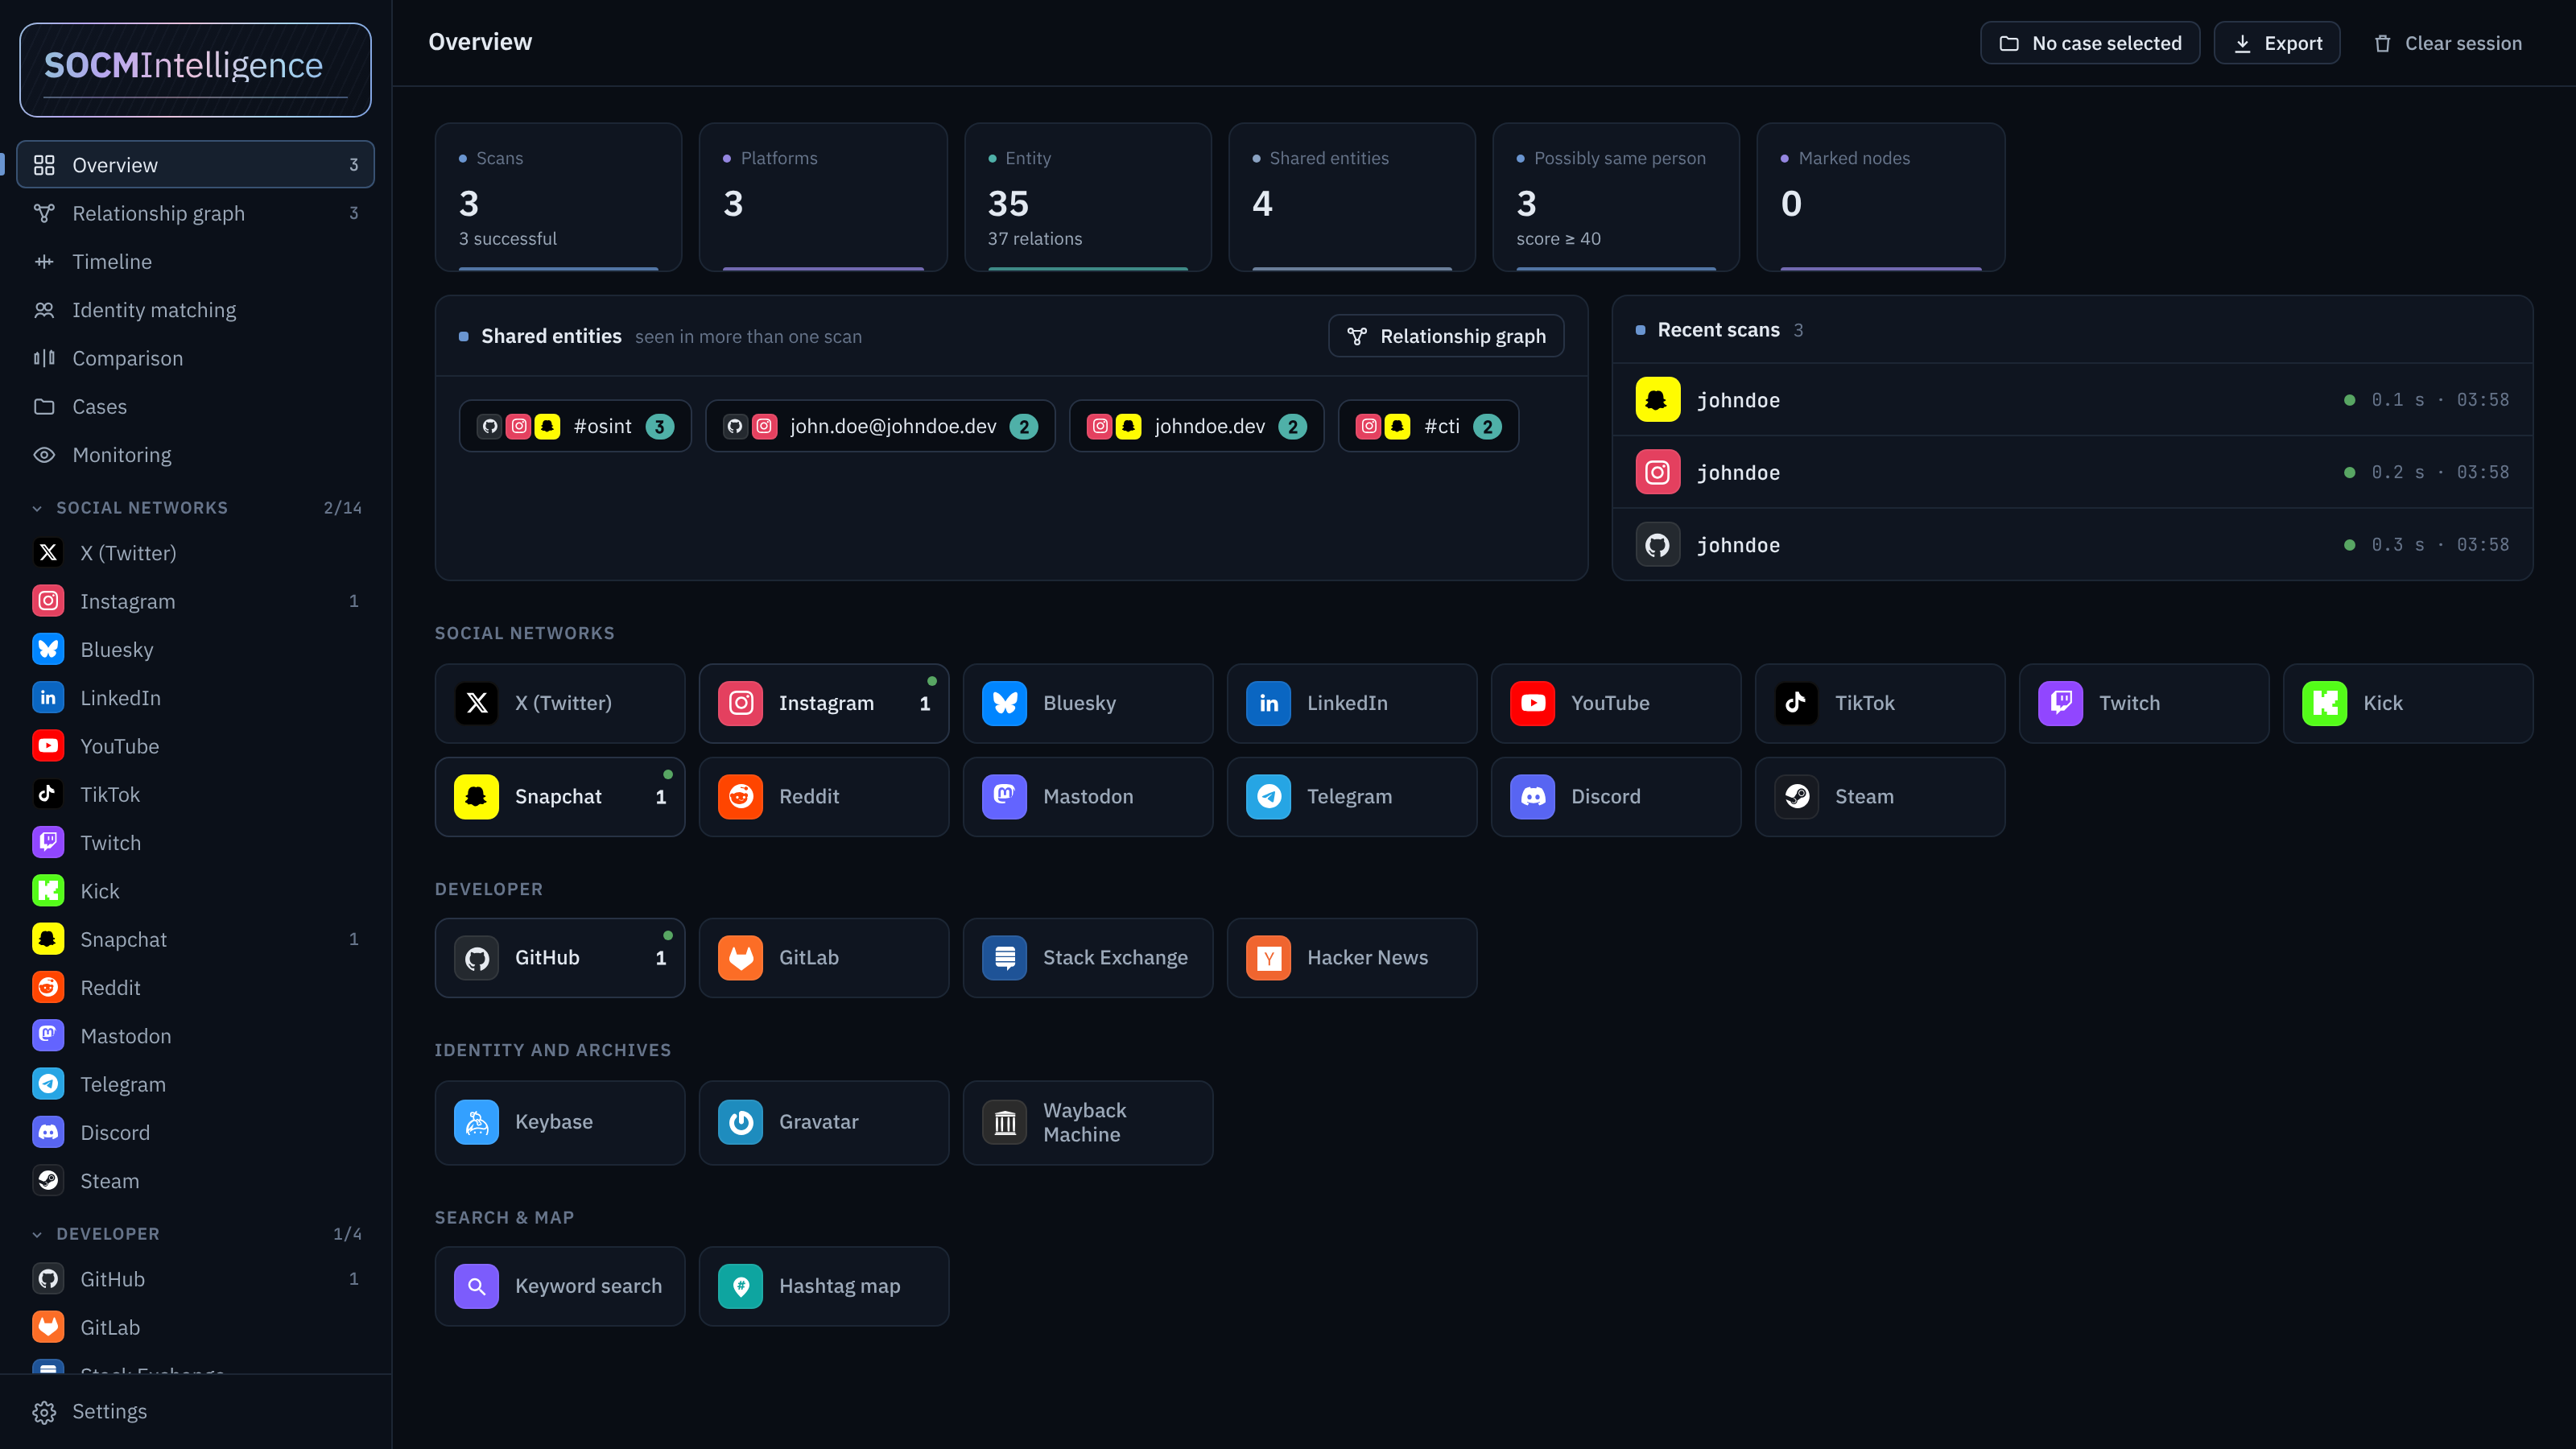
SOCMIntelligence raccoglie dati pubblici da numerose piattaforme, trasforma ogni risultato in grafici, tabelle di riscontri e un grafo delle relazioni, e unisce il tutto in un unico grafo di identità multipiattaforma. Poiché lo stesso account riceve lo stesso ID nodo ovunque, un'email, un dominio o un nome utente che compare in due scansioni diverse viene collegato automaticamente — così puoi vedere chi è chi tra i vari servizi.
Moduli
| Gruppo | Moduli |
|---|
| Social network | X (Twitter) · Instagram · Bluesky · LinkedIn · YouTube · TikTok · Twitch · Kick · Snapchat · Reddit · Mastodon · Telegram · Discord · Steam |
| Sviluppatori | GitHub · GitLab · Stack Exchange · Hacker News |
| Identità e archivi | Keybase · Gravatar · Wayback Machine |
| Ricerca e mappa | Ricerca per parola chiave (Bluesky · Reddit · Mastodon) · Mappa degli hashtag |
Ogni modulo legge solo dati pubblici (o un'API ufficiale quando viene fornita una chiave). Non è previsto lo scraping di credenziali/sessioni di account privati.
Funzionalità
- Grafo delle relazioni — un grafo force-directed D3 che unisce ogni scansione riuscita. Corrispondenze multipiattaforma (email, dominio, nome utente condivisi), pivoting (doppio clic su un nodo per scansionarlo nel modulo corretto), ricerca, filtri per tipo, esportazione PNG/JSON.
- Timeline — i post, i commenti, i caricamenti e gli eventi di creazione account di ogni account su un unico asse, più una heatmap della sovrapposizione oraria e una tabella di similarità oraria.
- Corrispondenza delle identità — un punteggio 0–100 "stessa persona?" per ogni coppia di account con le relative motivazioni (collegamento verificato/crittografico, email condivisa, similarità di nome utente e nome visualizzato, dominio personale condiviso, pHash dell'avatar, ore di attività). Le coppie con punteggio ≥ 40 vengono disegnate sul grafo.
- Confronto — metti a confronto 2 o più account scansionati dello stesso modulo (tabella KPI + grafico a barre, valore più alto evidenziato).
- Annotazioni dell'analista — contrassegna i nodi del grafo come Verificato / Sospetto / Archiviato, aggiungi note, aggiungi nodi e collegamenti manuali. Tutto salvato nel caso.
- Gestione dei casi — crea un caso, attivalo, e scansioni/annotazioni/note vengono salvate automaticamente. Importa/esporta un pacchetto
.socmint.
- Monitoraggio delle modifiche (Monitoring) — riesegui le scansioni dei target secondo una pianificazione e registra ciò che è cambiato (campi, collegamenti aggiunti/rimossi).
- Integrità delle prove — i dati grezzi di ogni scansione vengono sottoposti a hash (SHA-256 su JSON canonico) al momento della raccolta; un pulsante di verifica dimostra se sono stati alterati.
- Esportazioni — report HTML / PDF, Excel (.xlsx), GraphML (Gephi/yEd), GEXF (Gephi), CSV Maltego, JSON.
- Interfaccia in inglese — l'intera interfaccia, i report, i fogli di calcolo e le etichette dei grafici sono in inglese.
- Pagina delle impostazioni — chiavi API, proxy / Tor / rotazione di liste di proxy e limiti di frequenza, tutto gestito dall'interfaccia invece che da
.env.
Installazione
pipx (consigliato su Linux)
pipx install socmintelligence
socmintelligence
o con pip all'interno di un virtualenv:
pip install socmintelligence
socmintelligence
Poi apri http://localhost:8000. Opzioni: socmintelligence --host 0.0.0.0 --port 8000 --data-dir ~/socmint-data --no-browser.
I dati (casi, impostazioni) sono memorizzati in ~/.local/share/socmintelligence a meno che non siano impostati --data-dir o SOCMINT_DATA_DIR.
Direttamente da GitHub: pipx install git+https://github.com/emrekybs/SOCMIntelligence
Avvio rapido (dai sorgenti)
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
uvicorn server:app --host 0.0.0.0 --port 8000
Poi apri http://localhost:8000 — documentazione API su http://localhost:8000/docs.
Le esecuzioni successive richiedono solo:
source .venv/bin/activate && uvicorn server:app --port 8000
Docker: docker compose up --build (servizio singolo).
Configurazione
Tutta la configurazione risiede nella pagina Settings (salvata in data/settings.json; .env viene ancora letto, ma Settings ha la precedenza):
- Chiavi API — memorizzate lato server, mai restituite al browser (vengono mostrati solo "set" + gli ultimi 4 caratteri).
YOUTUBE_API_KEY — necessaria per il modulo YouTube.HIKERAPI_TOKEN — Instagram (HikerAPI). Senza di essa il modulo Instagram mostra dati di esempio chiaramente etichettati.X_BEARER_TOKEN — X (Twitter) API v2. Senza di essa il modulo X mostra dati di esempio chiaramente etichettati, così puoi visualizzare in anteprima l'output prima di aggiungere un token.STEAM_API_KEY, STACKEXCHANGE_KEY, GRAVATAR_API_KEY, GITLAB_TOKEN — opzionali, sbloccano dati aggiuntivi.
- Proxy / Tor — disattivato, Tor, un singolo proxy personalizzato, oppure una lista di proxy che ruota in modalità round-robin a ogni scansione (distribuisce i limiti di frequenza).
- Rate — numero di scansioni parallele e ritardo tra le richieste.
Note
- X (Twitter): il piano gratuito di X è molto limitato — anche con un token, la cronologia dei post può risultare vuota su alcuni piani; il modulo etichetta questo caso.
- Telegram legge solo l'anteprima pubblica
t.me/s/ (nessun login).
- Gravatar riceve solo l'hash MD5/SHA-256 di un'email, mai l'email stessa.
- TikTok applica spesso limiti di frequenza/blocchi bot; il modulo riprova e distingue un vero "non trovato" da un blocco temporaneo.
- Le distribuzioni temporali sono in UTC. La "crescita" dei follower di TikTok è una stima (contrassegnata come tale), non una cronologia reale.
Licenza
Apache License 2.0 — vedi LICENSE.