
darts v0.47.0
Una libreria Python per previsioni intuitive e rilevamento di anomalie su serie temporali.
Serie Temporali Rese Semplici in Python




Darts è una libreria Python per il forecasting e il rilevamento di anomalie
su serie temporali, pensata per essere facile da usare. Contiene una varietà di modelli, dai classici come ARIMA
alle reti neurali profonde. Tutti i modelli di forecasting possono essere utilizzati allo stesso modo,
tramite le funzioni fit() e predict(), in modo simile a scikit-learn.
La libreria semplifica inoltre il backtesting dei modelli,
la combinazione delle previsioni di più modelli e la considerazione di dati esterni.
Darts supporta sia serie temporali e modelli univariati che multivariati.
I modelli basati su ML possono essere addestrati su dataset potenzialmente grandi contenenti più serie
temporali, e alcuni dei modelli offrono un ricco supporto per il forecasting probabilistico.
Darts offre anche ampie capacità di rilevamento di anomalie. Ad esempio, è banale applicare modelli PyOD su serie temporali per ottenere punteggi di anomalia, oppure incapsulare qualsiasi modello di forecasting o filtraggio di Darts per ottenere modelli di rilevamento di anomalie completi.
Documentazione
Introduzioni di alto livello
Articoli su argomenti selezionati
- Addestrare modelli su più serie temporali
- Utilizzo di covariate passate e future
- Reti convoluzionali temporali e forecasting
- Forecasting probabilistico
- Transfer learning per il forecasting di serie temporali
- Riconciliazione di previsioni gerarchiche
Installazione rapida
Consigliamo di configurare innanzitutto un ambiente Python pulito per il vostro progetto con Python 3.11+ utilizzando il vostro strumento preferito (conda, venv, virtualenv con o senza virtualenvwrapper).
Una volta configurato l'ambiente, potete installare darts usando pip:
pip install darts
Per maggiori dettagli potete consultare le nostre istruzioni di installazione.
Esempio di utilizzo
Forecasting
Create un oggetto TimeSeries da un Pandas DataFrame e dividetelo in serie di training/validation:
import pandas as pd
from darts import TimeSeries

# Read a pandas DataFrame
df = pd.read_csv("AirPassengers.csv", delimiter=",")

# Create a TimeSeries, specifying the time and value columns
series = TimeSeries.from_dataframe(df, "Month", "#Passengers")

# Set aside the last 36 months as a validation series
train, val = series[:-36], series[-36:]
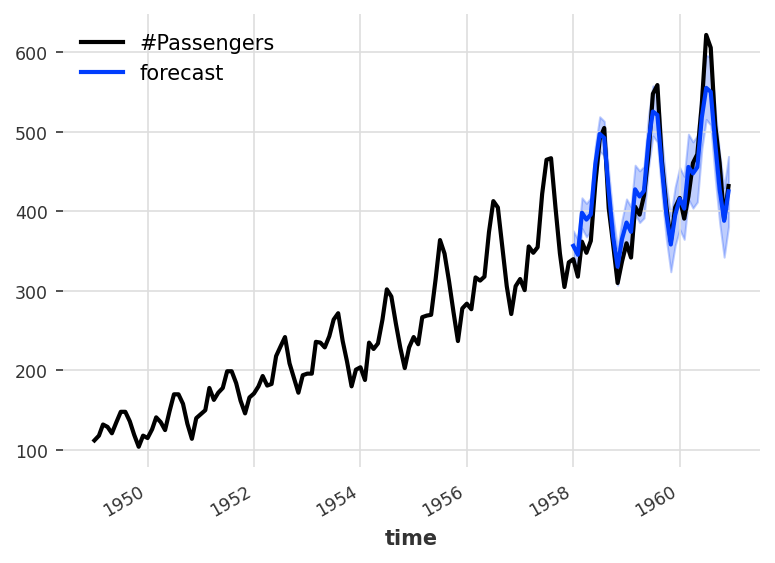
Adatta un modello di smoothing esponenziale e fai una previsione (probabilistica) sulla durata della serie di validazione:
from darts.models import ExponentialSmoothing

model = ExponentialSmoothing()
model.fit(train)
prediction = model.predict(len(val), num_samples=1000)
Traccia la mediana, il 5° e il 95° percentile:
import matplotlib.pyplot as plt

series.plot()
prediction.plot(label="forecast", low_quantile=0.05, high_quantile=0.95)
plt.legend()
Rilevamento delle anomalie
Carica una serie multivariata, ritagliala, mantieni 2 componenti, suddividi i set di addestramento e validazione:
from darts.datasets import ETTh2Dataset

series = ETTh2Dataset().load()[:10000][["MUFL", "LULL"]]
train, val = series.split_before(0.6)
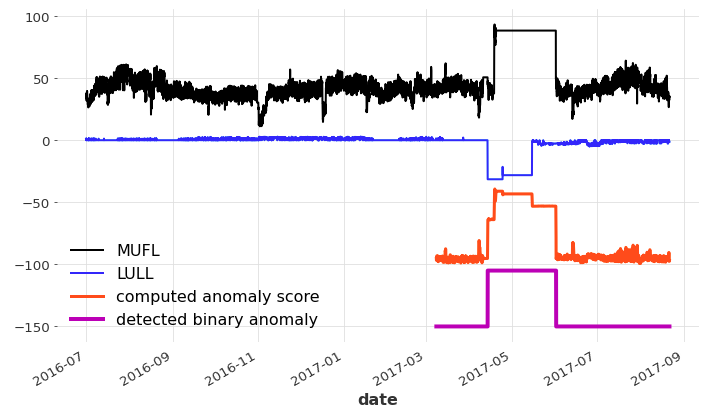
Costruisci uno scorer di anomalie k-means, addestralo sul set di addestramento e usalo sul set di validazione per ottenere i punteggi di anomalia:
from darts.ad import KMeansScorer

scorer = KMeansScorer(k=2, window=5)
scorer.fit(train)
anom_score = scorer.score(val)
Crea un rilevatore di anomalie binarie e addestralo sui punteggi di training, poi usalo sui punteggi di validazione per ottenere una classificazione binaria delle anomalie:
from darts.ad import QuantileDetector

detector = QuantileDetector(high_quantile=0.99)
detector.fit(scorer.score(train))
binary_anom = detector.detect(anom_score)
Traccia (spostando e scalando alcune delle serie per far apparire tutto sulla stessa figura):
import matplotlib.pyplot as plt

series.plot()
(anom_score / 2. - 100).plot(label="computed anomaly score", c="orangered", lw=3)
(binary_anom * 45 - 150).plot(label="detected binary anomaly", lw=4)
Funzionalità
- Modelli di Previsione: Un'ampia collezione di modelli di previsione per attività di regressione e classificazione; dai modelli statistici (come ARIMA) ai modelli di deep learning (come N-BEATS). Vedi i modelli di previsione di seguito.