 ut-security/cve-2023-5217-poc
ब्राउज़र WebCodecs या MediaRecorder इंटरफ़ेस से CVE-2023-5217 को ट्रिगर करने के लिए एक PoC।

CVE-2023-5217 एक in-the-wild शोषित libvpx कमजोरी है जो Google के थ्रेट एनालिसिस ग्रुप के Clément Lecigne द्वारा Chrome को लक्षित करने के लिए पाई गई थी।
यह रिपॉजिटरी WebCodecs और MediaRecorder API का उपयोग करके ब्राउज़र में CVE-2023-5217 को ट्रिगर करने का तरीका दिखाती है। CVE-2023-5217 एक नियंत्रित ओवरफ़्लो लंबाई और एक बार-बार छोटे 4-बाइट मान के ओवरराइट के साथ हीप बफर ओवरफ़्लो की अनुमति देता है। यह वर्तमान में ज्ञात नहीं है कि CVE-2023-5217 का जंगली में कैसे शोषण किया गया।
सार्वजनिक प्रकटीकरण के समय, libvpx में दो पैच और Chromium में एक पैच थे जिन्होंने CVE-2023-5217 को ठीक किया। libvpx पैच में VP8 थ्रेड संख्या परिवर्तनों को अक्षम करना और मल्टीथ्रेडेड एन्कोडिंग के लिए एक परीक्षण शामिल था। Chromium पैच ने WebCodecs में थ्रेड्स की संख्या को समायोजित करना अक्षम कर दिया।
libvpx एक लाइब्रेरी है जो VP8/VP9 एन्कोडिंग और डिकोडिंग को संभालती है।
CVE-2023-5217 में मुख्य समस्या यह है कि libvpx VP8 एन्कोडिंग सत्र में फ्रेम की ऊंचाई बढ़ाते समय थ्रेड्स की संख्या कम करने से एक नियंत्रित लंबाई का रैखिक हीप ओवरफ़्लो और एक बार-बार छोटे 4-बाइट मान का नियंत्रित ओवरराइट होता है। फ्रेम की ऊंचाई में अंतर ओवरराइट की लंबाई को नियंत्रित करता है, और नई फ्रेम चौड़ाई उस 4-बाइट मान को नियंत्रित करती है जो बार-बार लिखा जाता है। इस कमजोरी का कई बार शोषण किया जा सकता है ताकि प्रत्येक बाद के कॉन्फ़िग में ऊंचाई कम करके लगातार अलग-अलग छोटे 4-बाइट मान लिखे जा सकें।
libvpx VP8 एन्कोडर mt_current_mb_col नामक एक ऐरे बनाए रखता है जो एन्कोडर थ्रेड द्वारा काम किए जा रहे वर्तमान कॉलम को संग्रहीत करता है। यह ऐरे केवल तभी आवंटित होता है जब एक से अधिक थ्रेड हों, और इसका आकार mb_rows का फलन है, जहाँ mb_rows = frame_height >> 4 और frame_height को निकटतम 16 के गुणज में पूर्णांकित किया जाता है।
// https://github.com/webmproject/libvpx/blob/6512f994da13e2f27e6a7bd449efee0a374b55b7/vp8/common/alloccommon.c#L85
// The width and height are rounded up to a multiple of 16 and then assigned to `mb_rows` and `mb_cols`
int vp8_alloc_frame_buffers(VP8_COMMON *oci, int width, int height) {
    ...
    // Round up the width/height up to the nearest multiple of 16
    if ((width & 0xf) != 0) width += 16 - (width & 0xf);
    if ((height & 0xf) != 0) height += 16 - (height & 0xf);
    ...
    oci->mb_rows = height >> 4;
    oci->mb_cols = width >> 4;
    ...
}
// https://github.com/webmproject/libvpx/blob/6512f994da13e2f27e6a7bd449efee0a374b55b7/vp8/encoder/onyx_if.c#L1232
// This snippet shows the allocation of `mt_current_mb_col`
void vp8_alloc_compressor_data(VP8_COMP *cpi) {
  ...
  // Only allocate if we have more than 1 thread
  if (cpi->oxcf.multi_threaded > 1) {
    int i;

    vpx_free(cpi->mt_current_mb_col);
    // sizeof(*cpi->mt_current_mb_col) is 4
    CHECK_MEM_ERROR(&cpi->common.error, cpi->mt_current_mb_col,
                    vpx_malloc(sizeof(*cpi->mt_current_mb_col) * cm->mb_rows));
    for (i = 0; i < cm->mb_rows; ++i)
      vpx_atomic_init(&cpi->mt_current_mb_col[i], 0);
  }
  ...
}
जब libvpx एक फ्रेम को एन्कोड करना समाप्त करता है, तो यह mt_current_mb_col में एन्कोड किए गए कॉलमों की संख्या और mt_sync_range को संग्रहीत करता है।
// https://github.com/webmproject/libvpx/blob/6512f994da13e2f27e6a7bd449efee0a374b55b7/vp8/encoder/onyx_if.c#L1212
// Snippet where the mt_sync_range value is set, based on the width.
void vp8_alloc_compressor_data(VP8_COMP *cpi) {
    ...
#if CONFIG_MULTITHREAD
  if (width < 640) {
    cpi->mt_sync_range = 1;
  } else if (width <= 1280) {
    cpi->mt_sync_range = 4;
  } else if (width <= 2560) {
    cpi->mt_sync_range = 8;
  } else {
    cpi->mt_sync_range = 16;
  }
#endif
  ...
}
// https://github.com/webmproject/libvpx/blob/6512f994da13e2f27e6a7bd449efee0a374b55b7/vp8/encoder/encodeframe.c#L560
// Function where the attacker chosen value is written
static void encode_mb_row(...) {
  ...
  const int nsync = cpi->mt_sync_range; // This value is set in vp8_alloc_compressor_data
  vpx_atomic_int rightmost_col = VPX_ATOMIC_INIT(cm->mb_cols + nsync);
  ...
  if (vpx_atomic_load_acquire(&cpi->b_multi_threaded) != 0) {
    current_mb_col = &cpi->mt_current_mb_col[mb_row];
  }
  ...
  if (vpx_atomic_load_acquire(&cpi->b_multi_threaded) != 0) {
    // current_mb_col is a reference to mt_current_mb_col
    vpx_atomic_store_release(current_mb_col,
                             vpx_atomic_load_acquire(&rightmost_col));
  }
  ...
}
mt_current_mb_col को ओवरफ़्लो करने के लिए, हमें तीन एन्कोडिंग कॉन्फ़िगरेशन की आवश्यकता है:
mt_current_mb_col आवंटन बनाता है। यह नई ऊंचाई configinit.initial_height से छोटी होनी चाहिए अन्यथा हमें एक त्रुटि मिलेगी।mt_current_mb_col को पुनः आवंटित नहीं करेगा, इसे संवेदनशील स्थिति में छोड़ देगा। libvpx बार-बार पहले से आवंटित सीमाओं के बाहर (configattack.width >> 4) + 1 मान (जहाँ 1 चर mt_sync_range है और चौड़ाई निकटतम 16 के गुणज में पूर्णांकित की जाती है) लिखेगा जब निम्नलिखित शर्त पूरी होती है:\text{ceil}(\text{config}_{\text{init}}.\text{height}/16) \geq \text{ceil}(\text{config}_{\text{attack}}.\text{height}/16) \gt \text{ceil}(\text{config}_{\text{vuln}}.\text{height}/16)$$
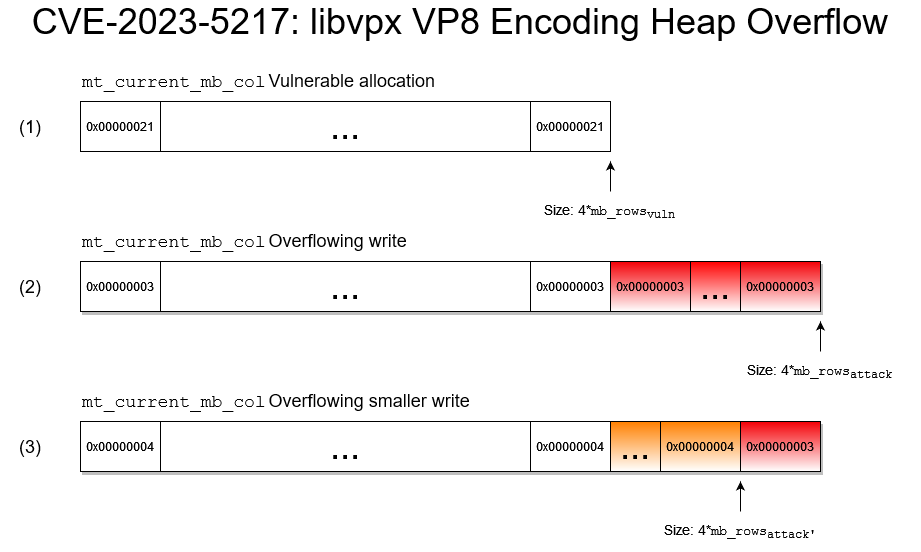
अधिक ठोस रूप से, मान लें कि हम configinit के साथ width = 1200, height = 1200, threads = 4 के साथ एक VP8 एन्कोडिंग कॉन्फ़िगरेशन प्रारंभ करते हैं। हमला इस प्रकार है:
mb_rows को 704/16=44 पर सेट किया जाता है, और ऐरे mt_current_mb_col को (44)*4 = 176 बाइट्स में आवंटित किया जाता है। mt_current_mb_col में लिखा गया मान 512/16 + 1 = 33 है।mt_current_mb_col केवल तभी पुनः आवंटित होता है जब एक से अधिक थ्रेड हों, यह उसी आकार में रहता है, फिर भी mb_rows अब 1008/16 = 63 पर सेट हो गया है। जब libvpx encode_mb_row को कॉल करता है, तो यह mt_current_mb_col आवंटन से (63-44)*4 = 68 बाइट्स आगे ओवरराइट करेगा, बार-बार मान 32/16 + 1 = 3 लिखता है, जहाँ 32 round-up की गई चौड़ाई है, और 1 mt_sync_range मान है।mb_rows = 992/16 = 62 और mb_cols = 48/16 = 3 सेट करके, मूल आवंटन से केवल (62-44)*4 = 64 बाइट्स आगे मान 4 लिखता है।