 ucsb-mlsec/vulnllm-r
स्रोत-कोड भेद्यता का पता लगाने के लिए C/C++ और Python में विशेषीकृत रीज़निंग LLM, जिसमें डेटासेट निर्माण, SFT/DPO प्रशिक्षण और परिणाम-पुनरुत्पादन स्क्रिप्ट शामिल हैं।

git lfs install          # one-time setup
git clone https://github.com/ucsb-mlsec/VulnLLM-R.git
cd VulnLLM-R
# If you cloned before installing Git LFS, run: git lfs pull
conda create -n vulnscan python=3.11
conda activate vulnscan
pip install -e . -e ./vulscan/train/LLaMA-Factory -e ./vulscan/model_zoo
# generate VulnLLM-R-7B's results
python -m vulscan.test.test --output_dir results/test_data --dataset_path ./datasets/test/function_level/ ./datasets/test/repo_level/ --language python c java --model UCSB-SURFI/VulnLLM-R-7B --requests_per_minute 1000 --save --use_cot --batch_size 4 --tp 2 --vllm --max_tokens 8192 --random_cwe

python -m vulscan.test.test_hf \
      --output_dir results/test_hf \
      --hf_dataset UCSB-SURFI/VulnLLM-R-Test-Data \
      --hf_split repo_level function_level \
      --language c python java \
      --model UCSB-SURFI/VulnLLM-R-7B \
      --save --use_cot --vllm --tp 2

# [optional] generate other models' results with our shell script
# remember to add your API keys to .env file if you want to run commercial models
# use ./run_test.sh -h for more options
./vulscan/test/run_test.sh -o results/test_data -t 2 # -o means output directory, -t means tensor parallelism
./vulscan/test/run_test.sh -o results/test_data -M o3-mini # -M means model name, which runs only one model.
./vulscan/test/run_test.sh -o results/test_data -M gpt-5.4 -e high # -e sets reasoning effort (e.g., none/low/medium/high/xhigh)
./vulscan/test/run_test.sh -o results/test_data -M claude-opus-4-6 -e high

# [optional] draw plot to compare with other models
python plots/plot_language_comparison_models.py --results-dir results/test_data
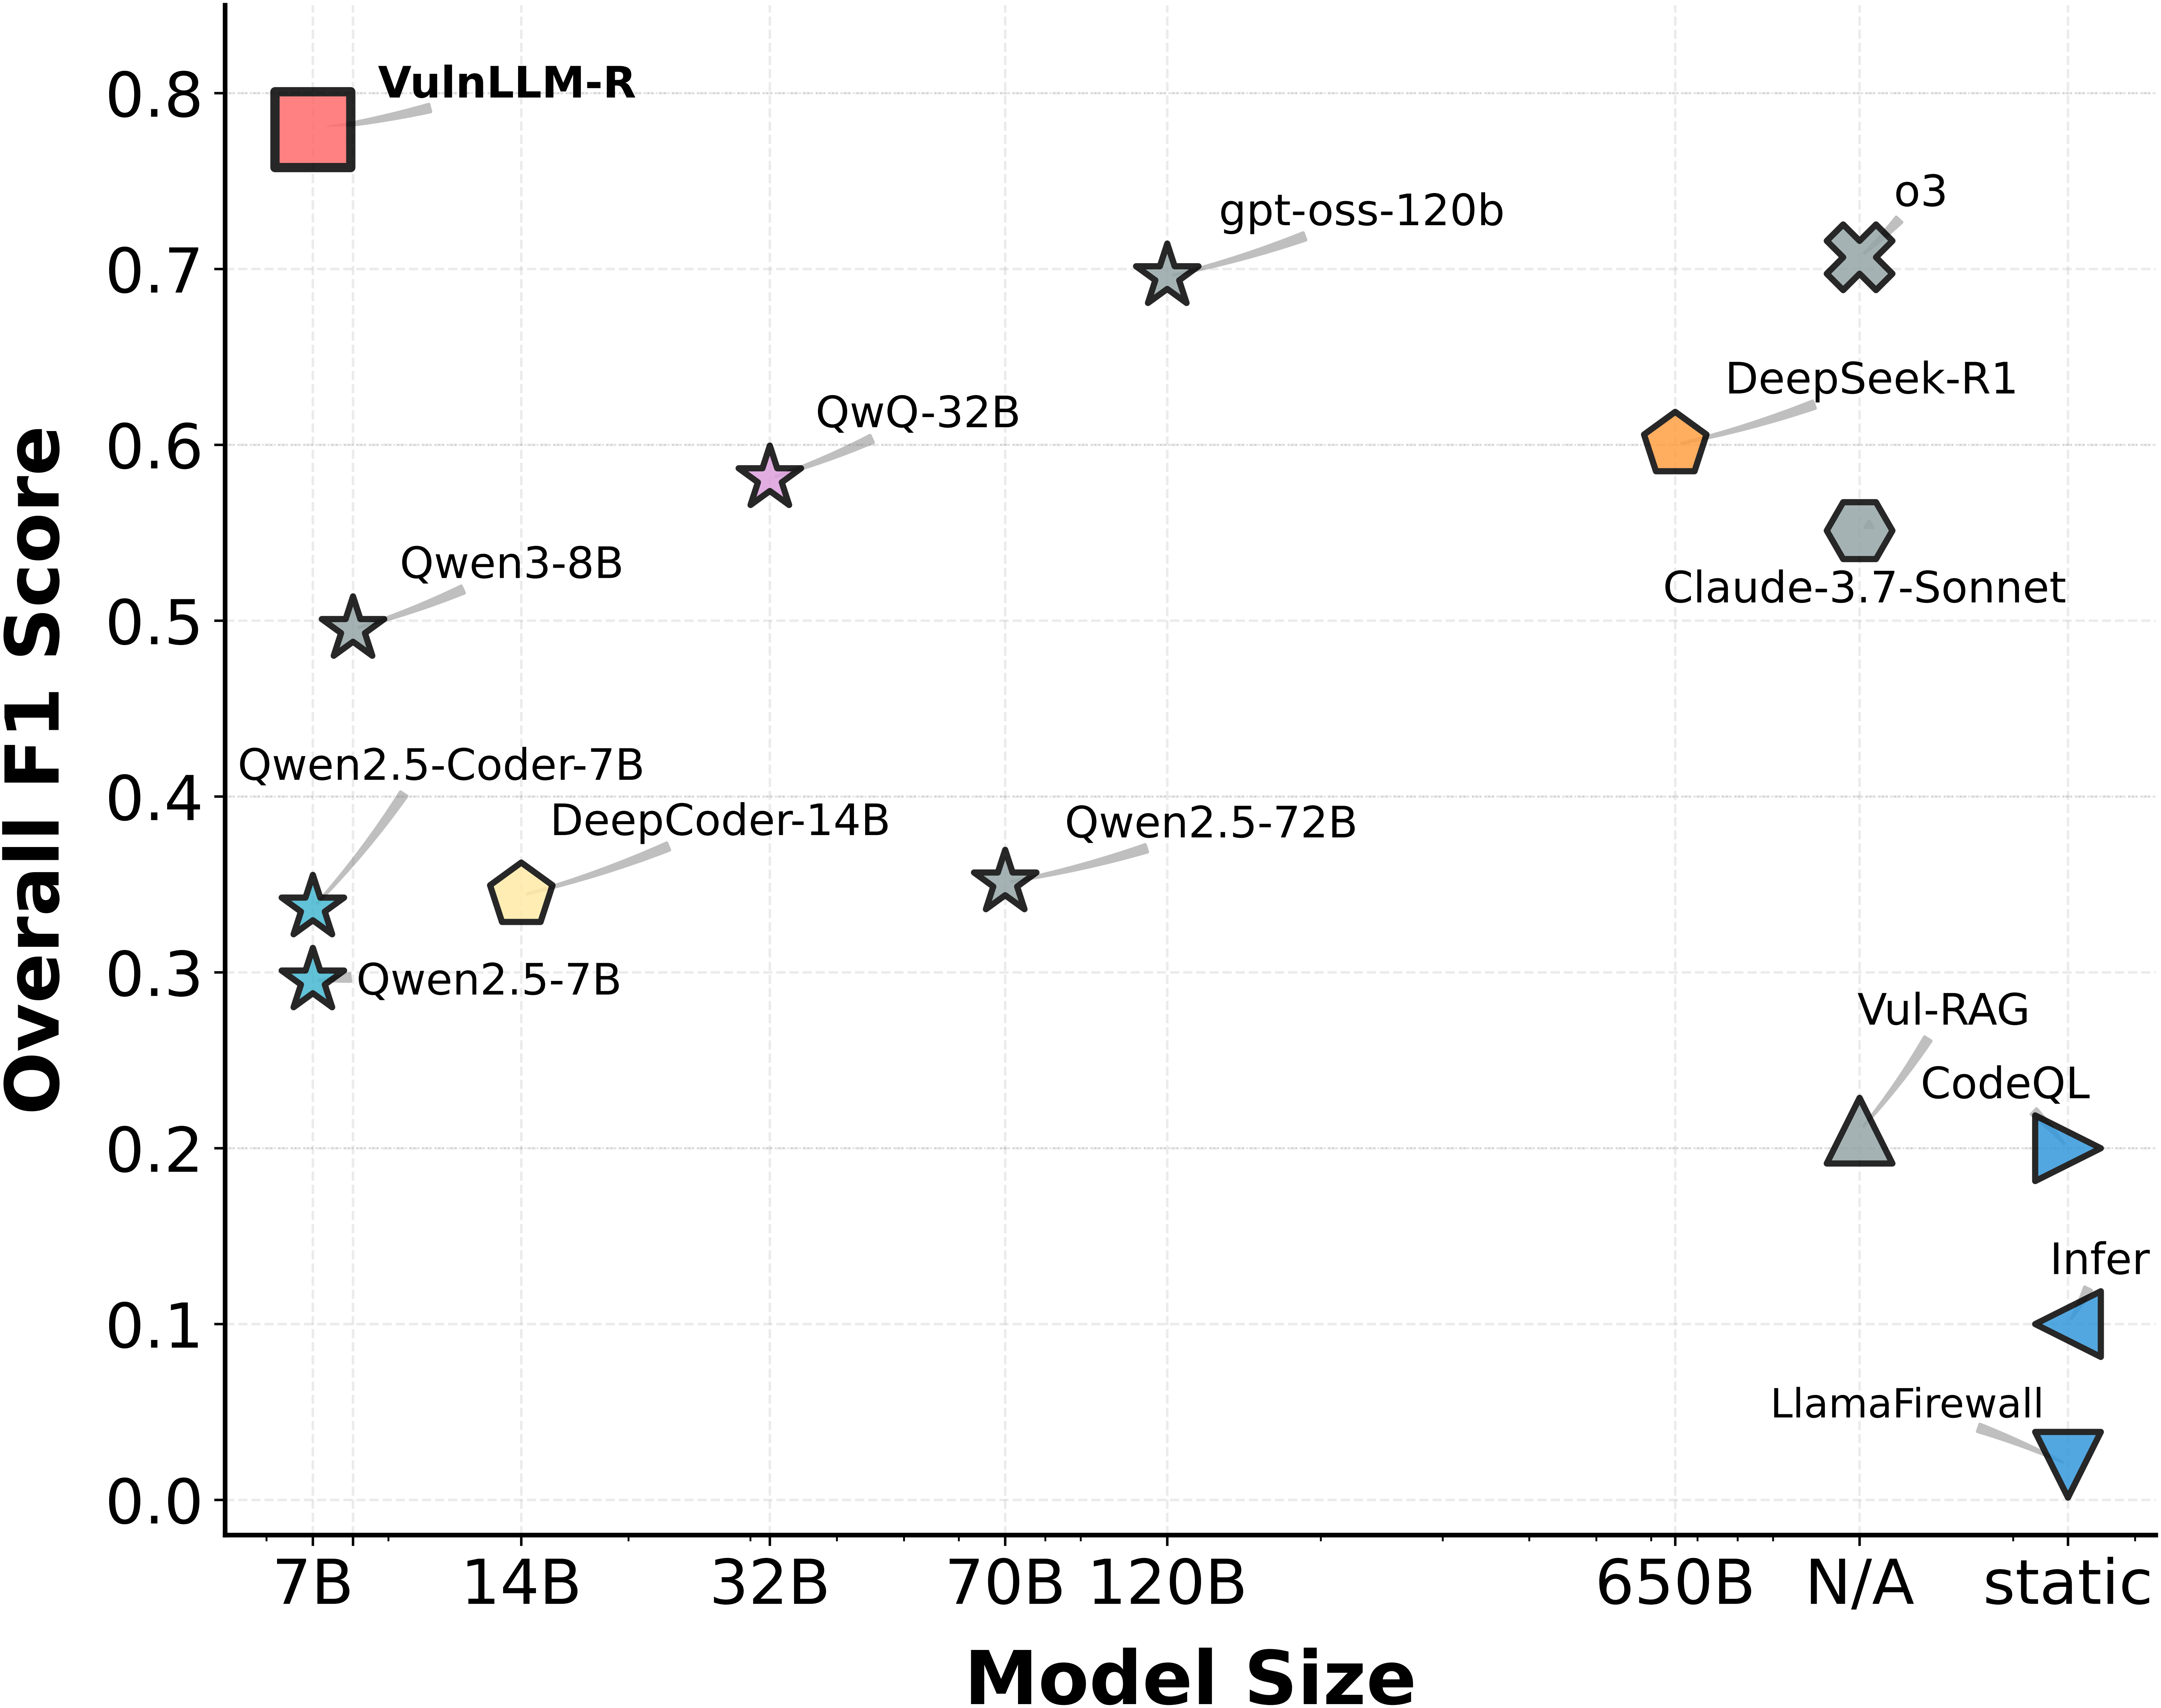
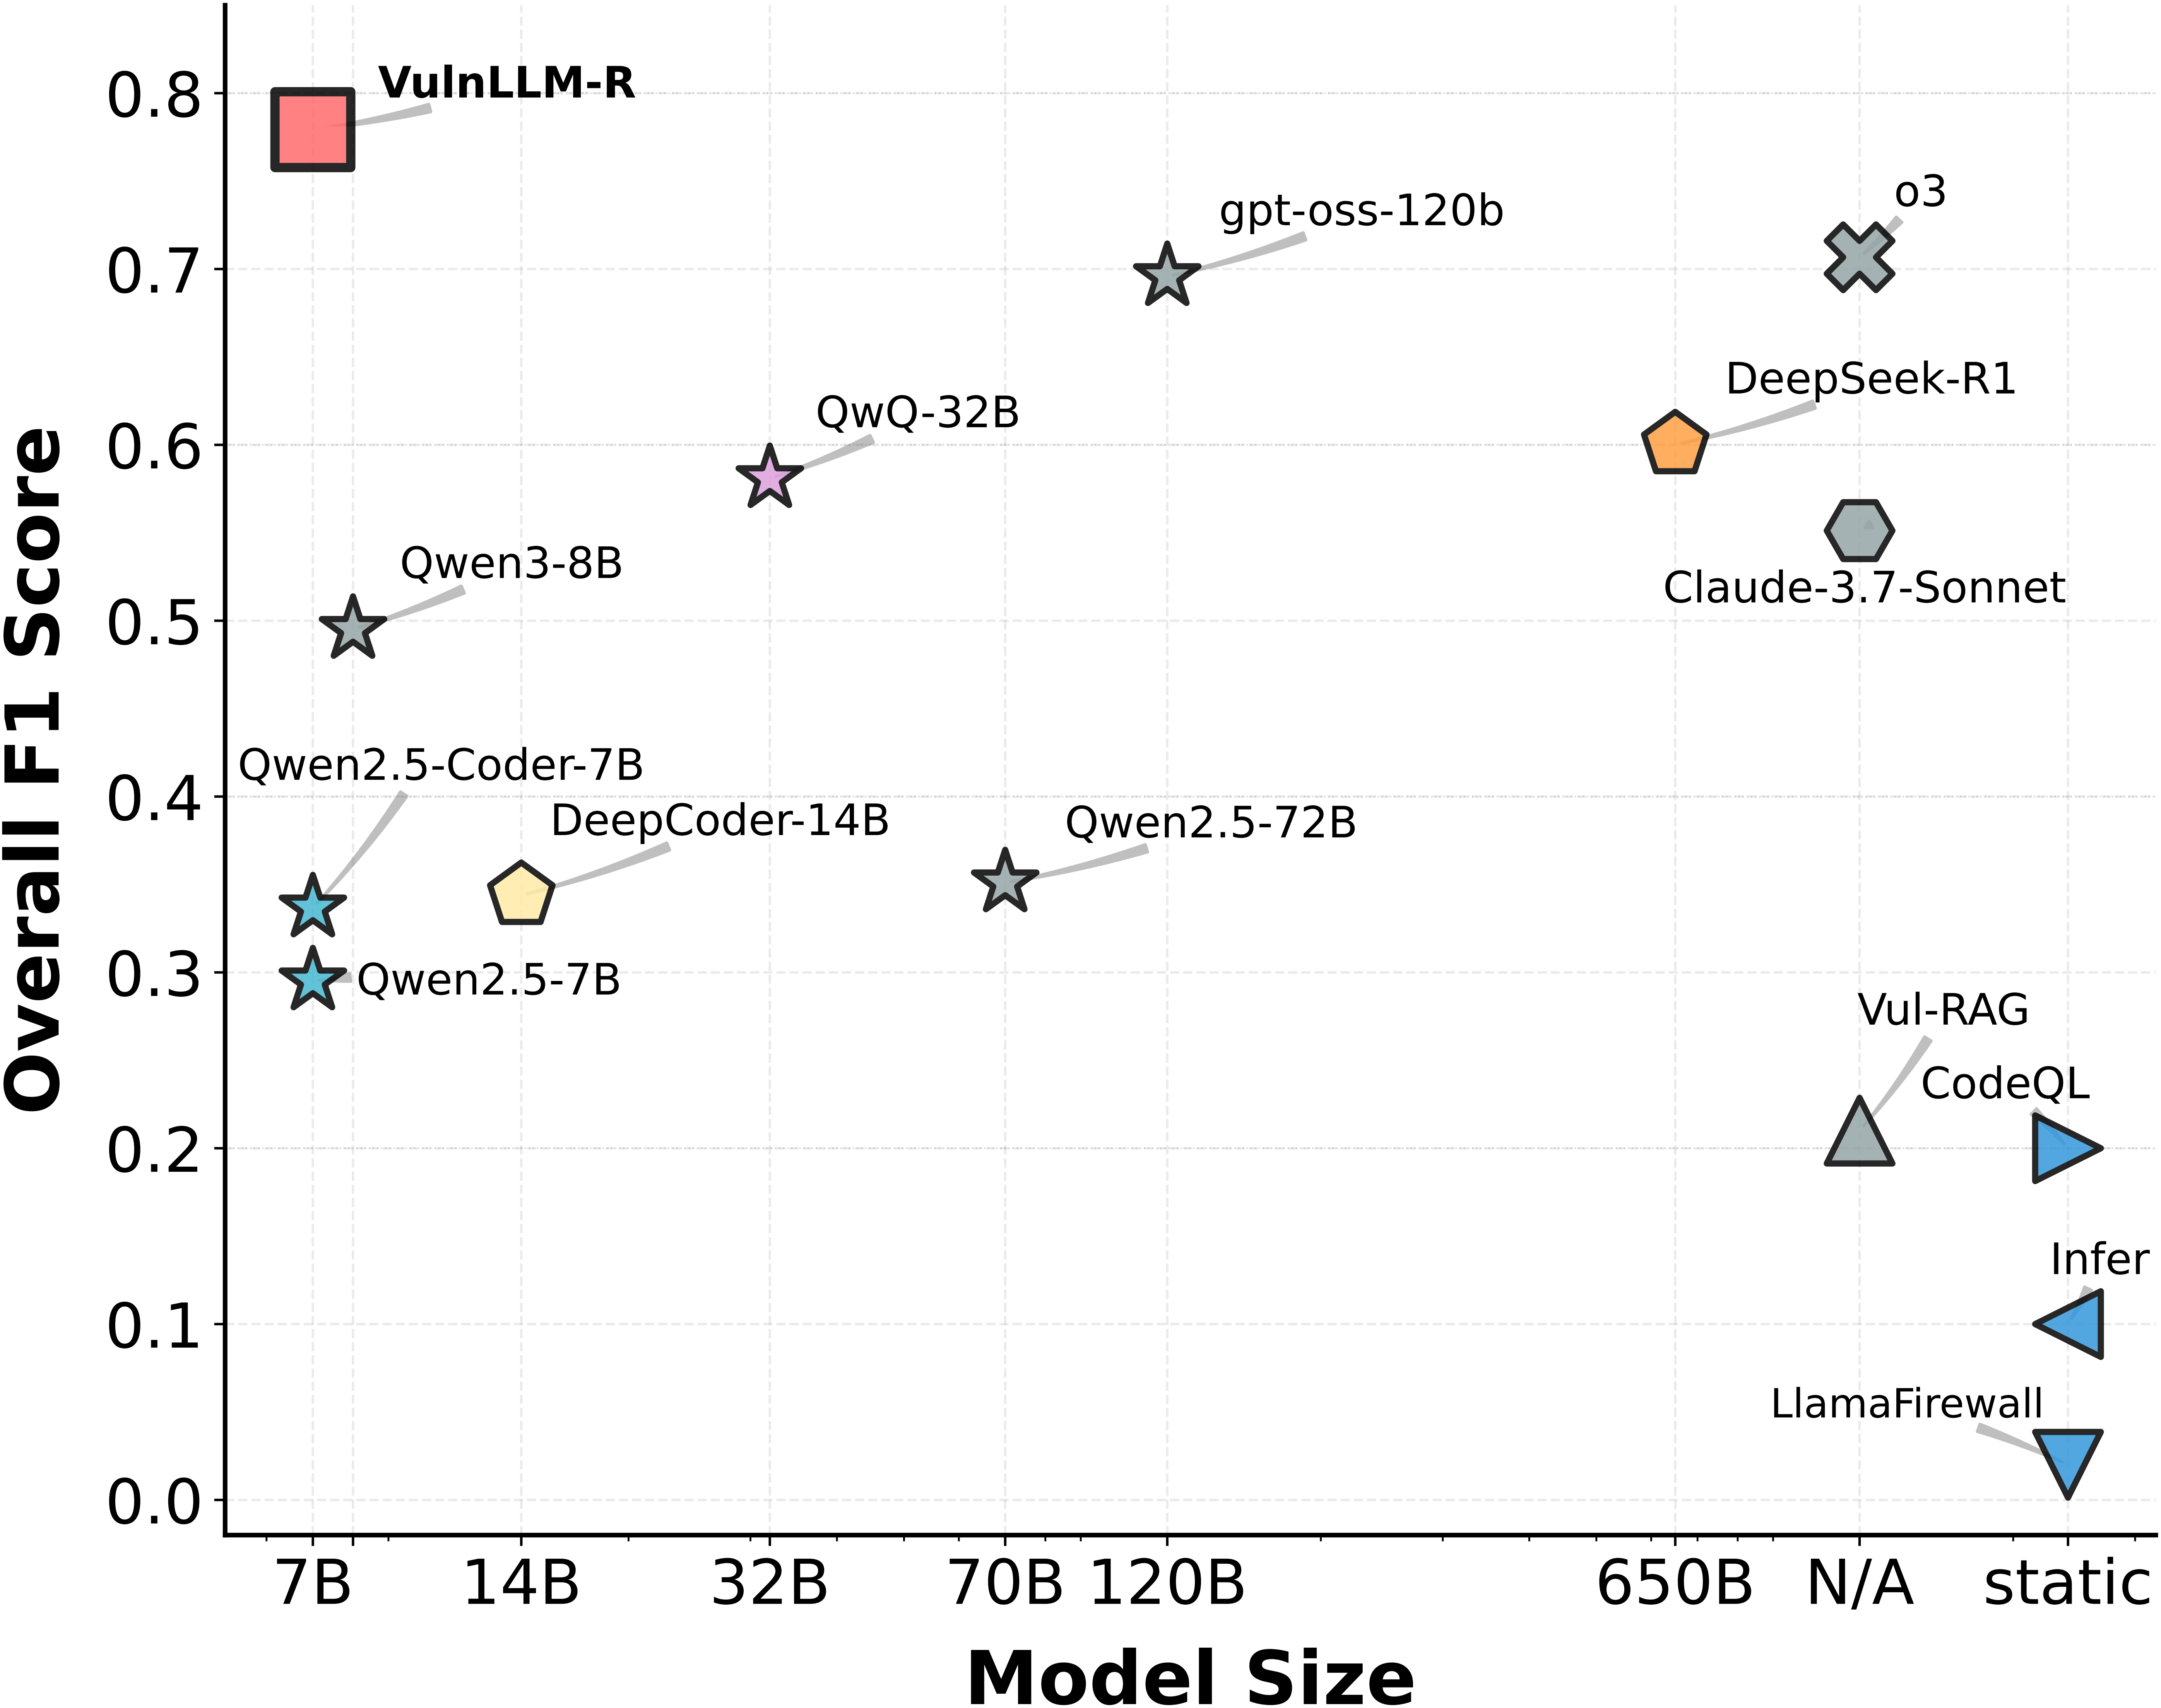
python plots/plot_model_size_scatter.py --results-dir results/test_data # Note: Labels may overlap with scatter points. Adjust text positions manually if needed.
हम डिस्टिल्ड डेटासेट के संक्षिप्त रीज़निंग संस्करण भी प्रदान करते हैं:
मौजूदा फ़ंक्शन-स्तरीय भेद्यता पहचान डेटासेट को मर्ज करें: PrimeVul [1], SecCodePLT [2], Juliet [3], Sven [4], और Arvo [5]। इन डेटासेट में से, PrimeVul में सबसे जटिल फ़ंक्शन हैं। हम दो प्रशिक्षण सेट बनाते हैं: clean (PrimeVul के बिना) और noisy (PrimeVul के साथ), ताकि हम अपेक्षाकृत सरल डेटासेट पर प्रशिक्षण ले सकें और जटिल PrimeVul डेटासेट पर परीक्षण कर सकें। ध्यान दें कि हमने PrimeVul वाले प्रशिक्षण सेट को noisy नाम दिया है, इसका मतलब यह नहीं है कि डेटासेट noisy है। यह एक अपेक्षाकृत मनमाना नाम है जिसे हमने शुरुआत में इस्तेमाल किया था।
vulscan/data_process/data_utils में डेटासेट को प्रोसेस और मर्ज करने के लिए कई स्क्रिप्ट हैं।
raw_to_us.py: कच्चे डेटा को हमारे डेटासेट में मर्ज करें और अनावश्यक डेटा हटाएँcheck_cwe_correct.py: प्रत्येक CWE श्रेणी के लिए सटीकता की गणना करेंgenerate_arvo_raw_data.py: arvo डेटासेट से संरचित कच्चा डेटा तैयार करेंarvo_to_us.py: arvo संरचित कच्चे डेटा को हमारे डेटासेट प्रारूप में पुनः प्रारूपित करेंsplit_good_bad_for_juliet.py: कच्चे Juliet 1.3 डेटासेट से डेटा निकालें और उसे आवश्यक प्रारूप में बदलें, जो हमारे clean_dataset का हिस्सा बनता हैadd_sven_to_clean_dataset.py: Sven डेटासेट से डेटा निकालें, जो हमारे C clean डेटासेट का हिस्सा बनता हैsync_large_small.py: noisy_dataset/large_train/c के संशोधनों को noisy_dataset/small_train/c के साथ सिंक्रनाइज़ करेंremove_testing_from_training.py: प्रत्येक डेटा में human टैग जोड़ें, जिसका अर्थ है कि बिंदु की मानव द्वारा पुष्टि की गई है और परीक्षण डेटा के रूप में उपयोग किया जाता है
-data_utils.py: डेटासेट में related_cwe फ़ील्ड जोड़ें।datasets/clean_dataset: PrimeVul के बिना प्रशिक्षण डेटा
datasets/clean_dataset/python में SVEN और SecCodePLT का डेटा हैdatasets/clean_dataset/c में Juliet और SVEN का डेटा हैdatasets/noisy_dataset
datasets/noisy_dataset/small_train: चयनित CWEs के साथ PrimeVul और SVEN का प्रशिक्षण डेटा शामिल है (
हम इस डेटासेट में PrimeVul डेटा को प्रशिक्षण के रूप में उपयोग करते हैं)datasets/noisy_dataset/large_train: PrimeVul, SVEN और SecCodePLT से अधिक CWEs के साथ प्रशिक्षण डेटा शामिल है (यह डेटासेट बाद में बड़े मॉडलों को प्रशिक्षित करने के लिए उपयोग किया जा सकता है)datasets/noisy_dataset/test: मानव द्वारा सत्यापित PrimeVul का एक छोटा परीक्षण सेटdatasets/test
datasets/test/test_clean: SVEN, SecCodePLT और Juliet का परीक्षण डेटा; प्रशिक्षण सेट का हिस्सा नहीं होने वाले OOD CWEs के साथdatasets/test/test_primevul_pair: मूल PrimeVul परीक्षण डेटाvulscan/data_process/data_utils/get_cwe_stat.py चला सकते हैं| डेटासेट | भाषा | प्रशिक्षण/परीक्षण | CWE | # Benign | # Vuln. | औसत लंबाई |
|---|---|---|---|---|---|---|
| Clean (seccodeplt) | Python | प्रशिक्षण | 20 | 1281 | 1281 | 741 |
| Clean (juliet) | C/C++ | प्रशिक्षण | 22 | 1716 | 1653 | 3689 |
| Hard (primevul filtered) | C/C++ | प्रशिक्षण | 26 | 2717 | 2952 | 4689 |
| Long Context (Oss-fuzz) | C/C++ | प्रशिक्षण | 3 | 475 | 604 | 12761 |
| Simple (seccodeplt) | Python | परीक्षण | 24 (6 ood) | 74 | 74 | 814 |
| Simple (juliet) | C/C++ | परीक्षण | 38 (14 ood) | 358 | 376 | 2575 |
| Hard (PrimeVul, SecLLMHolmes) | C/C++ | परीक्षण | 13 (5 ood) | 145 | 152 | 4545 |
| Long Context (Oss-fuzz) | C/C++ | परीक्षण | 3 (0 ood) | 0 | 320 | 18929 |
| primevul test (noisy) | C/C++ | परीक्षण | 56 (34 ood) | 421 | 422 | 5341 |
डेटासेट तैयार करने के बाद, हम अपने प्रशिक्षण सेट के लिए रीज़निंग डेटा तैयार करेंगे।
हम DeepSeek-r1 और QwQ रीज़निंग मॉडल को क्वेरी करके रीज़निंग डेटा तैयार करेंगे और बहुत लंबी रीज़निंग चेन वाले डेटा को फ़िल्टर कर देंगे।
रीज़निंग डेटा तैयार करने का कोड vulscan/data_process/generate_reasoning में है और रीज़निंग डेटा datasets/reasoning_data में सहेजा जाएगा।
cd vulscan/data_process/generate_reasoning
