
 protectai/vulnhuntr
LLMs का उपयोग करके शून्य-शॉट भेद्यता खोज

LLMs और स्थैतिक कोड विश्लेषण का उपयोग करके दूरस्थ रूप से शोषणीय कमजोरियों की पहचान करने का एक उपकरण।
दुनिया की पहली स्वायत्त AI-खोजी गई 0day कमजोरियाँ
Vulnhuntr LLMs की शक्ति का उपयोग करके पूरी कोड कॉल श्रृंखलाओं को स्वचालित रूप से बनाने और विश्लेषण करने का काम करता है, जो दूरस्थ उपयोगकर्ता इनपुट से शुरू होकर सर्वर आउटपुट पर समाप्त होती हैं, ताकि जटिल, बहु-चरणीय, सुरक्षा-उल्लंघन करने वाली कमजोरियों का पता लगाया जा सके जो पारंपरिक स्थैतिक कोड विश्लेषण उपकरणों की क्षमता से कहीं अधिक हैं। सभी 0-days के लिए Vulnhuntr आउटपुट सहित सभी विवरण यहाँ देखें: Protect AI Vulnhuntr Blog
[!TIP] Vulnhuntr का उपयोग करके कोई कमजोरी मिली? huntr.com पर एक रिपोर्ट जमा करें और $$ प्राप्त करें, और इसे नीचे दी गई सूची में जोड़ने के लिए एक PR सबमिट करें!
[!NOTE] यह तालिका अब तक मिली कमजोरियों का सिर्फ एक नमूना है। हम जिम्मेदार प्रकटीकरण अवधि समाप्त होने पर इसे पूरी तरह से प्रकट करेंगे।
| भंडार | सितारे | कमजोरियाँ |
|---|---|---|
| gpt_academic | 67k | LFI, XSS |
| ComfyUI | 66k | XSS |
| Langflow | 46k | RCE, IDOR |
| FastChat | 37k | SSRF |
| Ragflow | 31k | RCE |
| LLaVA | 21k | SSRF |
| gpt-researcher | 17k | AFO |
| Letta | 14k | AFO |
[!IMPORTANT] Vulnhuntr को Python 3.10 की सख्त आवश्यकता है क्योंकि Jedi में कई बग हैं, जिसका उपयोग यह Python कोड को पार्स करने के लिए करता है। यदि Python के किसी अन्य संस्करण के साथ स्थापित किया जाता है तो यह विश्वसनीय रूप से काम नहीं करेगा।
हम आसानी से Vulnhuntr को स्थापित करने और चलाने के लिए pipx या Docker का उपयोग करने की सलाह देते हैं।
Docker का उपयोग करके:
docker build -t vulnhuntr https://github.com/protectai/vulnhuntr.git#main
pipx का उपयोग करके:
pipx install git+https://github.com/protectai/vulnhuntr.git --python python3.10
वैकल्पिक रूप से आप poetry का उपयोग करके सीधे स्रोत से स्थापित कर सकते हैं:
git clone https://github.com/protectai/vulnhuntr
cd vulnhuntr && poetry install
यह उपकरण एक GitHub भंडार का विश्लेषण करने के लिए डिज़ाइन किया गया है ताकि संभावित दूरस्थ रूप से शोषणीय कमजोरियों का पता लगाया जा सके। उपकरण को एक API कुंजी और GitHub भंडार के स्थानीय पथ की आवश्यकता होती है। आप वैकल्पिक रूप से LLM सेवा के लिए एक कस्टम एंडपॉइंट भी निर्दिष्ट कर सकते हैं।
[!CAUTION] हमेशा खर्च सीमाएँ निर्धारित करें या आपके द्वारा उपयोग किए जाने वाले LLM प्रदाता के साथ लागत की बारीकी से निगरानी करें। इस उपकरण में भारी बिल आने की संभावना है क्योंकि यह LLMs के संदर्भ विंडो में अधिक से अधिक कोड फिट करने का प्रयास करता है।
[!TIP] हम LLM के लिए Claude का उपयोग करने की सलाह देते हैं। परीक्षण के माध्यम से हमने GPT की तुलना में इसके साथ बेहतर परिणाम प्राप्त किए हैं।
usage: vulnhuntr [-h] -r ROOT [-a ANALYZE] [-l {claude,gpt,ollama}] [-v]

Analyze a GitHub project for vulnerabilities. Export your ANTHROPIC_API_KEY/OPENAI_API_KEY before running.

options:
  -h, --help            show this help message and exit
  -r ROOT, --root ROOT  Path to the root directory of the project
  -a ANALYZE, --analyze ANALYZE
                        Specific path or file within the project to analyze
  -l {claude,gpt,ollama}, --llm {claude,gpt,ollama}
                        LLM client to use (default: claude)
  -v, --verbosity       Increase output verbosity (-v for INFO, -vv for DEBUG)
pipx स्थापना से, Claude का उपयोग करके पूरे भंडार का विश्लेषण करें:
export ANTHROPIC_API_KEY="sk-1234"
vulnhuntr -r /path/to/target/repo/
[!TIP] हम Vulnhuntr को विशिष्ट फ़ाइलें देने की सलाह देते हैं जो दूरस्थ उपयोगकर्ता इनपुट को संभालती हैं और उन्हें अलग-अलग स्कैन करती हैं।
pipx स्थापना से, GPT-4o का उपयोग करके /path/to/target/repo/server.py फ़ाइल का विश्लेषण करें। फ़ाइल के बजाय एक उपनिर्देशिका भी निर्दिष्ट कर सकते हैं:
export OPENAI_API_KEY="sk-1234"
vulnhuntr -r /path/to/target/repo/ -a server.py -l gpt
Docker स्थापना से, Claude और एक कस्टम एंडपॉइंट का उपयोग करके /local/path/to/target/repo/repo-subfolder/target-file.py का विश्लेषण करने के लिए चलाएँ:
docker run --rm -e ANTHROPIC_API_KEY=sk-1234 -e ANTHROPIC_BASE_URL=https://localhost:1234/api -v /local/path/to/target/repo:/repo vulnhuntr:latest -r /repo -a repo-subfolder/target-file.py
प्रयोगात्मक
Ollama एक विकल्प के रूप में शामिल है, हालांकि हमें ओपन सोर्स मॉडल्स के साथ उनके आउटपुट को सही ढंग से संरचित करने में सफलता नहीं मिली है।
export OLLAMA_BASE_URL=http://localhost:11434/api/generate
export OLLAMA_MODEL=llama3.2
vulnhuntr -r /path/to/target/repo/ -a server.py -l ollama
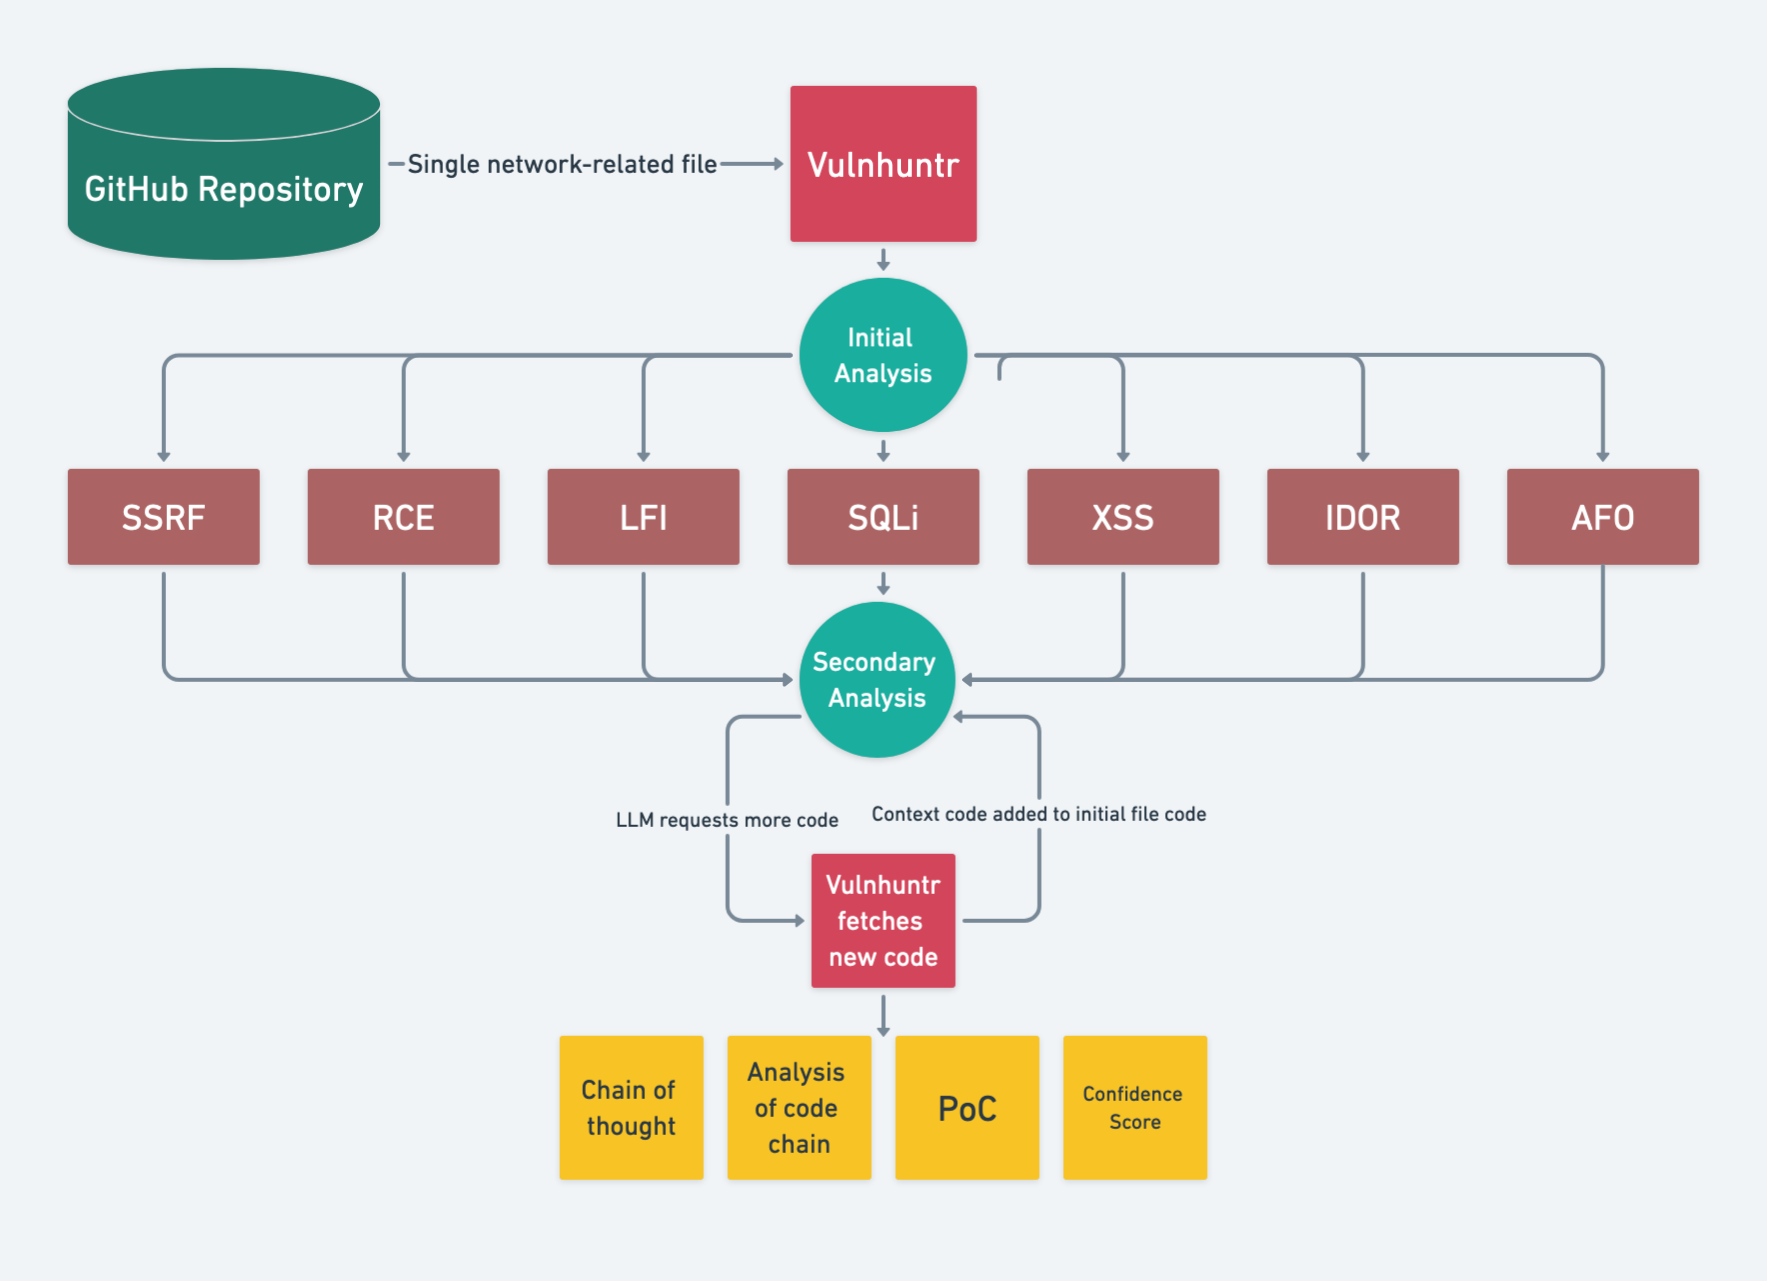
[!TIP] आमतौर पर 7 से कम विश्वास स्कोर का मतलब है कि कमजोरी होने की संभावना नहीं है। 7 के विश्वास स्कोर का मतलब है कि इसकी जाँच की जानी चाहिए, और 8+ के विश्वास स्कोर का मतलब है कि यह एक वैध कमजोरी होने की बहुत संभावना है।
यह उपकरण विश्लेषित फ़ाइलों में पाई गई कमजोरियों की एक विस्तृत रिपोर्ट तैयार करता है। रिपोर्ट में शामिल हैं:
नीचे एक Vulnhuntr रिपोर्ट का उदाहरण है जो Ragflow (अब ठीक किया गया) में एक 0-day दूरस्थ कोड निष्पादन कमजोरी का वर्णन करती है:






