
 js-lee-ai/refusal-relocates
LLM सुरक्षा: विश्लेषण करें कि फाइन-ट्यूनिंग कैसे इनकार व्यवहार को बदलती है और लेयर-फ्रीज़िंग तथा लो-रैंक रक्षा का मूल्यांकन करें।





प्रोजेक्ट पेज · त्वरित शुरुआत · उपयोग · CLI · परिणाम · पुनरुत्पादन · सामान्य प्रश्न · उद्धरण
कुछ दर्जन हानिकारक उदाहरण एक संरेखित मॉडल के हानिकारक अनुरोधों को अस्वीकार करने की क्षमता को हटा सकते हैं। पूर्ववर्ती कार्य सुरक्षा को विशिष्ट परतों और दिशाओं में स्थानीयकृत करता है, जो यह सुझाव देता है कि जो स्थान पाया गया है उसकी रक्षा की जाए। यह रिपॉज़िटरी उस आधार-वाक्य का परीक्षण उसी तरह करती है जैसे कोई अनुकूली आक्रमणकारी करेगा। यह पाता है कि इनकार कहाँ पुनः प्राप्त किया जा सकता है, उस क्षेत्र को स्थिर करता है और फिर से आक्रमण करता है, और यह वेट अपडेट की मरम्मत करता है और फिर आक्रमणकारी को उसे फैलाने देता है।
यह अध्ययन तीन मापों पर आधारित है।
यह रिपॉज़िटरी माप और दोनों रक्षाओं को एक छोटी लाइब्रेरी के रूप में प्रदान करती है, साथ में रन रिकॉर्ड और स्क्रिप्ट्स जो पेपर की तालिकाओं को पुनः बनाते हैं।
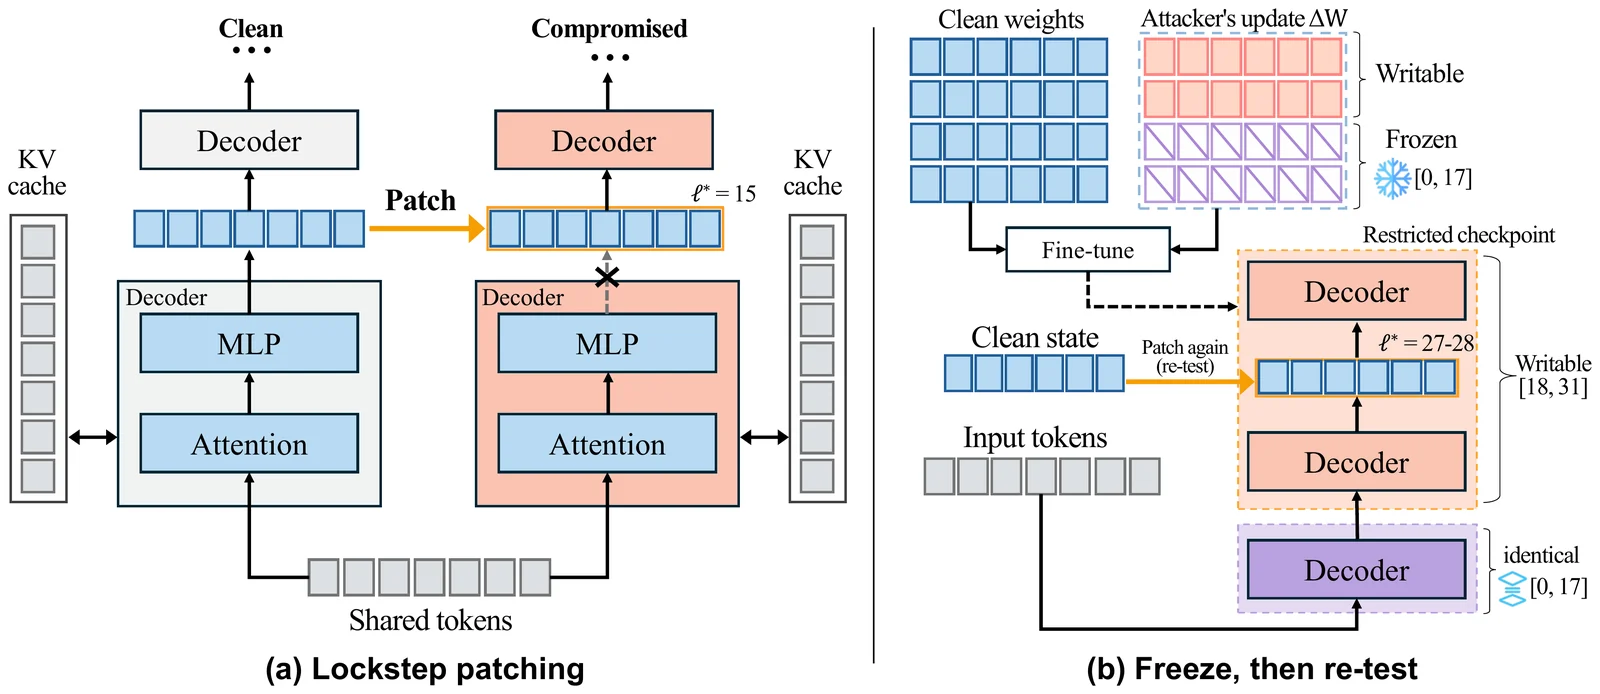
(a) लॉकस्टेप एक्टिवेशन पैचिंग समझौता किए गए मॉडल की परत आउटपुट को प्रीफ़िल और प्रत्येक डिकोडिंग चरण पर स्वच्छ स्थिति से अधिलेखित करती है। (b) मिलान किए गए Llama आक्रमण में, परतों 0–17 को स्थिर करना आधी-सीमा संक्रमण को 15 से 27–28 में स्थानांतरित करता है।
pip install "git+https://github.com/js-lee-AI/refusal-relocates.git"
import numpy as np
import refusal

rng = np.random.default_rng(0)
A = rng.standard_normal((16, 512)) / 512 ** 0.5    # LoRA factors of one module, rank 16
B = rng.standard_normal((512, 16)) / 16 ** 0.5
for name, decay in [("ordinary", 0.5), ("spread", 1.0)]:
    b = B * decay ** np.arange(16)                  # energy in a few directions, or spread flat
    before, after = refusal.update_stats(A, b), refusal.update_stats(*refusal.remove_top_k(A, b, k=2))
    print(f"{name:8s}  PR/r {before['pr_over_r']:.2f}  top-2 energy {before['top2_energy_fraction']:.2f}"
          f"  norm left after top-2 removal {after['unscaled_norm'] / before['unscaled_norm']:.2f}")
# ordinary  PR/r 0.10  top-2 energy 0.94  norm left after top-2 removal 0.24
# spread    PR/r 0.94  top-2 energy 0.18  norm left after top-2 removal 0.90
एक साधारण फाइन-ट्यून अपने अधिकांश अपडेट को कुछ ही सिंगुलर दिशाओं में डालता है, इसलिए टॉप-टू हटाने से उसका अधिकांश भाग हट जाता है। एक स्प्रेड अपडेट का स्पेक्ट्रम सपाट होता है, इसलिए वही हटाने से उसका अधिकांश भाग यथावत रहता है। PR/r, जो LoRA रैंक पर पार्टिसिपेशन रेशियो है, पेपर के स्पेक्ट्रल डिटेक्टर का स्कोर भी है।
यह CPU पर लगभग एक सेकंड में चलता है और कुछ भी डाउनलोड नहीं करता। वही कोड examples/quickstart.py है, और CI इसे हर पुश पर चलाता है।
वास्तविक चेकपॉइंट्स को ट्रेन, पैच और मूल्यांकन करने के लिए, models एक्स्ट्रा इंस्टॉल करें।
pip install "refusal-relocates[models] @ git+https://github.com/js-lee-AI/refusal-relocates.git"
| install | adds | enough for |
|---|---|---|
pip install "git+https://github.com/js-lee-AI/refusal-relocates.git" | numpy | spectral core, top-k हटाना, डिटेक्टर, refusal स्कोरर, refusal कमांड |
pip install "refusal-relocates[models] @ git+https://github.com/js-lee-AI/refusal-relocates.git" | torch, transformers, peft, accelerate, safetensors, scikit-learn, datasets | किसी मॉडल पर ट्रेनिंग, lockstep पैचिंग, प्रोब्स और मूल्यांकन |
git clone और फिर pip install -e ".[models,test]" | pytest | experiments/, records/ और tests/ |
Python 3.11.5, PyTorch 2.10.0, Transformers 4.57.3 और PEFT 0.18.0 के साथ परीक्षण किया गया। मॉडल CUDA डिवाइस पर bfloat16 में लोड होते हैं।
import refusal

data = refusal.load_data("data/prompt_sets.json")        # built by `refusal prepare`, see below
prompts = data["advbench"][:40]
clean, tokenizer = refusal.load_model("meta-llama/Llama-3.1-8B-Instruct")
attacked, _ = refusal.load_model("meta-llama/Llama-3.1-8B-Instruct", adapter="runs/attack/adapter")

for layer in [6, 9, 12, 15, 18]:
    responses = refusal.lockstep_generate(clean, attacked, tokenizer, prompts, layer=layer)
    print(layer, sum(refusal.is_refusal(r) for r in responses) / len(prompts))
दोनों मॉडल एक ही टोकन पढ़ते हैं, और चुनी गई परत पर समझौता किए गए मॉडल के आउटपुट को स्वच्छ मॉडल के आउटपुट से बदल दिया जाता है। refusal patch अपने फ्लोर, सीलिंग और दो नियंत्रणों के साथ पूर्ण मापन चलाता है, परप्लेक्सिटी गेट और Llama-Guard के साथ सुसंगत इनकार का स्कोर करता है, और संक्रमण गहराई की रिपोर्ट करता है।
import refusal

stats = refusal.update_stats(A, B)                 # one module, A is rank x in and B is out x rank
A2, B2 = refusal.remove_top_k(A, B, k=2)           # the top-two repair, as new LoRA factors
result = refusal.calibrate_detector(benign_scores, attack_scores, budget=0.05)
एक एडाप्टर का डिटेक्टर स्कोर उसके attention projections पर औसतन PR/r होता है, जिसे refusal spectra CPU पर सहेजे गए एडाप्टर से गणना करता है।







