
 jev-sec/jev-ids
TypeSafe के Jev पर आधारित अत्यंत तेज़, टोकन-कुशल घुसपैठ का पता लगाने वाली प्रणाली (IDS)।


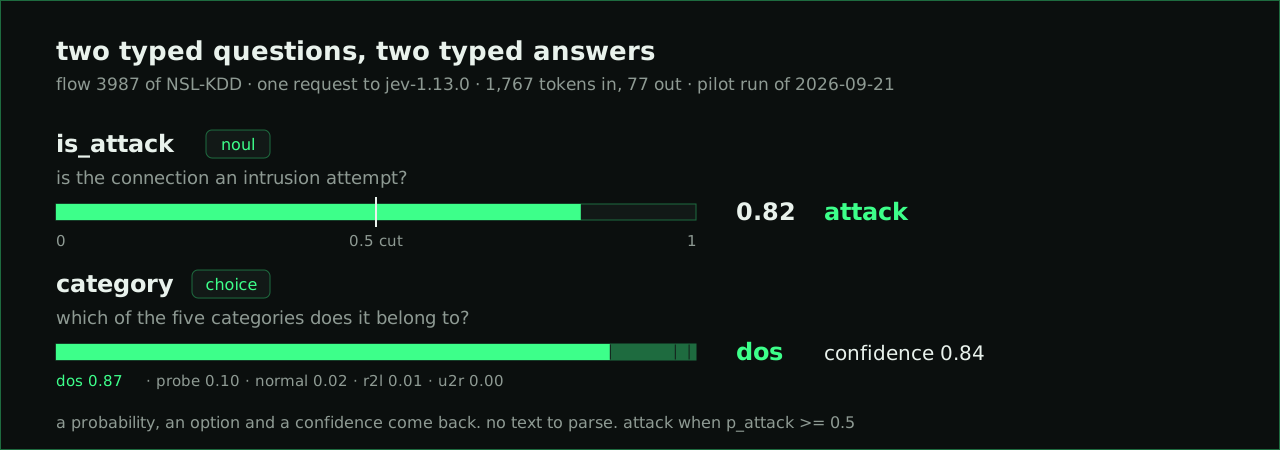
एक ही अनुरोध में घुसपैठ का पता लगाना। TypeSafe के Jev को एक नेटवर्क फ़्लो और पाँच लेबल किए गए उदाहरण दिखाएँ। यह आधे सेकंड में बताता है कि फ़्लो हमला है या नहीं और किस प्रकार का, बिना किसी टेक्स्ट को पार्स किए।
Jev IDS का परीक्षण NSL-KDD पर किया गया, जो साइबर सुरक्षा समुदाय का एक संदर्भ बेंचमार्क है, एक अत्याधुनिक LLM (Vertex AI पर Gemini 3.6 Flash), एक पारंपरिक मशीन-लर्निंग मॉडल (Random Forest) और एक अनसुपरवाइज़्ड मॉडल (Isolation Forest) के विरुद्ध: 2,000 फ़्लो, तीन सीड, प्रति श्रेणी k 0 से 8 उदाहरण तक। समान पाँच उदाहरण (k = 1) दिए जाने पर, Jev IDS था:
F1 पर LLM बेहतर डिटेक्टर है: k = 1 पर Jev के 0.856 बनाम 0.880, और हर k पर आगे (McNemar p < 0.001), क्योंकि यह उदाहरणों में दिखाए गए प्रकार के अधिक हमलों को पकड़ता है। Jev दूसरे स्थान पर है, और ज़ीरो-डे हमलों पर, जो प्रकार उदाहरणों में अनुपस्थित हैं, यह k = 1 से k = 8 तक LLM से अधिक पकड़ता है (k = 1 पर 0.747 बनाम 0.713)। संख्याएँ, आंकड़े और उनकी सीमाएँ Evidence and limits और docs/results.md में हैं।
लूप पढ़ें · अनुरोध टेम्पलेट · शब्दावली
Jev एक System One Model है। टेक्स्ट लिखने के बजाय, यह एक state पढ़ता है और उसके बारे में टाइप किए गए प्रश्नों का उत्तर प्रायिकताओं के साथ देता है। Jev IDS एक फ़्लो को state में रखता है, निर्देशों, कॉलम नामों, पाँच श्रेणी विवरणों और लेबल किए गए उदाहरणों के साथ, और दो प्रश्न पूछता है। is_attack एक प्रायिकता के रूप में वापस आता है। category पाँच विकल्पों में से एक के रूप में एक विश्वास के साथ वापस आता है। जब प्रायिकता 0.5 तक पहुँचती है तो निर्णय हमला होता है।
हर अनुरोध एक ही पथ का अनुसरण करता है:
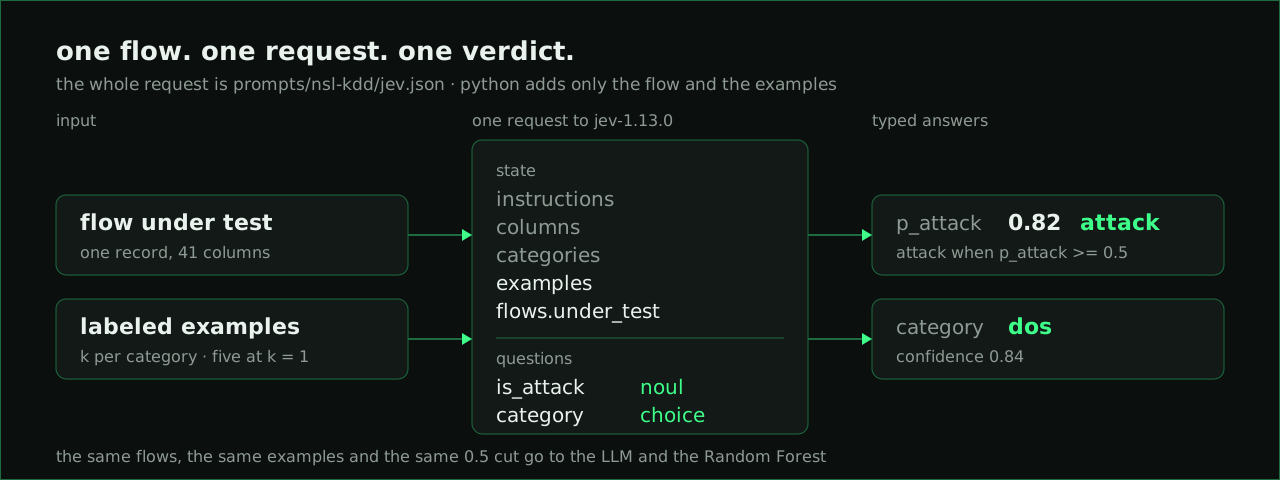
पूरा अनुरोध एक फ़ाइल है, prompts/nsl-kdd/jev.json। Python केवल फ़्लो और उदाहरण जोड़ता है, और फ़ाइल का sha256 हर prediction पंक्ति में prompt_hash के रूप में यात्रा करता है, इसलिए जिन रनों ने अलग चीज़ें पूछीं, उनकी कभी समान रूप में तुलना नहीं की जाती। उदाहरण केवल श्रेणी द्वारा लेबल किए जाते हैं: neptune जैसे हमले के नाम कभी किसी मॉडल तक नहीं पहुँचते।
वही फ़्लो, उदाहरण और 0.5 कट दो बेसलाइनों को जाते हैं: एक LLM, JSON आउटपुट स्कीमा वाले Agno एजेंट के माध्यम से (पेपर में Vertex AI के माध्यम से Gemini 3.6 Flash; विकल्प के रूप में ChatGPT Codex बैकएंड के माध्यम से GPT-5.6 या DeepSeek) और उन्हीं उदाहरणों पर प्रशिक्षित एक scikit-learn Random Forest। एक तीसरी बेसलाइन, केवल पूल के बिनाइन फ़्लो पर फिट किया गया Isolation Forest, कभी कोई उदाहरण नहीं देखता: यह अनसुपरवाइज़्ड संदर्भ है, केवल k = all पर।
git clone https://github.com/jev-sec/jev-ids.git
cd jev-ids
uv sync
# .env: TYPESAFE_API_KEY for Jev. Gemini needs `gcloud auth application-default login` and GOOGLE_GENAI_USE_VERTEXAI=true,
# GOOGLE_CLOUD_PROJECT and GOOGLE_CLOUD_LOCATION=global in the environment; DEEPSEEK_API_KEY and CHATGPT_CLIENT_ID only for the other LLMs.
NSL-KDD को data/raw/nsl-kdd/ में डाउनलोड करें और इसे एक बार तैयार करें:
uv run python -m scripts.prepare_nsl_kdd
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector jev --split smoke --k 0,1
smoke स्प्लिट पाँच फ़्लो है। रन results/<timestamp>-nsl-kdd-jev-smoke/ लिखता है जिसमें config.json, predictions.jsonl में प्रति फ़्लो एक JSON पंक्ति (निर्णय, सत्य, p_attack, श्रेणी, विश्वास, विलंबता और गेटवे की टोकन रिपोर्ट) और responses.jsonl में कच्चे उत्तर होते हैं।
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector jev --split pilot --k 0,1,2,4,8 --seeds 0,1,2
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector llm:gemini --model gemini-3.6-flash --split pilot --k 0,1,2,4,8
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector random_forest --split pilot --k 1,2,4,8,all
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector isolation_forest --split pilot --k all
uv run jev-ids metrics results/<run_id> [results/<run_id> ...] > results/summary.csv
uv run jev-ids compare --a results/<jev_run> --b results/<rf_run> --subset novel --k-a 0 --k-b all  # novel = zero-day attacks
k प्रति श्रेणी लेबल किए गए उदाहरणों की संख्या है। पाँच श्रेणियों के साथ k = 1 का अर्थ पाँच उदाहरण हैं, और all का अर्थ पूरा पूल है। metrics प्रति डिटेक्टर और k एक CSV पंक्ति प्रिंट करता है जिसमें F1, ज़ीरो-डे हमलों पर recall (novel कोड में) और प्रति श्रेणी, p_attack का PR-AUC और ROC-AUC, टोकन, विलंबता और लागत होती है। compare दो रनों को फ़्लो-दर-फ़्लो जोड़ता है और असंगत जोड़ों पर McNemar का परीक्षण चलाता है, क्योंकि केवल वे फ़्लो जिन पर दो डिटेक्टर असहमत हैं, उन्हें अलग करते हैं। लागत ऑफ़लाइन टोकन गुणा prices.json में सूची मूल्यों के रूप में गणना की जाती है, सभी डिटेक्टरों के लिए समान रूप से।
docs/protocol.md इनपुट्स (2,000-फ़्लो paper स्प्लिट, प्रॉम्प्ट, मॉडल आईडी, मूल्य) को निश्चित करता है और make paper उस स्प्लिट पर चारों डिटेक्टरों को results/paper/ में चलाता है और results/paper/summary.csv लिखता है। प्रत्येक डिटेक्टर का अपना लक्ष्य है (make paper-jev, make paper-llm, make paper-random-forest, make paper-isolation-forest), इसलिए वे अलग टर्मिनलों में चल सकते हैं; LLM धीमा वाला है। make paper-llm Vertex AI पर Gemini 3.6 Flash को पाँच समानांतर प्रक्रियाओं के रूप में चलाता है, प्रति k एक (make -j5 paper-llm); कोटा त्रुटि या टाइमआउट एक error पंक्ति है, और uv run jev-ids redo-errors results/paper/<run> उन फ़्लो को यथास्थान फिर से जाँचता है। पूरी तालिकाएँ और आंकड़े docs/results.md में हैं।

