 hoodoer/colonelclustered
एक Java Burp Plugin जो सर्वर प्रतिक्रियाओं की वास्तविक सामग्री के आधार पर आउटलेयर्स/समूहों की पहचान करने के लिए प्रतिक्रियाओं पर टेक्स्ट क्लस्टरिंग करता है, जैसे कि किसी Intruder रन से।

HTTP रिस्पॉन्स को क्लस्टर करके आउटलायर्स खोजने के लिए एक Burp Suite एक्सटेंशन।
यह एक प्लगइन है जिसे बनाने के बारे में मैं कई वर्षों से सोच रहा हूँ, क्योंकि मैं इस बात से कुछ हद तक परेशान हूँ कि हम Burp intruder में फ़ज़िंग हमलों के परिणामों का विश्लेषण कैसे करते हैं। हम आमतौर पर अपने फ़ज़िंग हमलों में सर्वर रिस्पॉन्स में बदलावों की तलाश करते हैं। और हम उन अंतरों को स्टेटस कोड, रिस्पॉन्स टाइम और रिस्पॉन्स साइज़ को देखकर खोजते हैं। ये सभी रिस्पॉन्स की सामग्री के अप्रत्यक्ष माप हैं। बेशक, पेंटेस्टर्स के रूप में हमारे पास रिस्पॉन्स सामग्री में अंतर खोजने के लिए हज़ारों सर्वर की सामग्री पढ़ने का समय नहीं है। लेकिन निश्चित रूप से हम एल्गोरिदम से यह काम करवा सकते हैं।
यहीं यह प्लगइन काम आता है। यह रिस्पॉन्स की सामग्री का विश्लेषण करने और उन्हें उनकी समानता के आधार पर क्लस्टर में रखने के लिए टेक्स्ट क्लस्टरिंग तकनीकों का उपयोग करता है। यह आपको अपने intruder फ़ज़िंग हमलों के परिणामों को देखने का एक और तरीका देता है, और उन सर्वर रिस्पॉन्स को जल्दी से पहचानने में मदद करता है जो अलग हैं।
Colonel Clustered रिस्पॉन्स क्लस्टरिंग करने के लिए दो अलग-अलग एल्गोरिदम प्रदान करता है। डिफ़ॉल्ट एल्गोरिदम अपेक्षाकृत तेज़ है, साथ में एक वैकल्पिक गहन विश्लेषण एल्गोरिदम है जो आउटलायर्स को पहचानने में उत्कृष्ट है, लेकिन अच्छी तरह स्केल नहीं करता। वैसे, दोनों ही अच्छी तरह स्केल नहीं करते, मैं इस प्लगइन पर 50k रिस्पॉन्स डालने में झिझक करूँगा। तेज़/डिफ़ॉल्ट एल्गोरिदम की जटिलता O(n^2) है, जबकि गहन विश्लेषण एल्गोरिदम O(n^3) है। तो इसे ध्यान में रखें जब आप इसे प्रोसेस करने के लिए intruder परिणाम भेजते हैं।
कंटेंट-अवेयर टोकनाइज़ेशन: एक्सटेंशन पहले प्रत्येक रिस्पॉन्स के Content-Type हेडर का निरीक्षण करता है ताकि सबसे बुद्धिमान टोकनाइज़ेशन रणनीति लागू की जा सके:
प्री-ग्रुपिंग: हज़ारों रिस्पॉन्स के साथ भी तेज़ बने रहने के लिए, एक्सटेंशन सभी पूर्णतः समान रिस्पॉन्स को समूहित करने के लिए एक single pass करता है। यह प्रत्येक रिस्पॉन्स के token set का hash गणना करता है और समान hash साझा करने वाले सभी आइटम्स को समूहित करता है। इसका मतलब है कि महँगा क्लस्टरिंग एल्गोरिदम केवल unique response bodies के बहुत छोटे सेट पर चलना होता है।
दोहरे क्लस्टरिंग एल्गोरिदम: Colonel Clustered दो अलग-अलग क्लस्टरिंग एल्गोरिदम प्रदान करता है:
Fast Scan (डिफ़ॉल्ट): एक उच्च-प्रदर्शन DBSCAN-आधारित एल्गोरिदम स्वचालित रूप से चलता है जब आप एक्सटेंशन को कई request/responses भेजते हैं।
Deep Analysis (मैनुअल ट्रिगर): मूल, अधिक कम्प्यूटेशनल रूप से गहन hierarchical clustering एल्गोरिदम "Deep Analysis" बटन के माध्यम से उपलब्ध है। यह विकल्प उन परिदृश्यों के लिए डिज़ाइन किया गया है जिनमें अधिक granular और संभावित रूप से भिन्न क्लस्टरिंग परिप्रेक्ष्य की आवश्यकता होती है, जो बेहतर क्लस्टर सामंजस्य के लिए Average Linkage का उपयोग करता है।
आउटलायर समेकन: क्लस्टरिंग के बाद, केवल एक unique सदस्य वाले किसी भी परिणामी समूह को आउटलायर माना जाता है। फिर ऐसे सभी आउटलायर्स को UI में एक सुविधाजनक "Outliers" समूह में समेकित किया जाता है।
ये दो एल्गोरिदम सर्वर रिस्पॉन्स को स्वचालित रूप से पहचानने का एक आसान तरीका प्रदान करने चाहिए जो सामग्री में भिन्न हैं, भले ही रिस्पॉन्स साइज़ रिस्पॉन्स अंतरों का एक अविश्वसनीय माप हो।
एक्सटेंशन लोड करें:
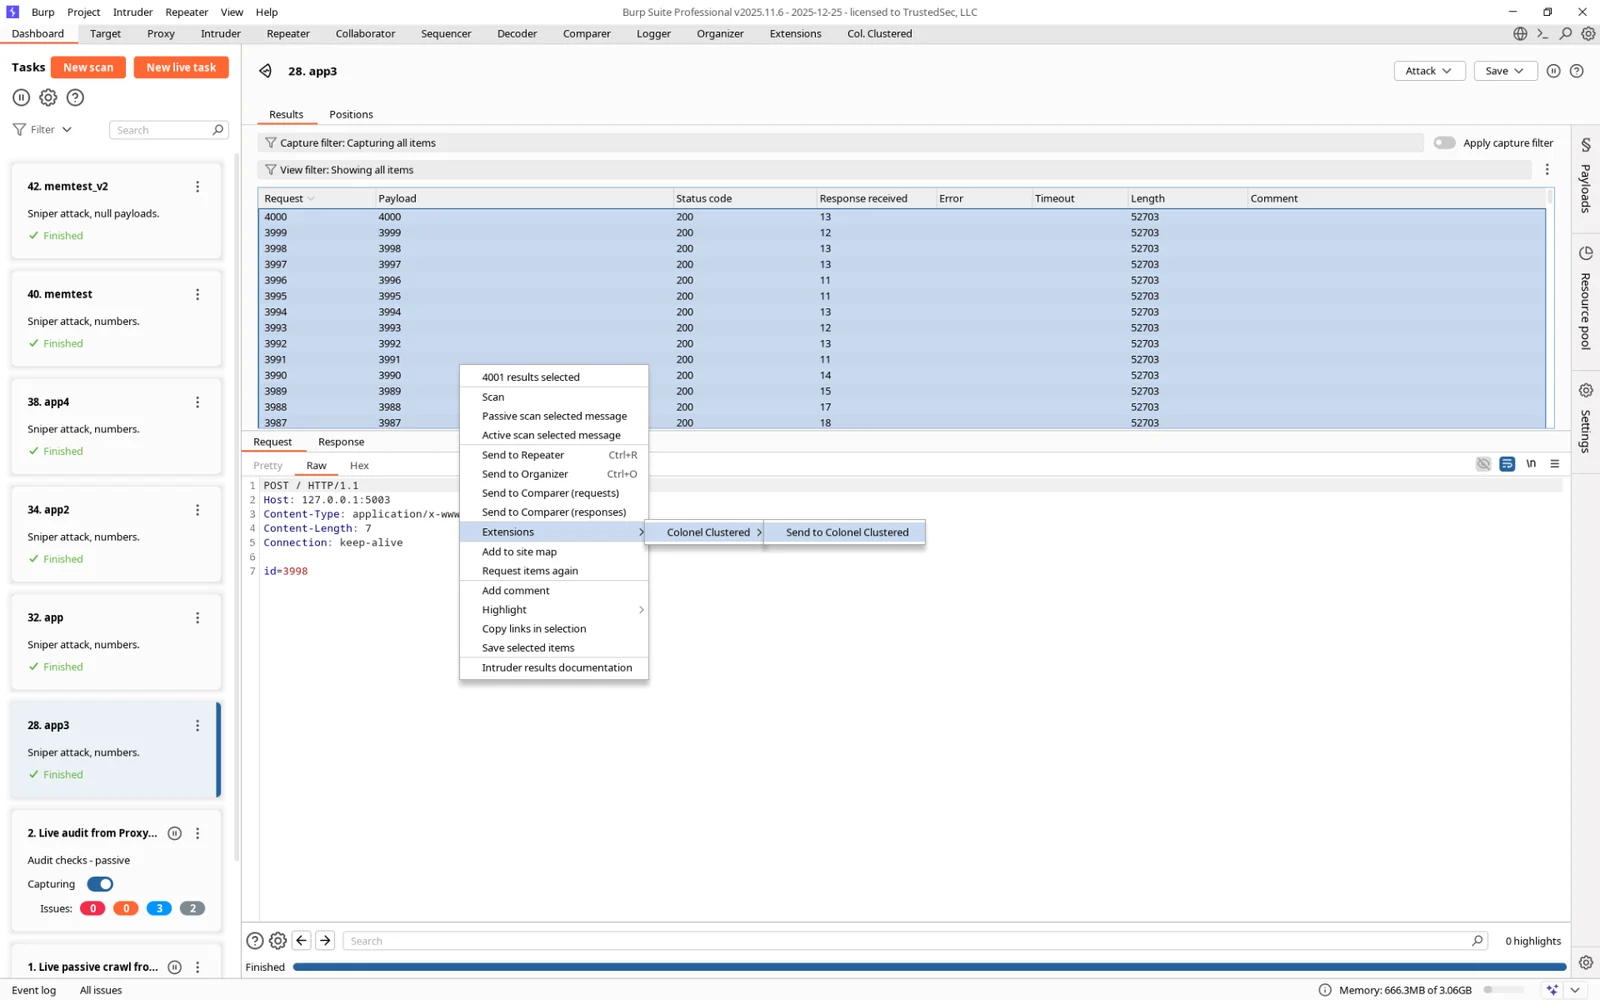
विश्लेषण के लिए रिस्पॉन्स भेजें:
Deep Analysis करें (वैकल्पिक):
Quad-Pane UI में परिणामों का विश्लेषण करें:
Request/Response Pair: आइटम का मूल इंडेक्स।Status Code: HTTP रिस्पॉन्स स्टेटस कोड।Length: रिस्पॉन्स बॉडी की लंबाई बाइट्स में।Content-Type: रिस्पॉन्स का Content-Type हेडर।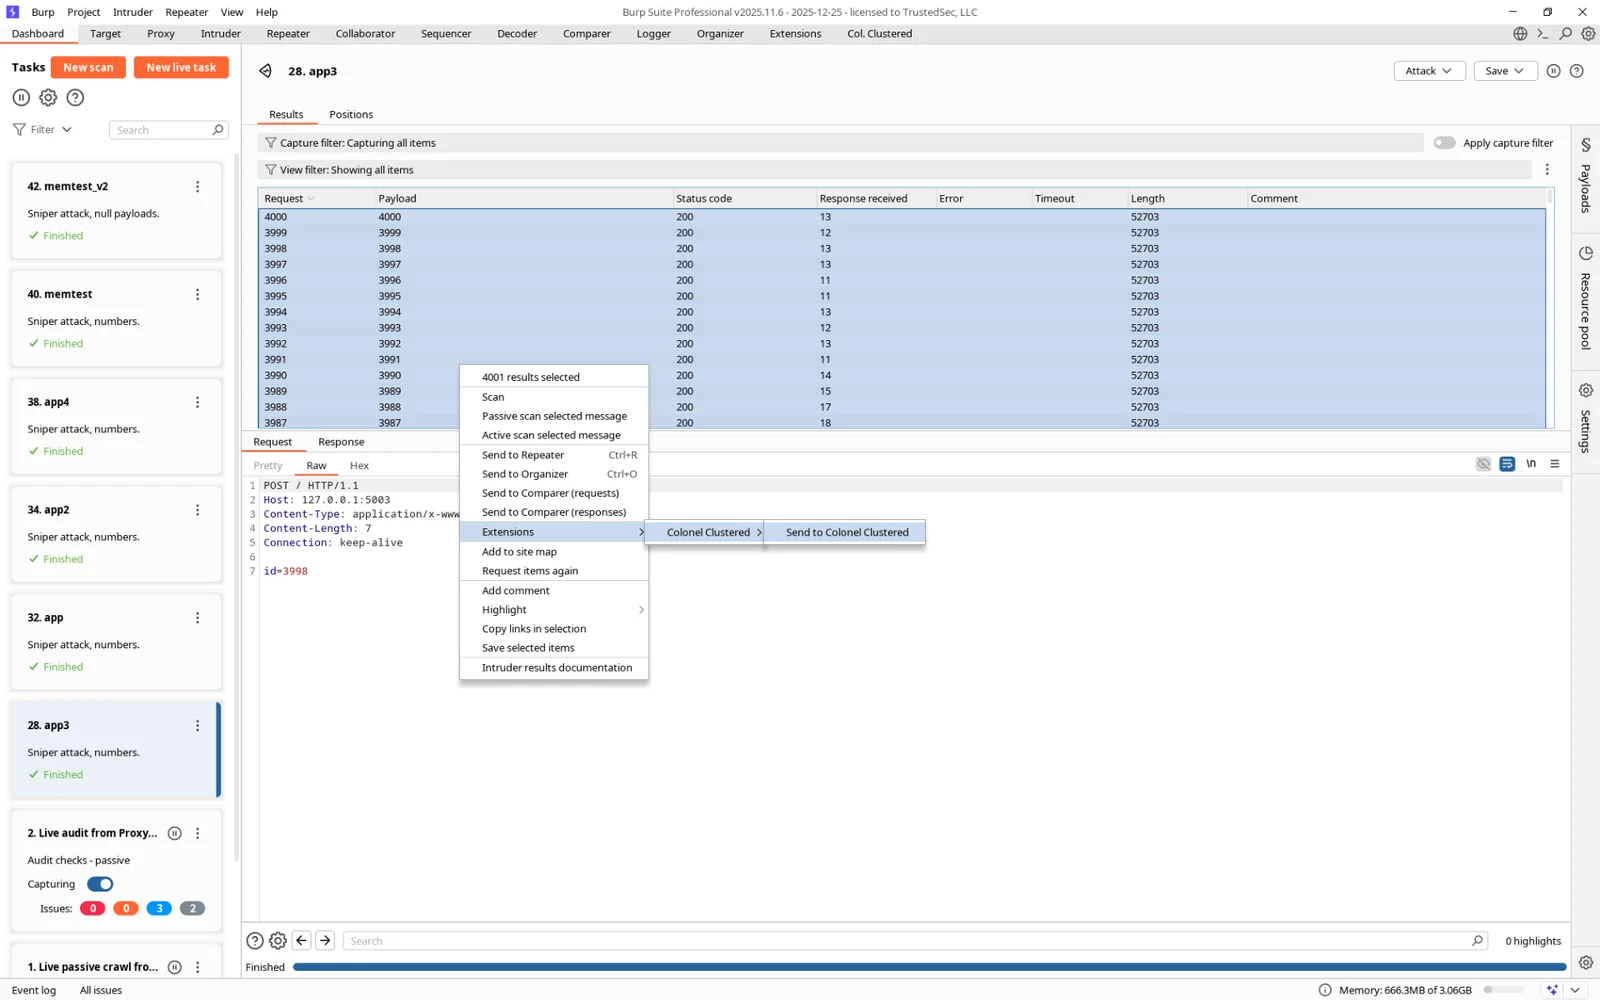
यह प्रोजेक्ट Gradle का उपयोग करता है। प्लगइन बिल्ड करने के लिए आपके पास JDK संस्करण 17 इंस्टॉल होना चाहिए।
git clone <repository-url>
cd ColonelClustered
./gradlew build
build/libs/ColonelClustered.jar पर स्थित होगा।Drew Kirkpatrick
@hoodoer
[email protected]
आप मुझे Blackthorne Consulting पर पा सकते हैं।
यह प्रोजेक्ट Unlicense के तहत पब्लिक डोमेन में जारी किया गया है। विवरण के लिए LICENSE फ़ाइल देखें।
