

 amd2g2zz/kunglao-agent
रिवर्स-इंजीनियरिंग विशेषज्ञ एजेंट: अपना विश्लेषण पथ स्वयं की योजना बनाता है, प्रत्येक तथ्य को कच्चे साक्ष्य से प्राप्त करता है, और यांत्रिक सत्यापन गेट्स के अंतर्गत अभिसरित होता है — फर्मवेयर, प्रोटोकॉल, वेब/JS, जोखिम-नियंत्रण, बाइनरी।
एक स्वायत्त रिवर्स-इंजीनियरिंग एजेंट जो घंटों तक बिना निगरानी के चलता है, हर निष्कर्ष को स्वतंत्र रूप से सत्यापित करता है, और केवल तब अभिसरित होता है जब हर उत्तर एक यांत्रिक ओरेकल निर्णय से टिक पाता है।


🧠 अपना मार्ग स्वयं योजना बनाता है · 🔬 हर दावा मशीन-जाँचा गया · ⚖️ हर चीज़ पर ब्लाइंड सत्यापन · 📈 लूप स्वयं को मापता है
🚀 त्वरित शुरुआत · ✨ मुख्य तकनीक · 🧠 kunglao × Claude Code · 🎛️ RL कैसे काम करता है · 🖥️ शोकेस · 📖 केस स्टडीज़ · 🧪 मूल्यांकन · 🏗️ आर्किटेक्चर · 🗓️ रोडमैप
English · 简体中文
[!WARNING] v0.1.6 अंतिम Claude Code-नेटिव रिलीज़ लाइन है। अगला माइलस्टोन (v0.2) रनटाइम को पूरी तरह PI Agent बेस पर स्थानांतरित करता है — वही लूप, वही लेजर, नया इंजन सब्सट्रेट। रोडमैप देखें।
आप kunglao-agent को एक लक्ष्य पर इंगित करते हैं और प्रश्न बताते हैं; यह मार्ग की योजना बनाता है, विशेषज्ञ वर्कर भेजता है, हर निष्कर्ष को स्वतंत्र रूप से सत्यापित करता है, और तभी रुकता है जब प्रत्येक उत्तर किसी मॉडल के कथन के बजाय एक यांत्रिक जाँच द्वारा तय हो जाता है।
लक्ष्य स्पेक्ट्रम पूरा है — Windows/Linux नेटिव बाइनरीज़, Android APKs (नेटिव
.so परतों सहित), web/JS, प्रोटोकॉल रिकवरी, फर्मवेयर —
डिज़ाइन से स्टैटिक-फर्स्ट, जो भी निष्पादन चैनल आपके वातावरण में पहले से है
उसे चलाते हुए (VMware, ssh, docker, adb, या स्टैटिक-ओनली कार्य के लिए कोई नहीं)।
यह Claude Code के भीतर एक प्लगइन के रूप में चलता है: Claude Code बातचीत की सतह है; उत्पाद लूप और वह तथ्य-आधार है जो यह उत्पन्न करता है।
[!NOTE] लूप जो भी संख्या रिपोर्ट करता है — जीत दर, पोस्टीरियर, बजट — वह एक अपेंड-ओनली लेजर पर एक पंक्ति तक अनुरेखित होती है। कुछ भी स्व-घोषित नहीं है।
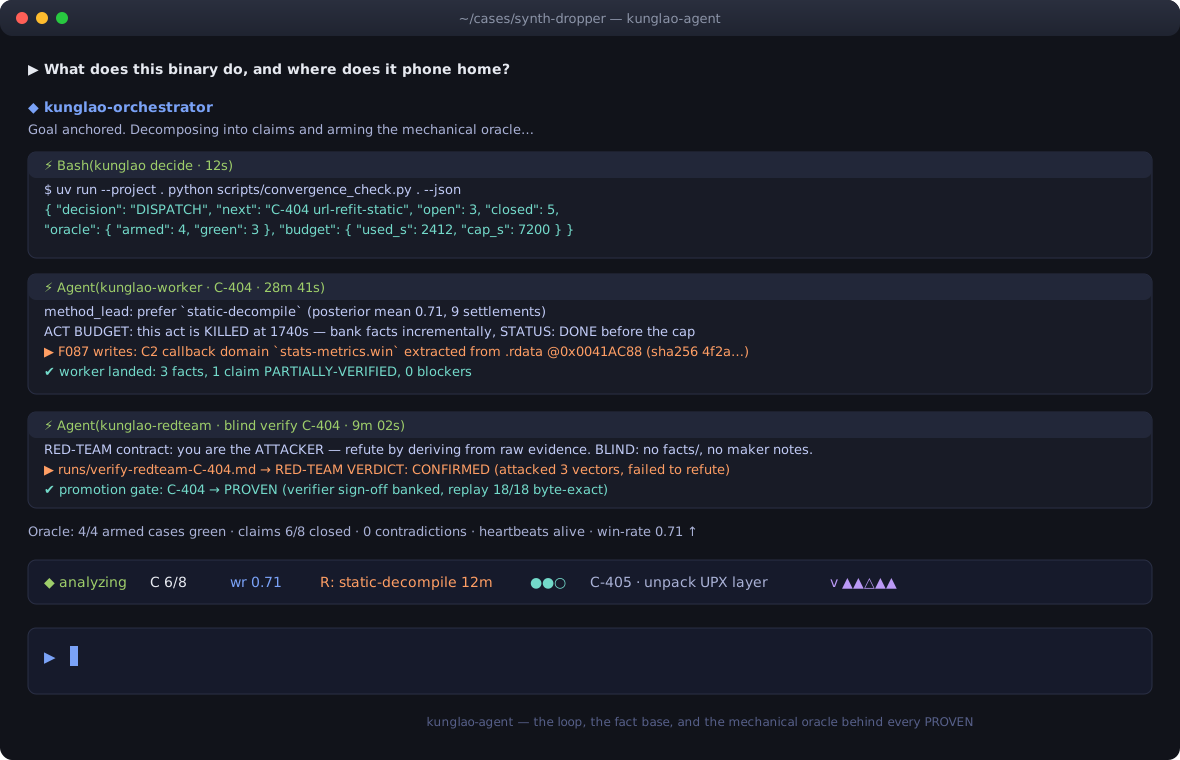
ऑर्केस्ट्रेटर कार्यरत — एक अभिसरण निर्णय, लाइव तथ्यों के साथ एक बजटेड
वर्कर डिस्पैच, और एक ब्लाइंड रेड-टीम निर्णय जो एक दावे को PROVEN में
पदोन्नत करता है; स्टेटसलाइन HUD पूरे एंगेजमेंट को एक नज़र में पठनीय रखता है:
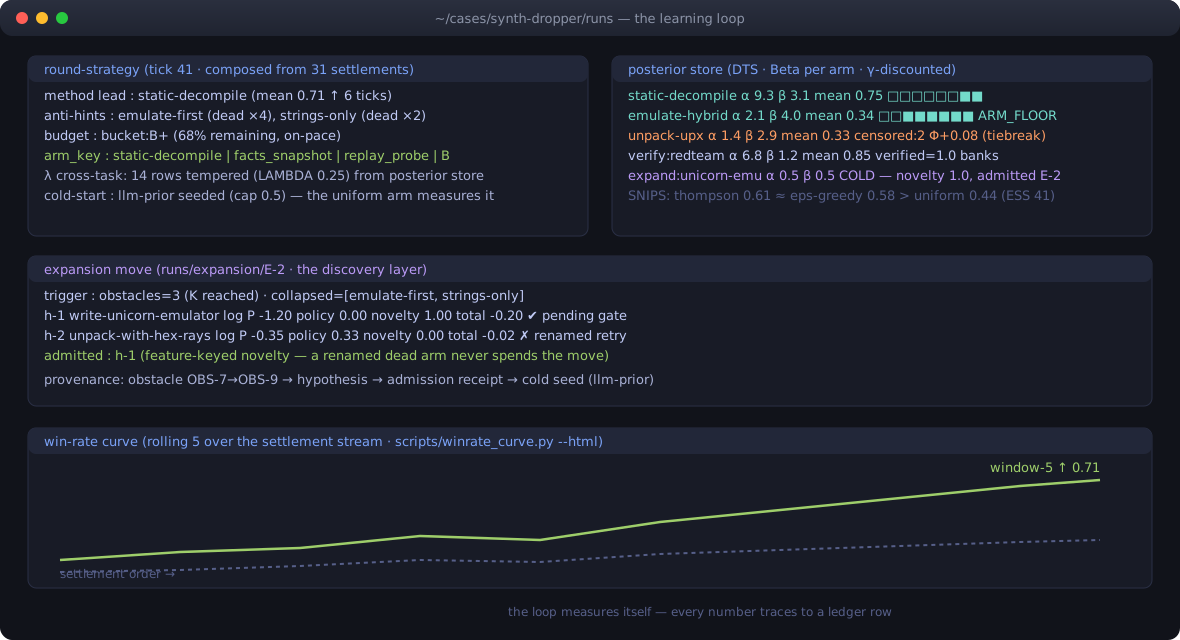
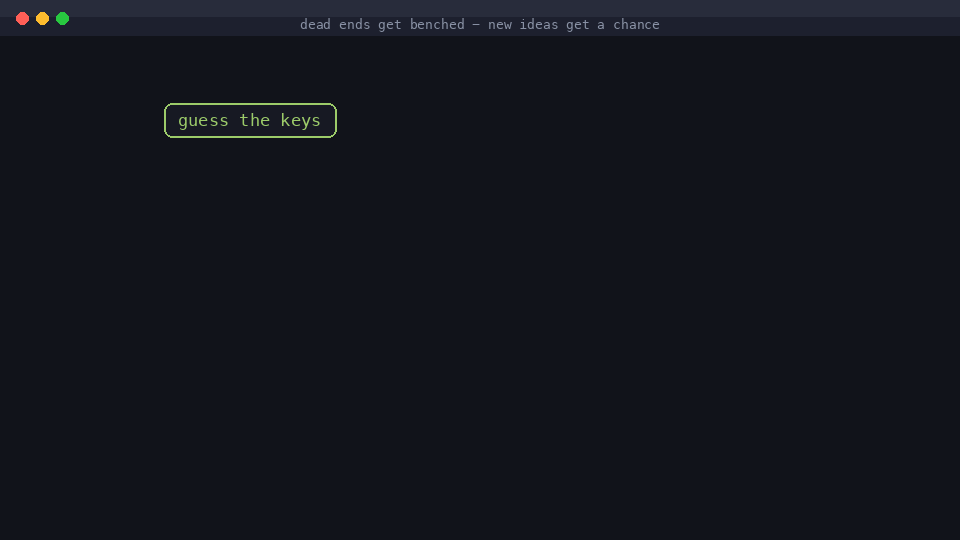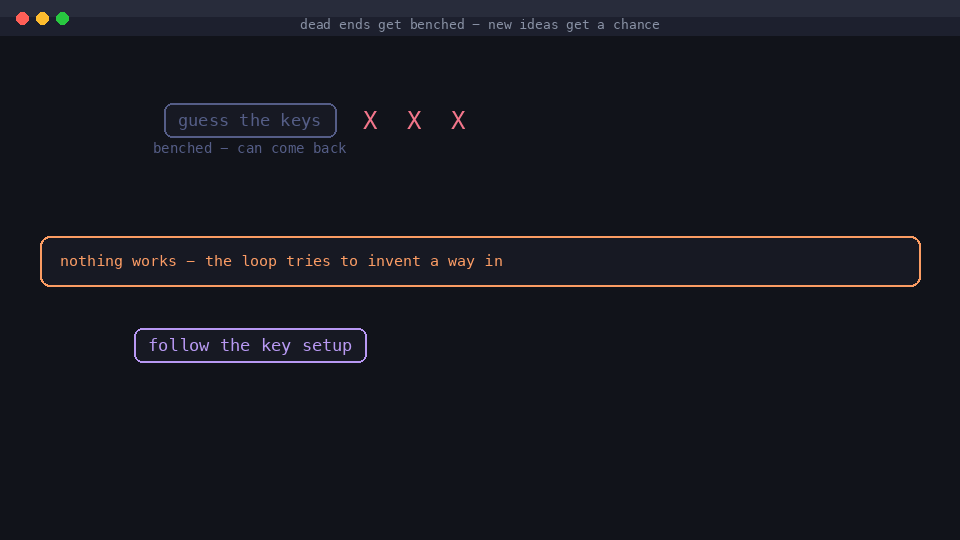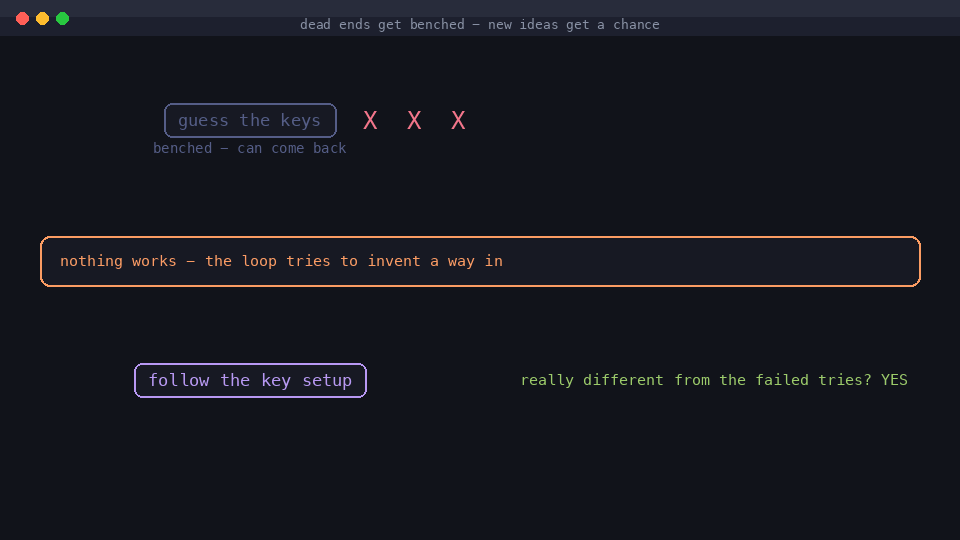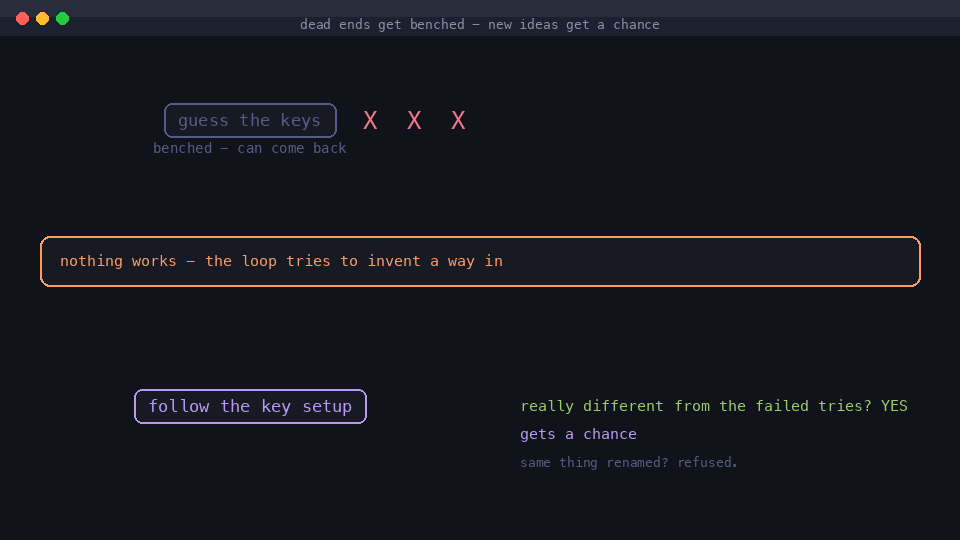
लूप स्वयं को मापता हुआ — सेटलमेंट्स से रचित राउंड रणनीति, सेंसर्ड-आउटकम टाईब्रेकिंग के साथ डिस्काउंटेड-थॉम्पसन पोस्टीरियर स्टोर, डिस्कवरी परत जो एक वास्तविक नए आर्म को स्वीकार करती है (और एक नाम-बदले पुनःप्रयास को अस्वीकार करती है), और जीत-दर वक्र:
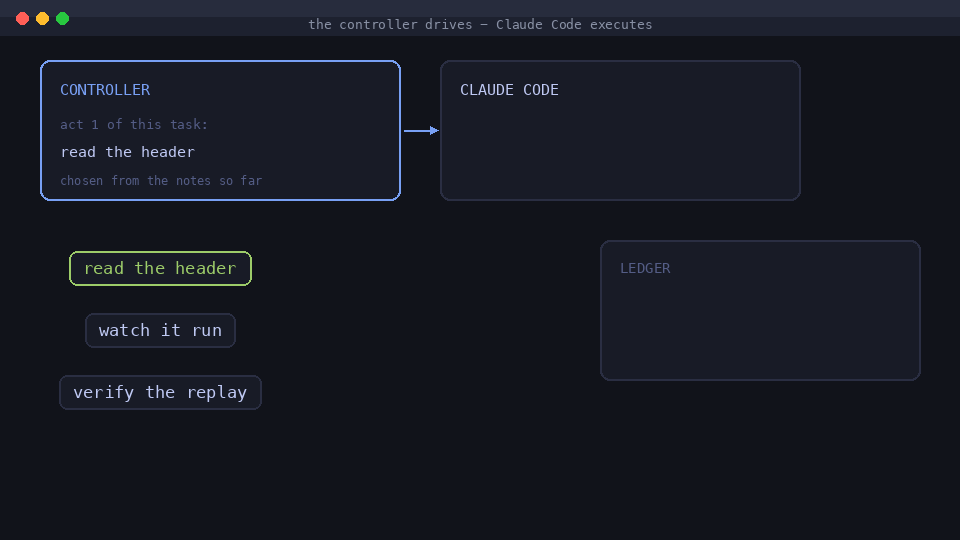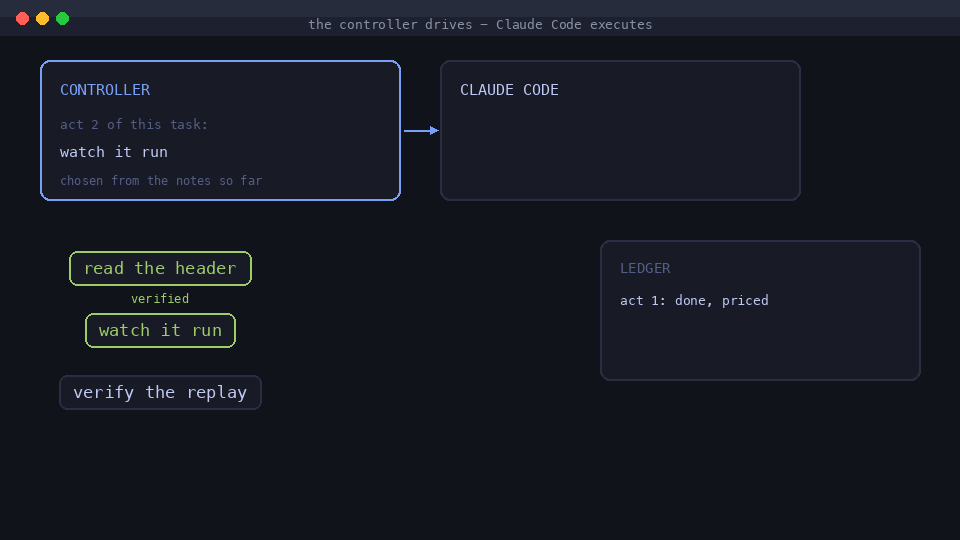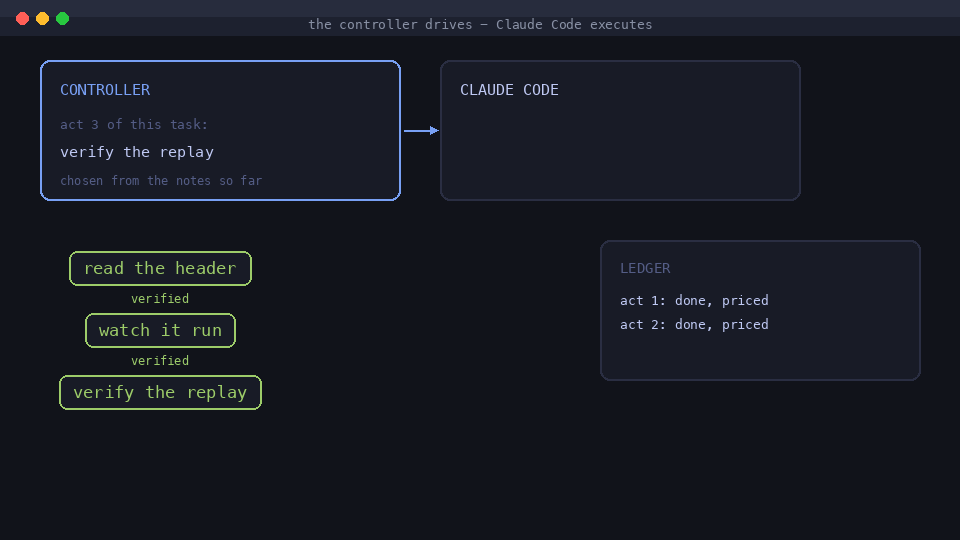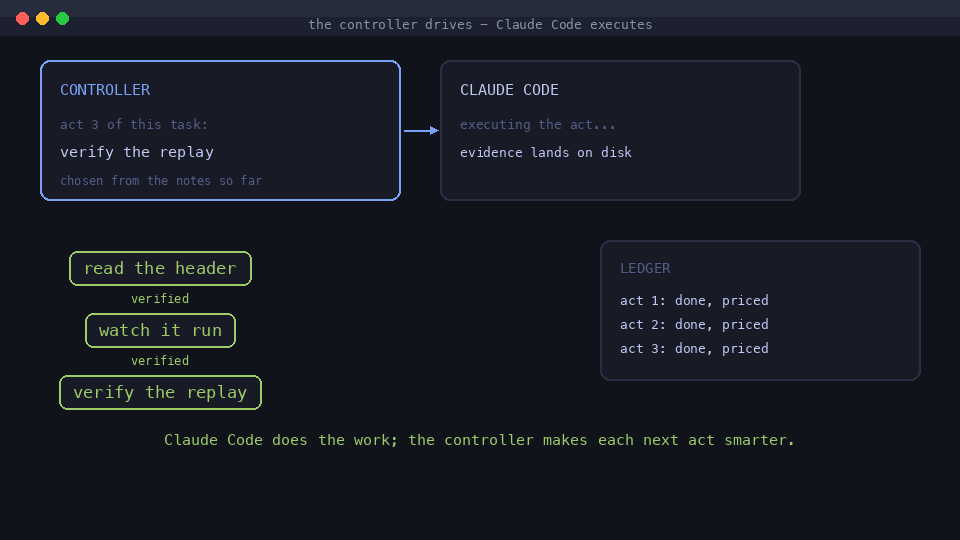
kunglao-agent Claude Code के चारों ओर एक act-स्तरीय RL कंट्रोलर है: Claude
Code प्रत्येक act के भीतर तर्क करता है; kunglao अगला act तय करता है, उसे
सत्यापित करता है, उसका मूल्य तय करता है, उससे सीखता है। गहन डिज़ाइन: docs/design/.
STAMP तक सीमित
है, कभी PROVEN नहीं। तथ्य आर्टिफैक्ट्स (sha256) का हवाला देते हैं और
reproduce: कमांड साथ रखते हैं।Claude Code इंजन है; kunglao गियरबॉक्स, डैशबोर्ड, और फ्लाइट कंप्यूटर है — अगला act, सत्यापन, बजट, और अनुभव कहाँ जाता है।
| केवल Claude Code | + kunglao | |
|---|---|---|
| अगला कदम | सत्र में तात्कालिक | सीखी हुई act-स्तरीय नीति, पोस्टीरियर कार्यों में बने रहते हैं |
| सत्यापन | स्व-रिपोर्ट | यांत्रिक ओरेकल + ब्लाइंड रेड-टीम |
| अवधि | एक सत्र, मानव देखता हुआ | घंटों बिना निगरानी, डिस्क से पुनःआरंभ |
| अनुभव | सत्र के अंत में वाष्पित | लेजर → पोस्टीरियर → तीक्ष्ण प्रारंभिक दांव |
ईमानदार सीमा: एक साधारण एकल-सत्र कार्य के लिए, केवल Claude Code जीतता है — मूल्यांकन तालिका यही कहती है। kunglao लंबे क्षितिजों, सत्यापन अनुशासन, और क्रॉस-टास्क कम्पाउंडिंग पर लाभ देता है।
नए प्रकार का पहला कार्य पूरी कीमत चुकाता है: लूप एक विधि आज़माता है, उसे विफल होते देखता है, दूसरी आज़माता है। लेकिन हर प्रयास लिखा जाता है — और उसी प्रकार का अगला कार्य उन नोट्स से शुरू होता है, शून्य से नहीं।
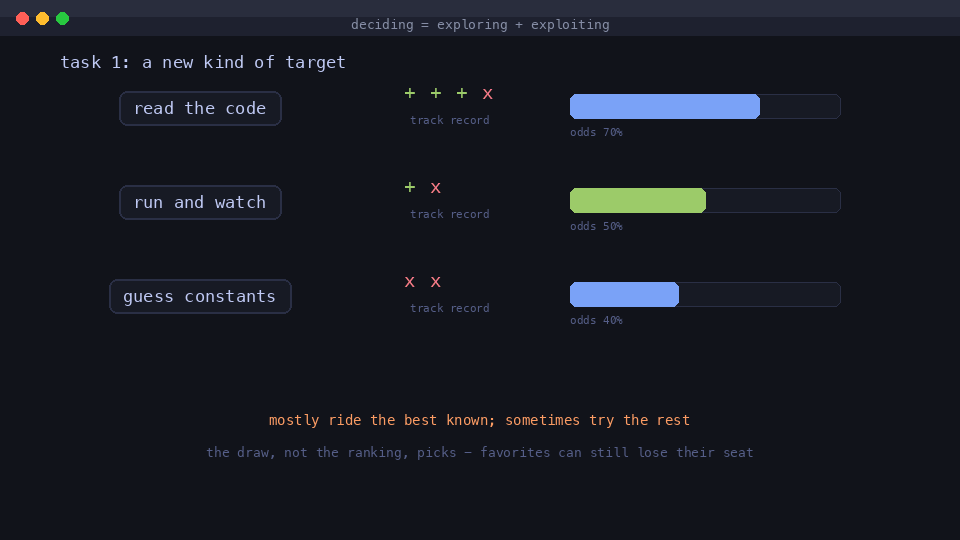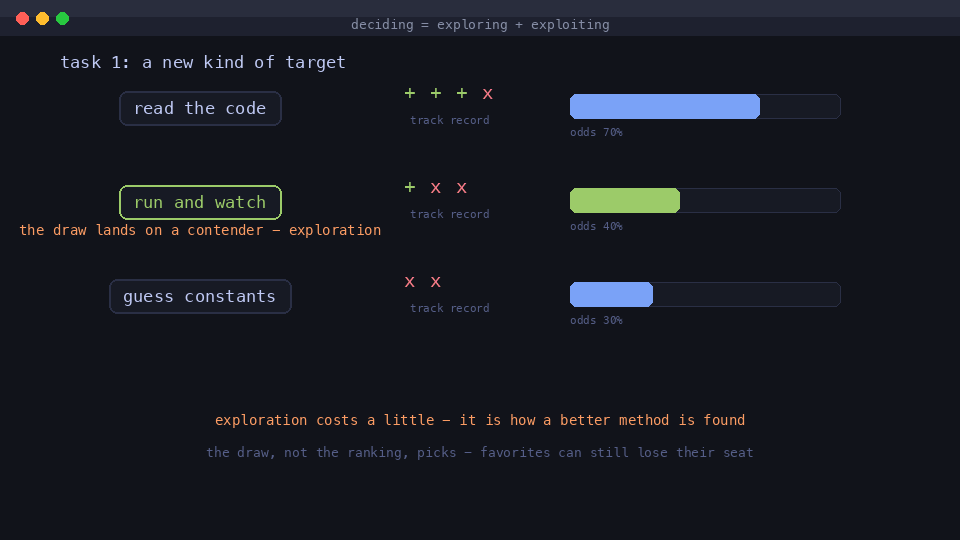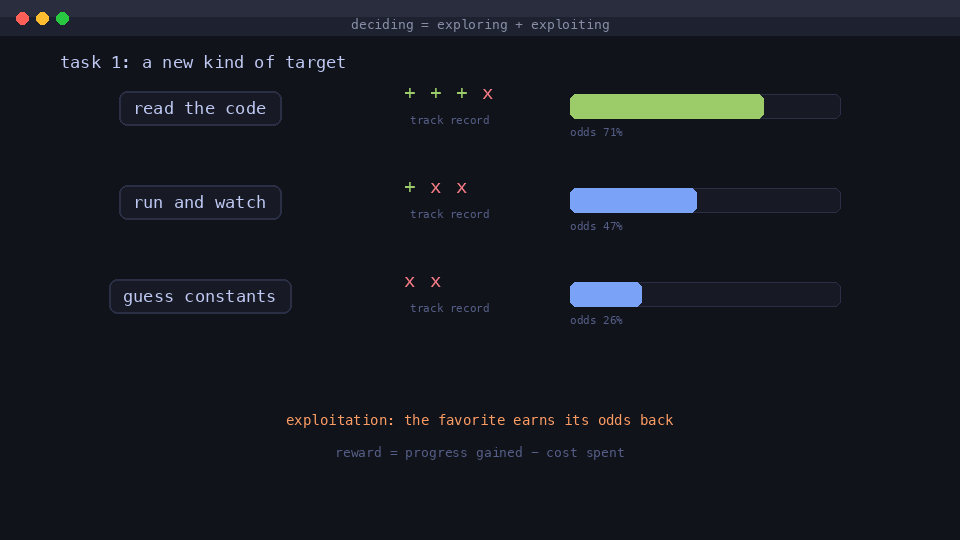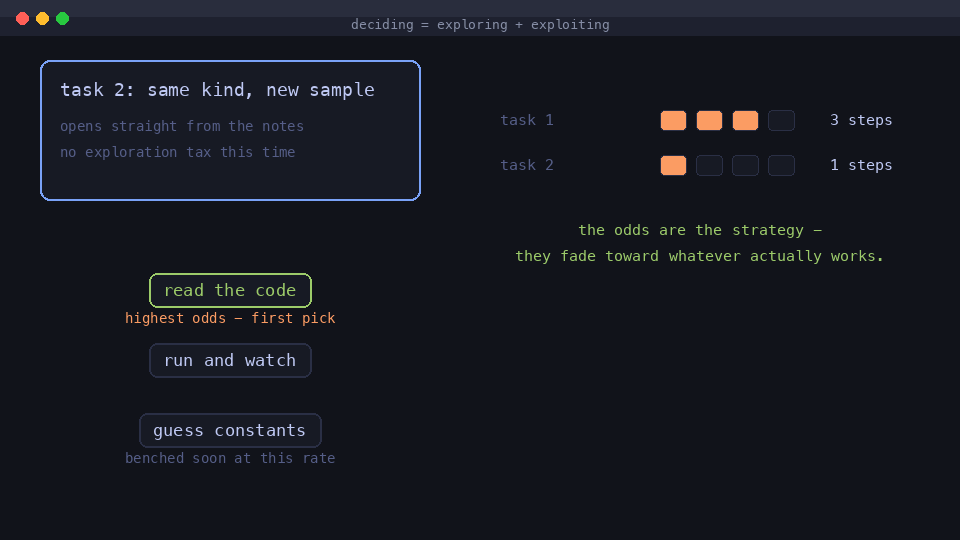
यही यहाँ ऑनलाइन रीइन्फोर्समेंट लर्निंग का पूरा विचार है: लूप काम के दौरान, acts के बीच स्वयं को अद्यतन करता है — कोई प्रशिक्षण डेटासेट नहीं, कोई मॉडल पुनःप्रशिक्षण नहीं, कोई ऑफ़लाइन चरण नहीं। प्रत्येक कार्य का अनुभव अगला निर्णय लेने से पहले बैंक में जमा हो जाता है।
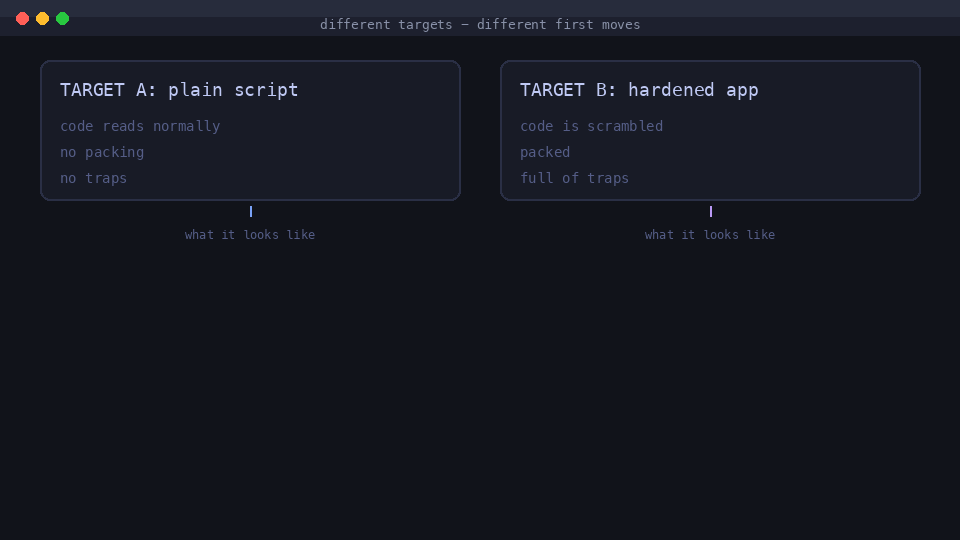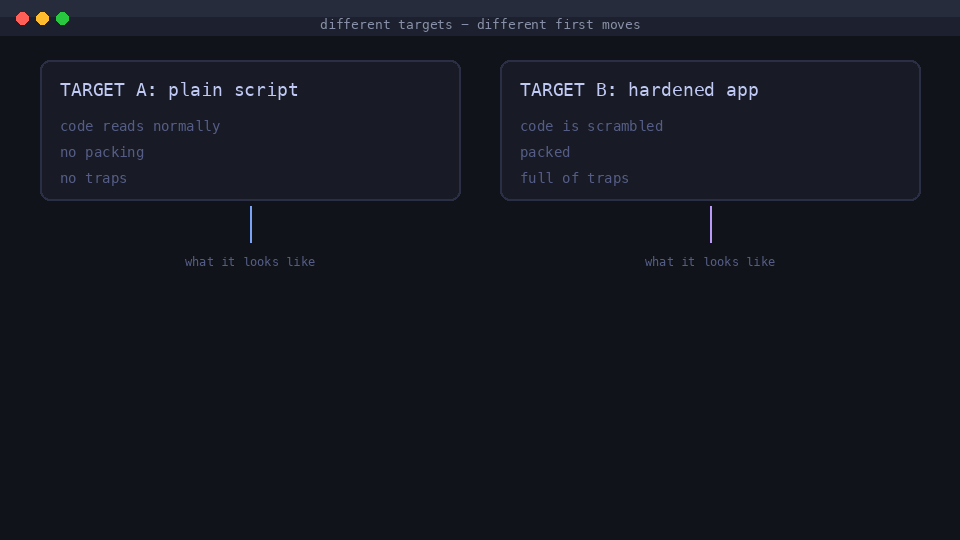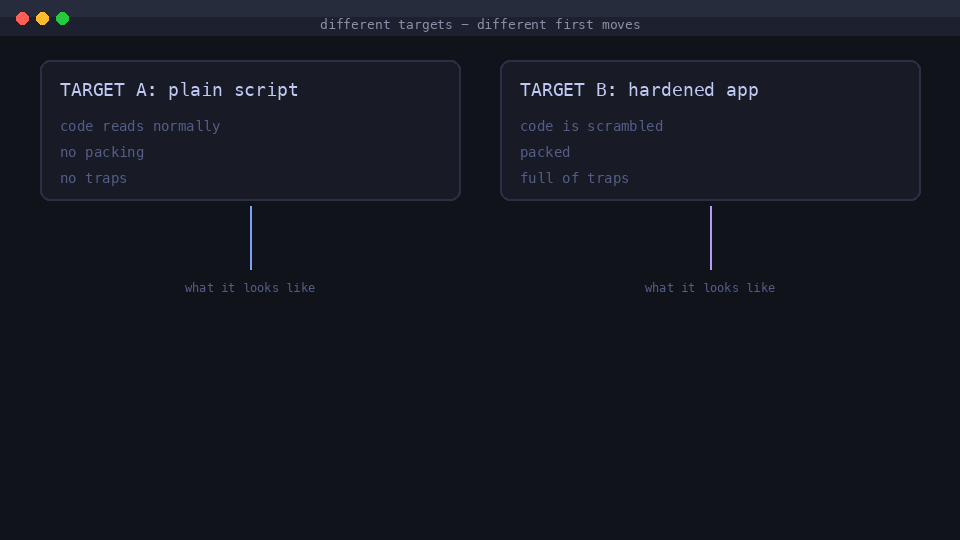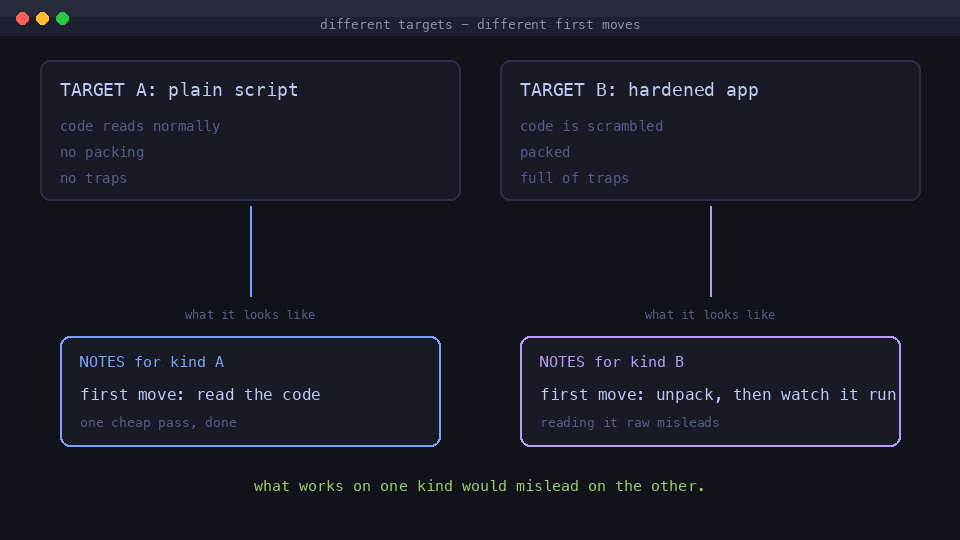
1. प्रत्येक प्रकार के लक्ष्य के लिए सही पहला कदम। एक साधारण स्क्रिप्ट और एक हार्डन्ड ऐप को एक ही तरह से शुरू नहीं होना चाहिए। लूप प्रत्येक प्रकार के लक्ष्य के लिए अलग नोट्स रखता है — लक्ष्य कैसा दिखता है यह तय करता है कि कौन सा प्लेबुक लागू होता है।
2. कौन सी विधियाँ मृत हैं। बार-बार विफल होने वाली विधि बेंच पर चली जाती है — वह बजट खाना बंद कर देती है (लेकिन कभी हटाई नहीं जाती; यदि लक्ष्य बदलता है, तो वह वापस आ सकती है)। और जब कुछ भी काम नहीं करता, तो लूप प्रवेश का रास्ता आविष्कार करने का प्रयास करता है: एक डिस्कवरी act एक वास्तविक नई दृष्टिकोण प्रस्तावित करता है, जिसे विफल प्रयासों के विरुद्ध जाँचा जाता है — वही विचार नए नाम से अस्वीकार कर दिया जाता है।
3. कहाँ दोबारा जाँच करनी है। जिन स्थितियों में सत्यापनकर्ता बार-बार खंडित होते रहते हैं, वहाँ सत्यापन को अधिक कसकर निर्धारित करना सीखते हैं — और जब क्रम ईमानदार हो जाता है तो ढील दे देते हैं। 4. कौन से उपकरण रूट करने हैं। उपकरण और प्रदाता विकल्प भी सीखे जाते हैं: विफल होने वाला उपकरण कुछ समय के लिए अवनत कर दिया जाता है और जैसे ही वह फिर से काम करता है, तुरंत बहाल कर दिया जाता है - रूटिंग दर्ज परिणामों का अनुसरण करती है, रजिस्ट्री क्रम का नहीं।
flowchart LR
    A["target state<br>(what it looks like)"] --> B["pick a method<br>(sample from the notes)"]
    B --> C["act<br>(a worker runs it)"]
    C --> D["checker verdict<br>(proof or no proof)"]
    D --> E["one ledger row<br>(what happened, what it cost)"]
    E --> F["update the notes<br>for this kind of target"]
    F --> B

