Guardrails v0.24.1
LLM चैट ऐप्स के लिए प्रोग्रामेबल गार्डरेल्स: इनपुट/आउटपुट रेल्स लागू करें, जेलब्रेक और प्रॉम्प्ट इंजेक्शन ब्लॉक करें, हैलुसिनेशन का पता लगाएं, और संवेदनशील डेटा मास्क करें।
NVIDIA NeMo Guardrails लाइब्रेरी





दस्तावेज़ीकरण · क्विकस्टार्ट · उपयोग के मामले · इंटीग्रेशन · गार्डरेल कैटलॉग · उदाहरण · समुदाय · सुरक्षा · रिलीज़ · चेंजलॉग
NeMo Guardrails एक ओपन-सोर्स लाइब्रेरी है जो LLM और एजेंटिक एप्लिकेशन पर प्रोग्रामेबल सुरक्षा और संरक्षा नियंत्रण लागू करने के लिए है। एजेंट कमांड चलाते हैं, API कॉल करते हैं, आपके डेटा को क्वेरी करते हैं, और वेब पढ़ते हैं। संवादात्मक एप्लिकेशन इनपुट और आउटपुट जाँच लागू करते हैं; रिट्रीवल-ऑगमेंटेड जनरेशन (RAG) सिस्टम प्राप्त सामग्री को फ़िल्टर करते हैं और उत्तरों को साक्ष्य के विरुद्ध जाँचते हैं।
आप NeMo Guardrails लाइब्रेरी का उपयोग यह घोषित करने के लिए करते हैं कि प्रत्येक एजेंट किसी नीति में क्या कर सकता है, जिसमें कम-विलंबता वाले स्थानीय नियमों को जेलब्रेक, इंजेक्ट किए गए निर्देशों और असुरक्षित टूल कॉल के लिए मॉडल-आधारित जाँचों के साथ जोड़ा जाता है। आपका एप्लिकेशन या एजेंट हार्नेस इन जाँचों को चलाता है और यह तय करने के लिए उनके परिणामों का उपयोग करता है कि आगे बढ़ना है या नहीं।
pip install nemoguardrails
Python 3.11–3.13 आवश्यक है। वैकल्पिक पैकेजों और सेटअप के लिए इंस्टॉलेशन गाइड देखें।
[!NOTE] संस्करण 0.25.0
LLMRailsको अप्रचलित करता है, और इसे 0.27.0 से पहले हटाने की योजना नहीं है। नए एकीकरणों के लिएGuardrailsका उपयोग करें और माइग्रेशन गाइड का पालन करें।
आप क्या बना सकते हैं
- AI एजेंट और कोडिंग सहायक: प्रस्तावित टूल कॉल और लौटाए गए परिणामों को टूल रेल से जाँचें, या किसी एजेंट को हुक्स सर्वर के माध्यम से कनेक्ट करें।
- संवादात्मक अनुप्रयोग: इनपुट और आउटपुट जाँच लागू करें।
- रिट्रीवल-ऑगमेंटेड जनरेशन (RAG): प्राप्त सामग्री में संवेदनशील डेटा का पता लगाएँ या उसे मास्क करें और जाँचें कि उत्तर साक्ष्य पर आधारित हैं या नहीं।
यह कैसे काम करता है
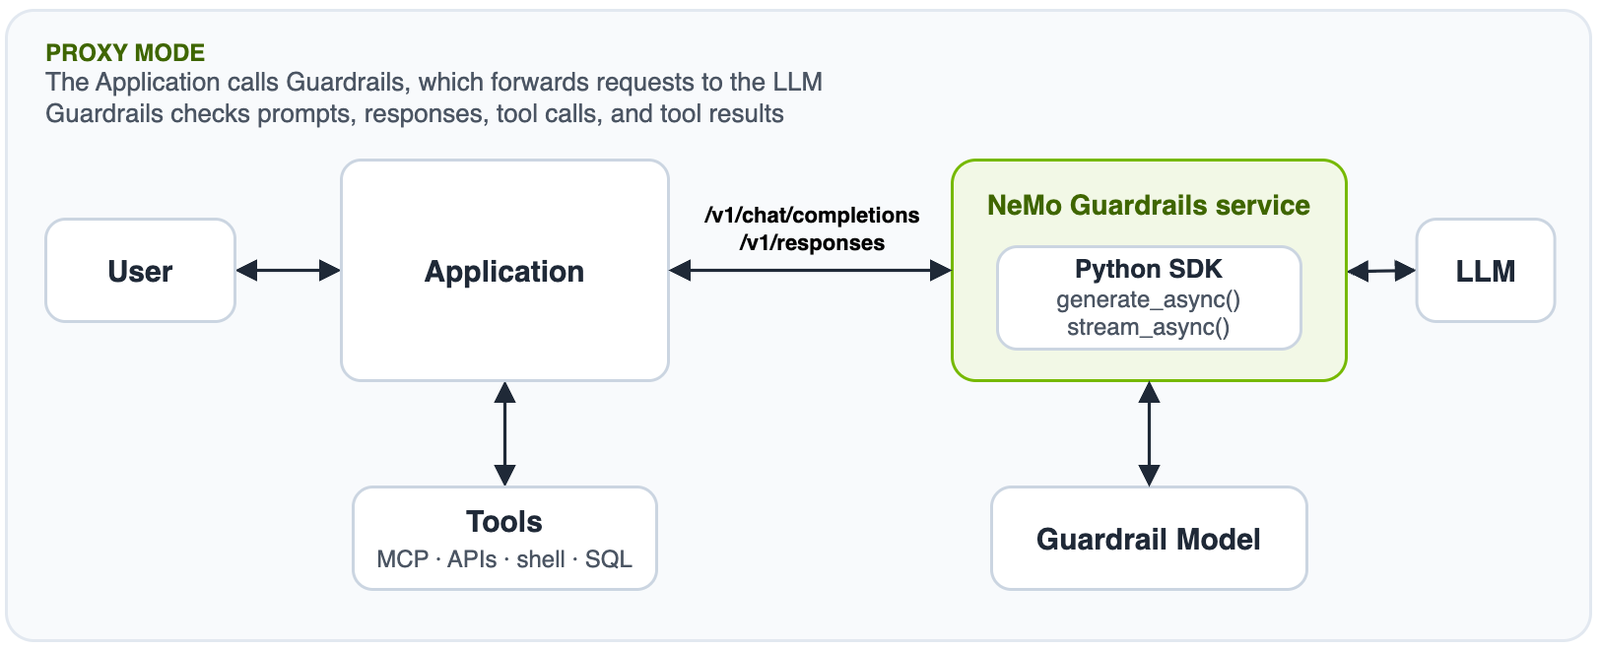
अपनी नीति को कॉन्फ़िगरेशन फ़ाइलों में परिभाषित करने के लिए NVIDIA NeMo Guardrails लाइब्रेरी का उपयोग करें, जो उपयोग किए जाने वाले रेल, मॉडल और प्रॉम्प्ट निर्दिष्ट करती हैं। लाइब्रेरी को अपने Python अनुप्रयोग में चलाएँ या इसे सर्वर के रूप में तैनात करें। अपना अनुप्रयोग मॉडल अनुरोधों को कैसे प्रबंधित करता है, इसके आधार पर चेक मोड या प्रॉक्सी मोड चुनें।
चेक मोड
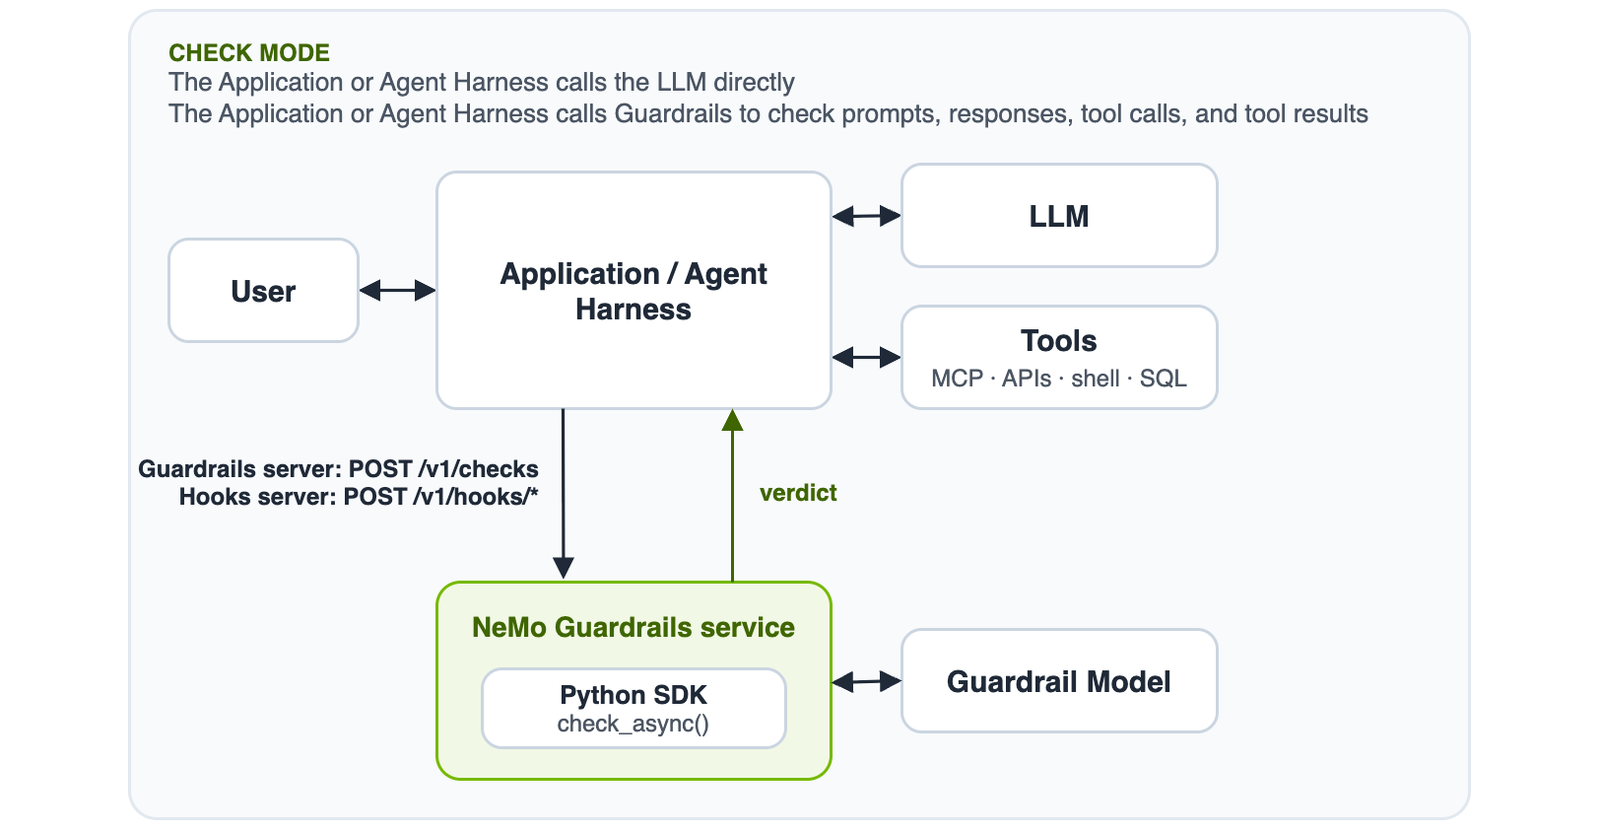
आपका अनुप्रयोग या एजेंट हार्नेस सीधे LLM को कॉल करता है और टूल निष्पादित करता है। प्रत्येक ऐसे बिंदु पर जहाँ नीति निर्णय की आवश्यकता होती है, संबंधित प्रॉम्प्ट, मॉडल प्रतिक्रिया, टूल कॉल या टूल परिणाम को जाँच के लिए लाइब्रेरी को भेजें। किसी टूल को निष्पादित करने, प्रतिक्रिया लौटाने, या मॉडल को टूल परिणाम पास करने से पहले अवरुद्ध या संशोधित सामग्री को संभालने के लिए परिणाम का उपयोग करें।
Python में check_async(), Guardrails सर्वर पर POST /v1/checks, या कोडिंग एजेंट के लिए हुक्स सर्वर का उपयोग करें।
check_async() के साथ टूल जाँच के लिए, IORails इंजन का उपयोग करें और rail_types में RailType.TOOL_CALL या RailType.TOOL_RESULT निर्दिष्ट करें।
निष्पादन से पहले टूल कॉल और निष्पादन के बाद टूल परिणामों की जाँच करें।
प्रॉक्सी मोड
कॉन्फ़िगर किए गए इनपुट और आउटपुट रेल लागू करने के लिए मॉडल अनुरोधों को लाइब्रेरी के माध्यम से रूट करें। इनपुट रेल अनुप्रयोग LLM तक पहुँचने से पहले अनुरोध को अवरुद्ध कर सकते हैं। गैर-स्ट्रीमिंग अनुरोधों के लिए, आउटपुट रेल लाइब्रेरी द्वारा इसे लौटाने से पहले प्रतिक्रिया की जाँच करते हैं। अवरुद्ध सामग्री एकीकरण और कॉन्फ़िगरेशन के आधार पर इनकार या त्रुटि उत्पन्न करती है।
Python में generate_async() या stream_async() का उपयोग करें, या Guardrails सर्वर पर POST /v1/chat/completions का उपयोग करें।
आपका अनुप्रयोग टूल निष्पादित करता है; समर्थित एकीकरण मॉडल प्रतिक्रियाओं में टूल कॉल और बाद के अनुरोधों में टूल परिणामों की जाँच कर सकते हैं।
गेटवे सर्वर भी POST /v1/chat/completions और POST /v1/responses का समर्थन करता है, लेकिन इसके अंतर्निहित प्रोफ़ाइल टूल सामग्री का समर्थन नहीं करते हैं।
प्रत्येक गेटवे /v1/responses अनुरोध में "store": false शामिल होना चाहिए।
जब stream_async() के लिए आउटपुट स्ट्रीमिंग सक्षम होती है, तो डिफ़ॉल्ट stream_first: true सेटिंग चंक्स को जाँचने से पहले उन्हें वितरित करती है।
प्रत्येक चंक को वितरण से पहले जाँचने के लिए, rails.output.streaming.stream_first: false सेट करें।
कॉन्फ़िगरेशन विवरण के लिए, आउटपुट रेल स्ट्रीमिंग देखें।