
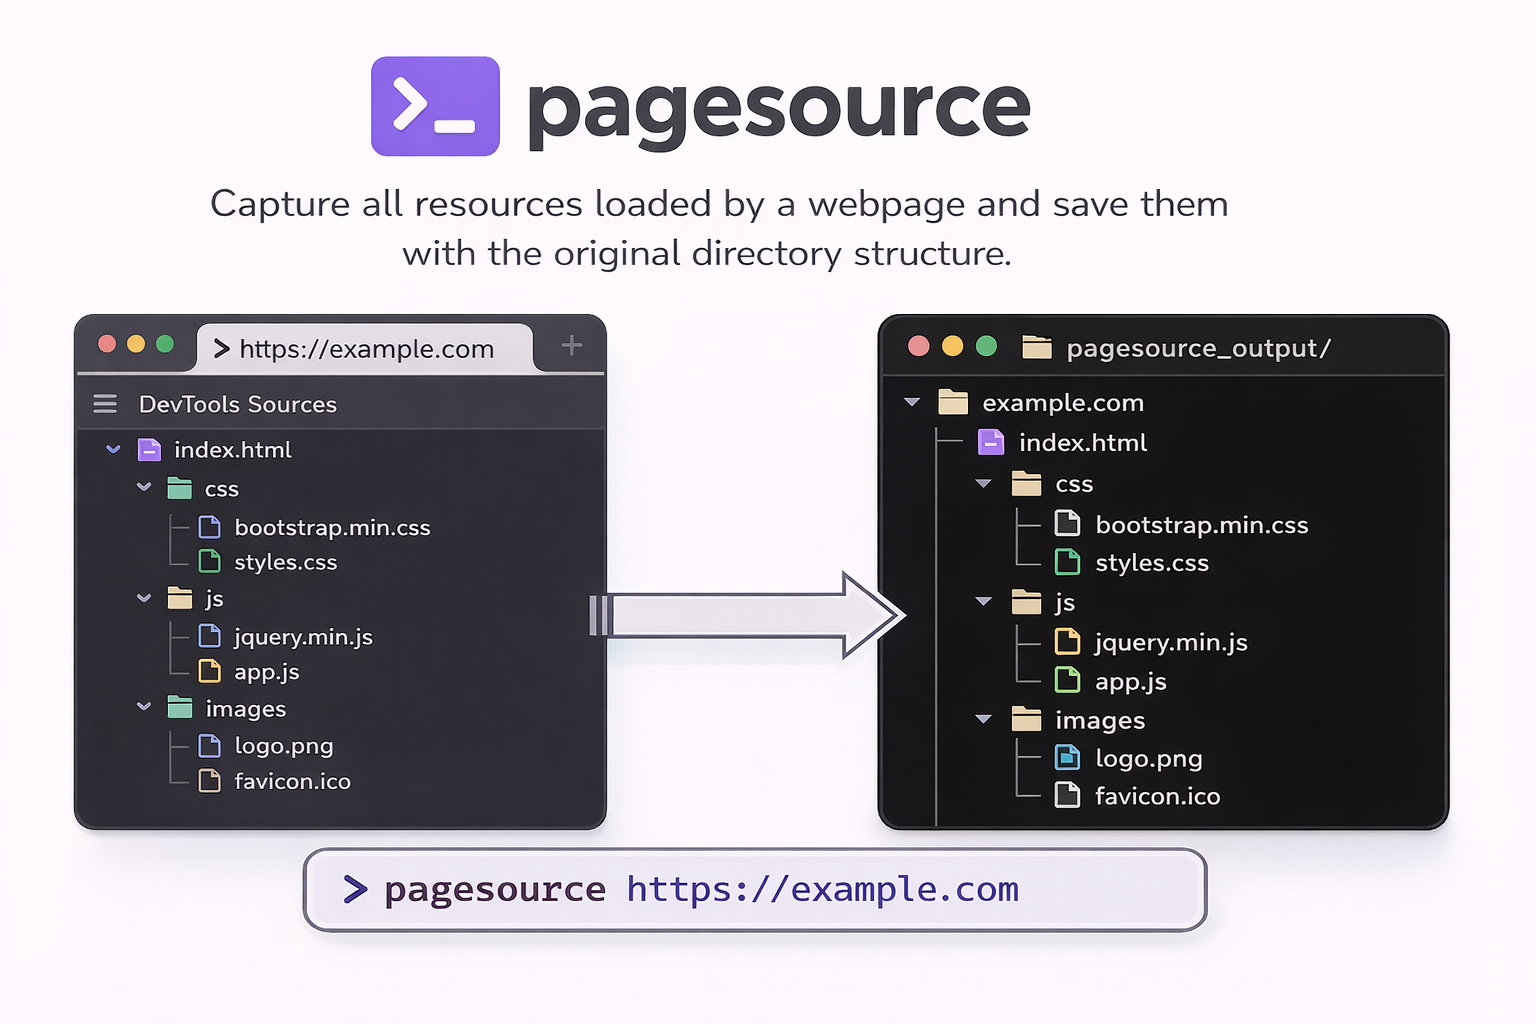
pagesource
 timf34/pagesource
CLI pour télécharger les véritables JS/CSS/assets des sites web (pas du HTML aplati)
general-purpose-utilitiesreconnaissanceinformation-gathering+3
timf34/pagesourceCLI pour télécharger les véritables JS/CSS/assets des sites web (pas du HTML aplati)
 dgtlmoon/changedetection.io
Le meilleur et le plus simple des outils pour la détection de changements sur les sites web, la surveillance de pages web et les alertes de…
 mthbernardes/fses
Fucking Search Engines Scraper - bibliothèque python pour extraire des URLs des moteurs de recherche
 3radiance/mitm-proxy-ja3-ja4
Proxy MITM HTTP configurable en Rust avec usurpation d'empreinte TLS, HTTP/2 et TCP.
 ge0rg3/requests-ip-rotator
Une bibliothèque Python pour utiliser le vaste pool d'IP d'AWS API Gateway comme proxy afin de générer des IP pseudo-infinies pour le web scraping et…
 hackmanit/web-cache-vulnerability-scanner
Scanner CLI basé sur Go pour le web cache poisoning et la deception. Supporte 10 techniques de poisoning, plusieurs méthodes de deception, un crawler…
 dedsecinside/torbot
Parcourt les sites .onion via Tor pour collecter les titres de pages, les noms d'hôtes et les relations de liens, en exportant des arborescences JSON…
 ultrafunkamsterdam/nodriver
Successeur d'Undetected-Chromedriver. Fournissant un framework ultra-rapide pour l'automatisation web, le web scraping, les bots et toute autre idée…
 seladb/pcapplusplus
Bibliothèque C++ multiplateforme pour la capture, l'analyse, la création et l'analyse de paquets réseau haute performance. Prend en charge libpcap,…
 emrekybs/signalops
# Tableau de bord de fusion de renseignements toutes sources — WiFi, cellulaire, CCTV, ADS-B, orbital et flux SDR unifiés en une seule carte…
 apify/crawlee
Bibliothèque Node.js de scraping web et d'automatisation de navigateur pour créer des crawlers fiables avec prise en charge HTTP et navigateur…
 hilmiazizi/oorecon
Interface terminale pour la découverte de la surface d'attaque : reconnaissance DNS, énumération de sous-domaines, scan de ports, reverse IP, URLs de…
 sullo/nikto
Nikto scanner de serveur web
 hehpollon/instagram-crawler
Sans API. Crawling des publications (photo, likes, commentaires, date ...) par nom d'utilisateur, hashtags
 davidvoitenko/proxy-workbench
Collecte, vérifie et classe les proxys HTTP/SOCKS publics par rapport à vos propres cibles, puis les sert via des exports classés, des pools, une…
 ejfkdev/dj
Extrait dynamiquement les fichiers JavaScript chargés en analysant statiquement le HTML et le JS d'un site web, en détectant les chunks webpack, le…
 naibowang/easyspider
A visual no-code/code-free web crawler/spider易采集:一个可视化浏览器自动化测试/数据采集/网页爬虫软件,可以无代码图形化的设计和执行爬虫任务。别名:ServiceWrapper面向Web应用的智能化服务封装系统。
 bigbodycobain/shadowbroker
Real-time geospatial OSINT platform aggregating 60+ public telemetry feeds (ADS-B, AIS, satellites, CCTV) into a unified map with server-side recon…