 noahware/binprotect
Obfuscateur x64 PE bin2bin qui n'ajoute pas de section au binaire

Voir 4. Construction pour les instructions de construction.
Cet obfuscateur est bin2bin, ce qui signifie qu'il prend un exécutable déjà compilé et le reproduit avec les passes d'obfuscation appliquées. Cela peut être utilisé pour protéger une application sans avoir accès au code source original. Seuls les fichiers x64 PE (exécutable portable) sont actuellement pris en charge, mais il est prévu d'ajouter le support d'autres formats binaires (par exemple ELF) à l'avenir.
Actuellement, tous les obfuscateurs bin2bin bien connus insèrent une section à la fin du binaire pour y placer le code ou les données obfusqués. Cela permet de préserver la disposition originale du binaire sans avoir à modifier le contenu des sections préexistantes. Cela est beaucoup plus facile à gérer car la plupart des RVA (adresses relatives) restent valides.
Ce projet adopte une approche unique du bin2bin, où tout code ou donnée obfusqué est inséré dans les sections originales du binaire. Cela nécessite de suivre chaque RVA dans l'application. Les avantages de cette approche sont les suivants :
Ce document décrira à la fois la réécriture du binaire exécutable et les techniques d'obfuscation implémentées. Les techniques d'obfuscation suivantes ont été implémentées :
De plus, ce projet prend également en charge les exceptions (exceptions C++ et SEH) et peut obfusquer les fonctions qui gèrent les exceptions.
Pour faciliter le désassemblage et la découverte du code dans le binaire, des fichiers de symboles (PDB et MAP) sont acceptés en option. La fourniture de fichiers de symboles n'est pas obligatoire mais facilite le désassemblage dans les binaires complexes. Certaines fonctionnalités telles que la prise en charge des exceptions et l'aplatissement du flux de contrôle nécessitent qu'un fichier de symboles soit fourni.
Un réécriveur binaire prend un fichier exécutable et modifie le code ou les données qu'il contient pour produire un binaire de sortie avec les modifications appliquées.
Comme le code obfusqué est inséré directement dans les sections originales du binaire, les adresses relatives du programme doivent être suivies afin que toutes les références à ces adresses puissent être ajustées. Cela permet aux références de toujours pointer vers le même emplacement après l'insertion du code et des données. Sinon, les données ou le code seraient accédés au mauvais emplacement, modifiant ainsi le comportement du binaire de sortie et provoquant une grave instabilité.
Chaque fois qu'une référence à une adresse relative est trouvée (par exemple, instruction contenant des opérandes relatifs à rip ou des répertoires de données PE), elle est ajoutée à une liste de suivi pour être mise à jour à la fin de la réécriture. L'adresse RVA où se produit la référence est suivie (pour savoir où mettre à jour la référence) ainsi que l'adresse RVA référencée (pour savoir avec quelle RVA mettre à jour la référence).
Lorsque le désassembleur trouve une instruction relative à rip, il l'ajoute à une liste de références à mettre à jour à la fin de l'obfuscation. Cela garantit que toutes ces instructions pointent toujours vers l'emplacement qu'elles avaient à l'origine. D'autres cas d'instructions relatives (tels que les tables de saut) sont également ajoutés comme références à mettre à jour.
Toutes les adresses RVA suivies doivent être ajustées chaque fois que des octets sont insérés ou supprimés du binaire. Par exemple, voici le gestionnaire d'insertion d'octets :```cpp
void binwrite::binary_t::insert(const rva_t rva, const std::span data, const bool inclusive)
{
buffer_.insert_range(buffer_.begin() + rva.value(), data);
update_rvas(rva, static_cast<rva_t::size_type>(data.size()), inclusive);
}
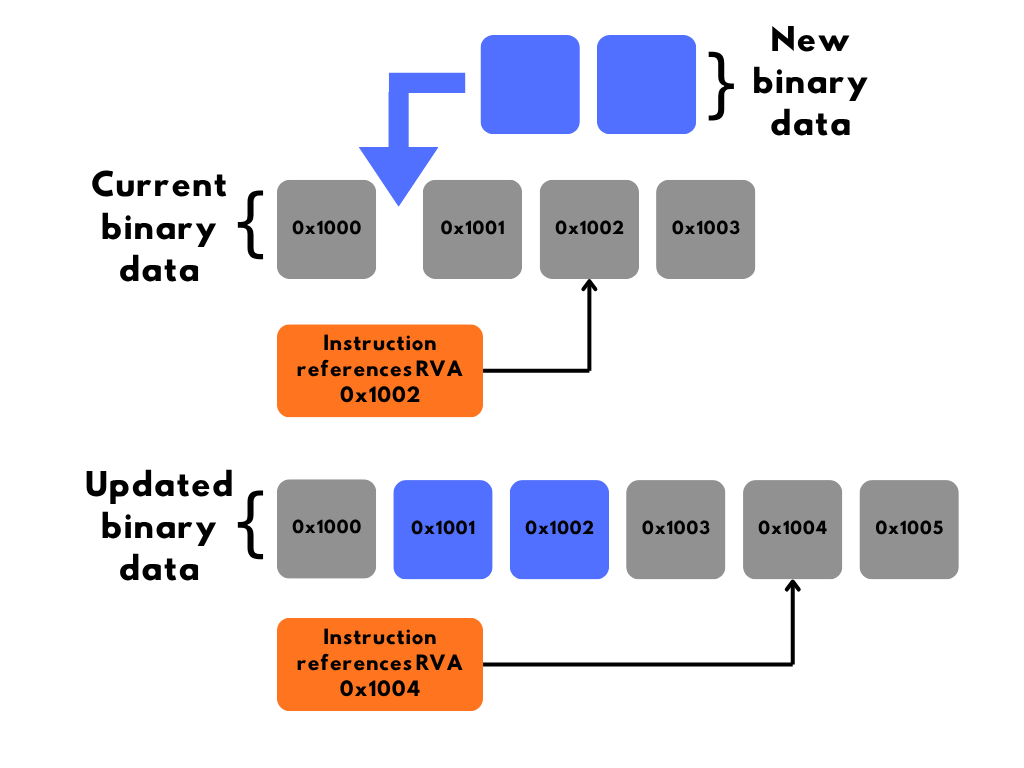
`update_rvas` est l'endroit où chaque RVA suivie est mise à jour pour refléter le changement survenu dans le binaire. Voici un diagramme de ce processus :
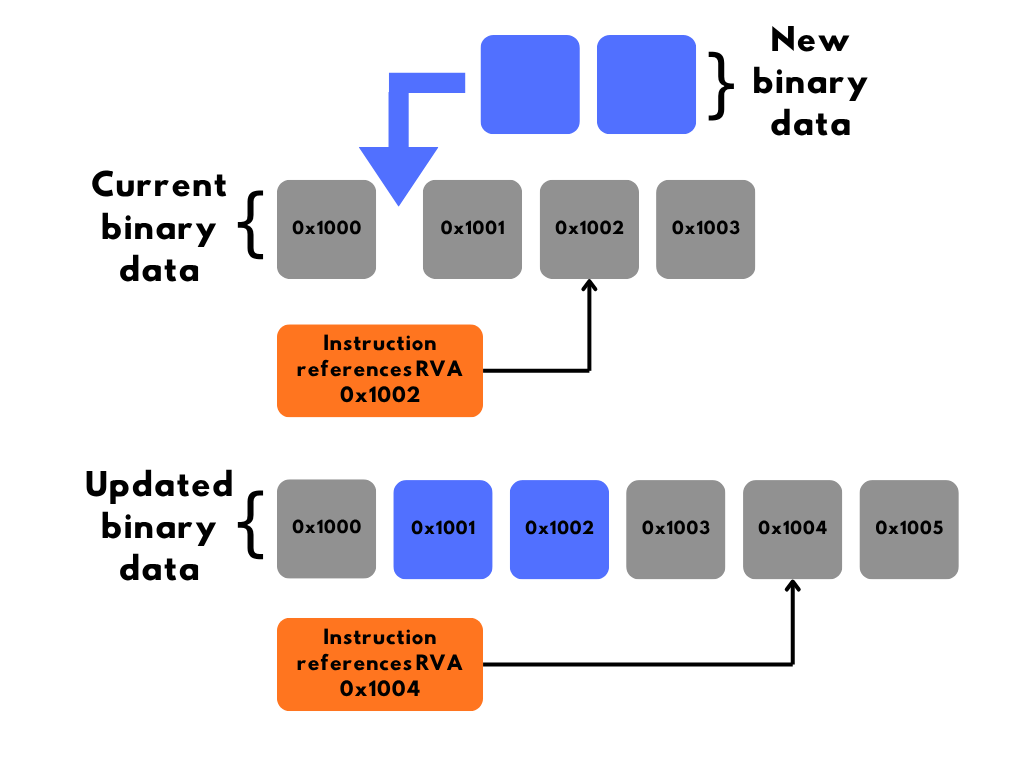
Figure 1. Suivi d'adresses relatives.
Les données insérées (bleu) décalent les données actuelles (gris). La RVA référencée par l'instruction (orange) est mise à jour pour pointer vers la même mémoire, en tenant compte des données insérées (bleu).
## 2.2. Désassemblage
Toutes les entrées de code potentielles (exportations, point d'entrée, relocalisations pointant vers une section de code, etc.) sont ajoutées à une file d'attente de désassemblage. Si un fichier de symboles est présent, toutes les fonctions décrites par ce fichier sont également ajoutées à la file d'attente. Chaque entrée dans la file est traitée comme un bloc de base individuel.
Un bloc de base est un groupe d'instructions sans branchements ; cela signifie qu'il se termine par des instructions de contrôle de flux (par exemple, saut, ret, int). Les blocs de base ne se terminent pas aux appels car ceux-ci sont censés retourner dans la plupart des cas. Certaines fonctions ne retournent pas (par exemple _CxxThrowException) et seront désormais appelées appels 'noreturn'.
Lorsqu'un bloc de base de la file d'attente de désassemblage est traité, chaque instruction est désassemblée en commençant par le haut jusqu'à ce que l'un des événements suivants se produise :
- Un autre bloc de base déjà analysé est atteint, provoquant un chevauchement. Voir « Fractionnement de blocs de base ».
- Une instruction de terminaison est trouvée (saut, retour, int).
- Le désassemblage de l'instruction a échoué.
- Un padding de code a été trouvé.
Voici un diagramme du désassemblage et de l'entrée dans la file d'attente de désassemblage (vérification du padding de code omise dans le diagramme). Ce processus est répété jusqu'à ce que la file d'attente soit vide.
