 nac-l/mergen
Désobfuscation par optimisation à l'aide de LLVM IR et de l'analyse de l'assembleur.

Mergen est un outil conçu pour convertir du code assembleur en représentation intermédiaire LLVM (IR). Cet outil est conçu pour :
Pour construire et exécuter le projet, consultez docs/BUILDING.md.
La porte construit des échantillons PE ciblés, exécute lifter et vérifie les sorties IR levées.
scripts\\rewrite\\run.cmdNous exécutons symboliquement (ou levons symboliquement) la cible, l'idée ici n'est pas de lever des instructions individuelles, mais de lever une fonction entière. Nous ne nous attendons pas à ce qu'une instruction ou un bloc de base se comporte de la même manière à chaque fois, nous les traitons plutôt comme s'ils pouvaient l'être et le sont à des fins différentes à chaque fois. Nous essayons de garder l'IR généré aussi simple et optimisable que possible. Nous avons également des besoins différents de ceux d'un compilateur habituel. Nous utilisons l'analyse pour évaluer le flux de contrôle. Nous ne pouvons pas dépendre de LLVM pour toute notre analyse, car ils sont créés pour des objectifs différents et pourraient être sous-optimaux pour notre cas d'utilisation.
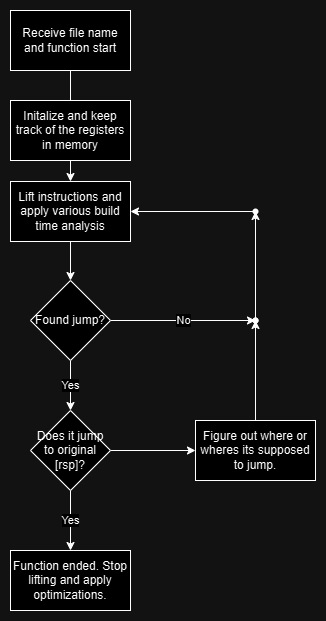
Voici l'exemple pratique pour illustrer comment Mergen résout les programmes virtualisés.
Voici notre programme cible
struct test {
    int a;
    int b;
    int c;
};

int maths(test a, int b, int c) {
        return a.a  + b - c;
}
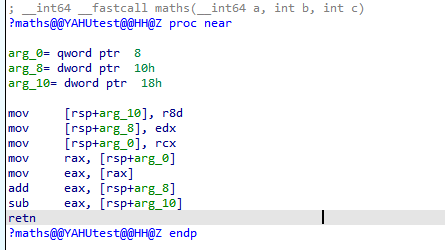
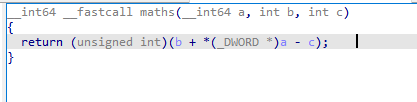
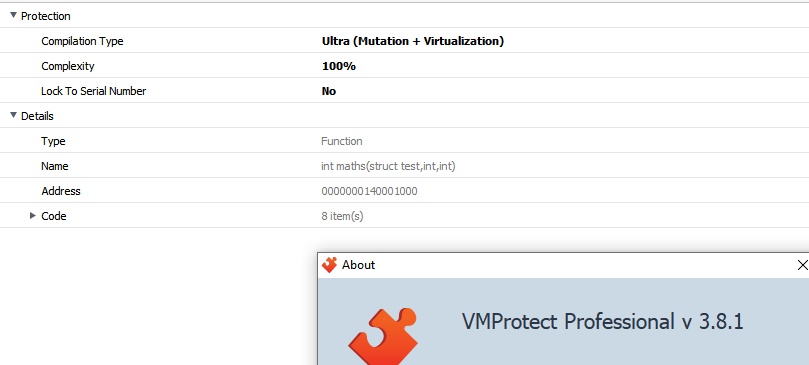
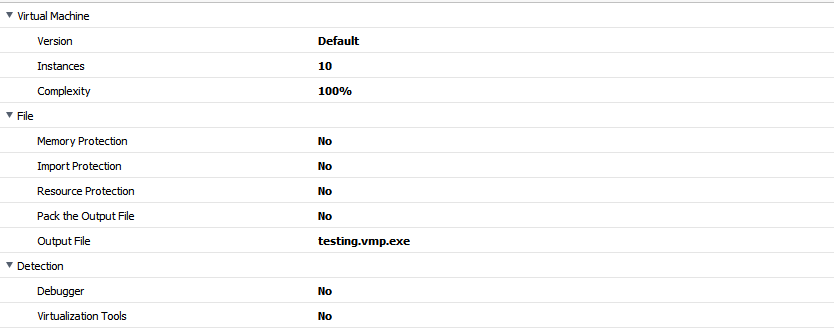
Paramètres VMProtect, tout est désactivé, nous virtualisons la fonction en réglage ultra. (Versions testées 3.4.0-3.6.0 3.8.1)
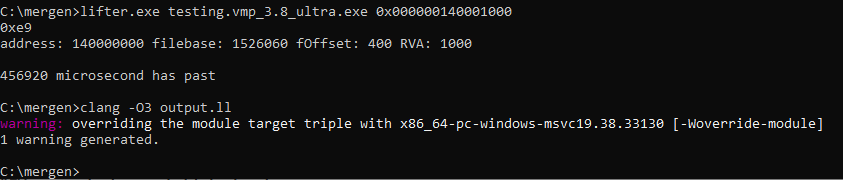
Ici, nous exécutons mergen. Le premier argument est le nom du fichier et le second argument est l'adresse de la fonction. Regardez comme c'est simple à exécuter. Et nous pouvons compiler la sortie pour l'explorer avec notre décompilateur préféré.
; ModuleID = 'my_lifting_module'
source_filename = "my_lifting_module"

; Function Attrs: mustprogress nofree norecurse nosync nounwind willreturn memory(argmem: read)
define i64 @main(i64 %rax, i64 %rcx, i64 %rdx, i64 %rbx, i64 %0, i64 %rbp, i64 %rsi, i64 %rdi, i64 %r8, i64 %r9, i64 %r10, i64 %r11, i64 %r12, i64 %r13, i64 %r14, i64 %r15, ptr nocapture readonly %memory) local_unnamed_addr #0 {
entry:
  %stackmemory = alloca i128, i128 13758960, align 8
  %1 = trunc i64 %r8 to i32
  %2 = trunc i64 %rdx to i32
  %GEPLoadxd-5369456437- = getelementptr i8, ptr %memory, i64 %rcx
  %3 = load i32, ptr %GEPLoadxd-5369456437-, align 4
  %adc-temp-5370242400- = sub i32 %2, %1
  %realnot-5369532059- = add i32 %adc-temp-5370242400-, %3
  %stackmemory10243.sroa.55.1375304.insert.ext10255 = zext i32 %realnot-5369532059- to i64
  ret i64 %stackmemory10243.sroa.55.1375304.insert.ext10255
}

attributes #0 = { mustprogress nofree norecurse nosync nounwind willreturn memory(argmem: read) }
Après compilation :
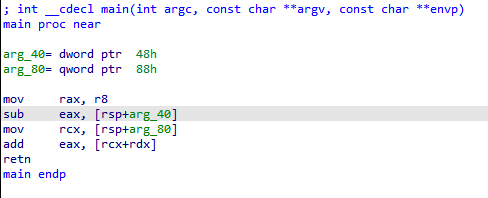
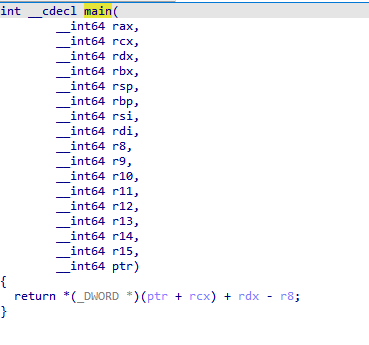
Vous remarquerez peut-être que les registres sont un peu décalés. Cela vient du fait que nous ne suivons pas les conventions d'appel ; si nous les suivions, la signature de la fonction ressemblerait à ceci :
define i64 @main(i64 %rcx, i64 %rdx, i64 %rdx, i64 %r8, i64 %r9 ...)
Donc, nous ajustons simplement la signature de la fonction pour qu'elle paraisse normale. Si vous avez d'autres questions sur cette partie, je vous suggère de vous renseigner sur les conventions d'appel et l'ABI.
Donc, disons que nous avons ce code. Les machines virtuelles prendront le code ci-dessous et le transformeront en un saut indirect, ce qui est légèrement moins pratique pour le rétro-ingénieur.
int maths(int a, int b, int c) {
    if (a > b)
        return a + b + c;
    else
        return a - b - c;
}
next_handler = xxx;
if ( a-b > 0 )
  next_handler = yyy;
jump next_handler;
Nous essayons toujours d'analyser les valeurs et de les suivre. Cela nous permet de comprendre le flux de contrôle. Pour les branches de type table de sauts La sortie optimisée serait un simple
define i64 @main(i64 %rax, i64 %rcx, i64 %rdx, i64 %rbx, i64 %rsp, i64 %rbp, i64 %rsi, i64 %rdi, i64 %r8, i64 %r9, i64 %r10, i64 %r11, i64 %r12, i64 %r13, i64 %r14, i64 %r15, ptr nocapture readnone %TEB, ptr nocapture readnone %memory) local_unnamed_addr #0 {
fake_ret:
  %0 = lshr i64 %rcx, 62
  %common.ret.op = and i64 %0, 2
  ret i64 %common.ret.op
}
Sortie non optimisée. (DCE pour lisibilité)
source_filename = "my_lifting_module"
