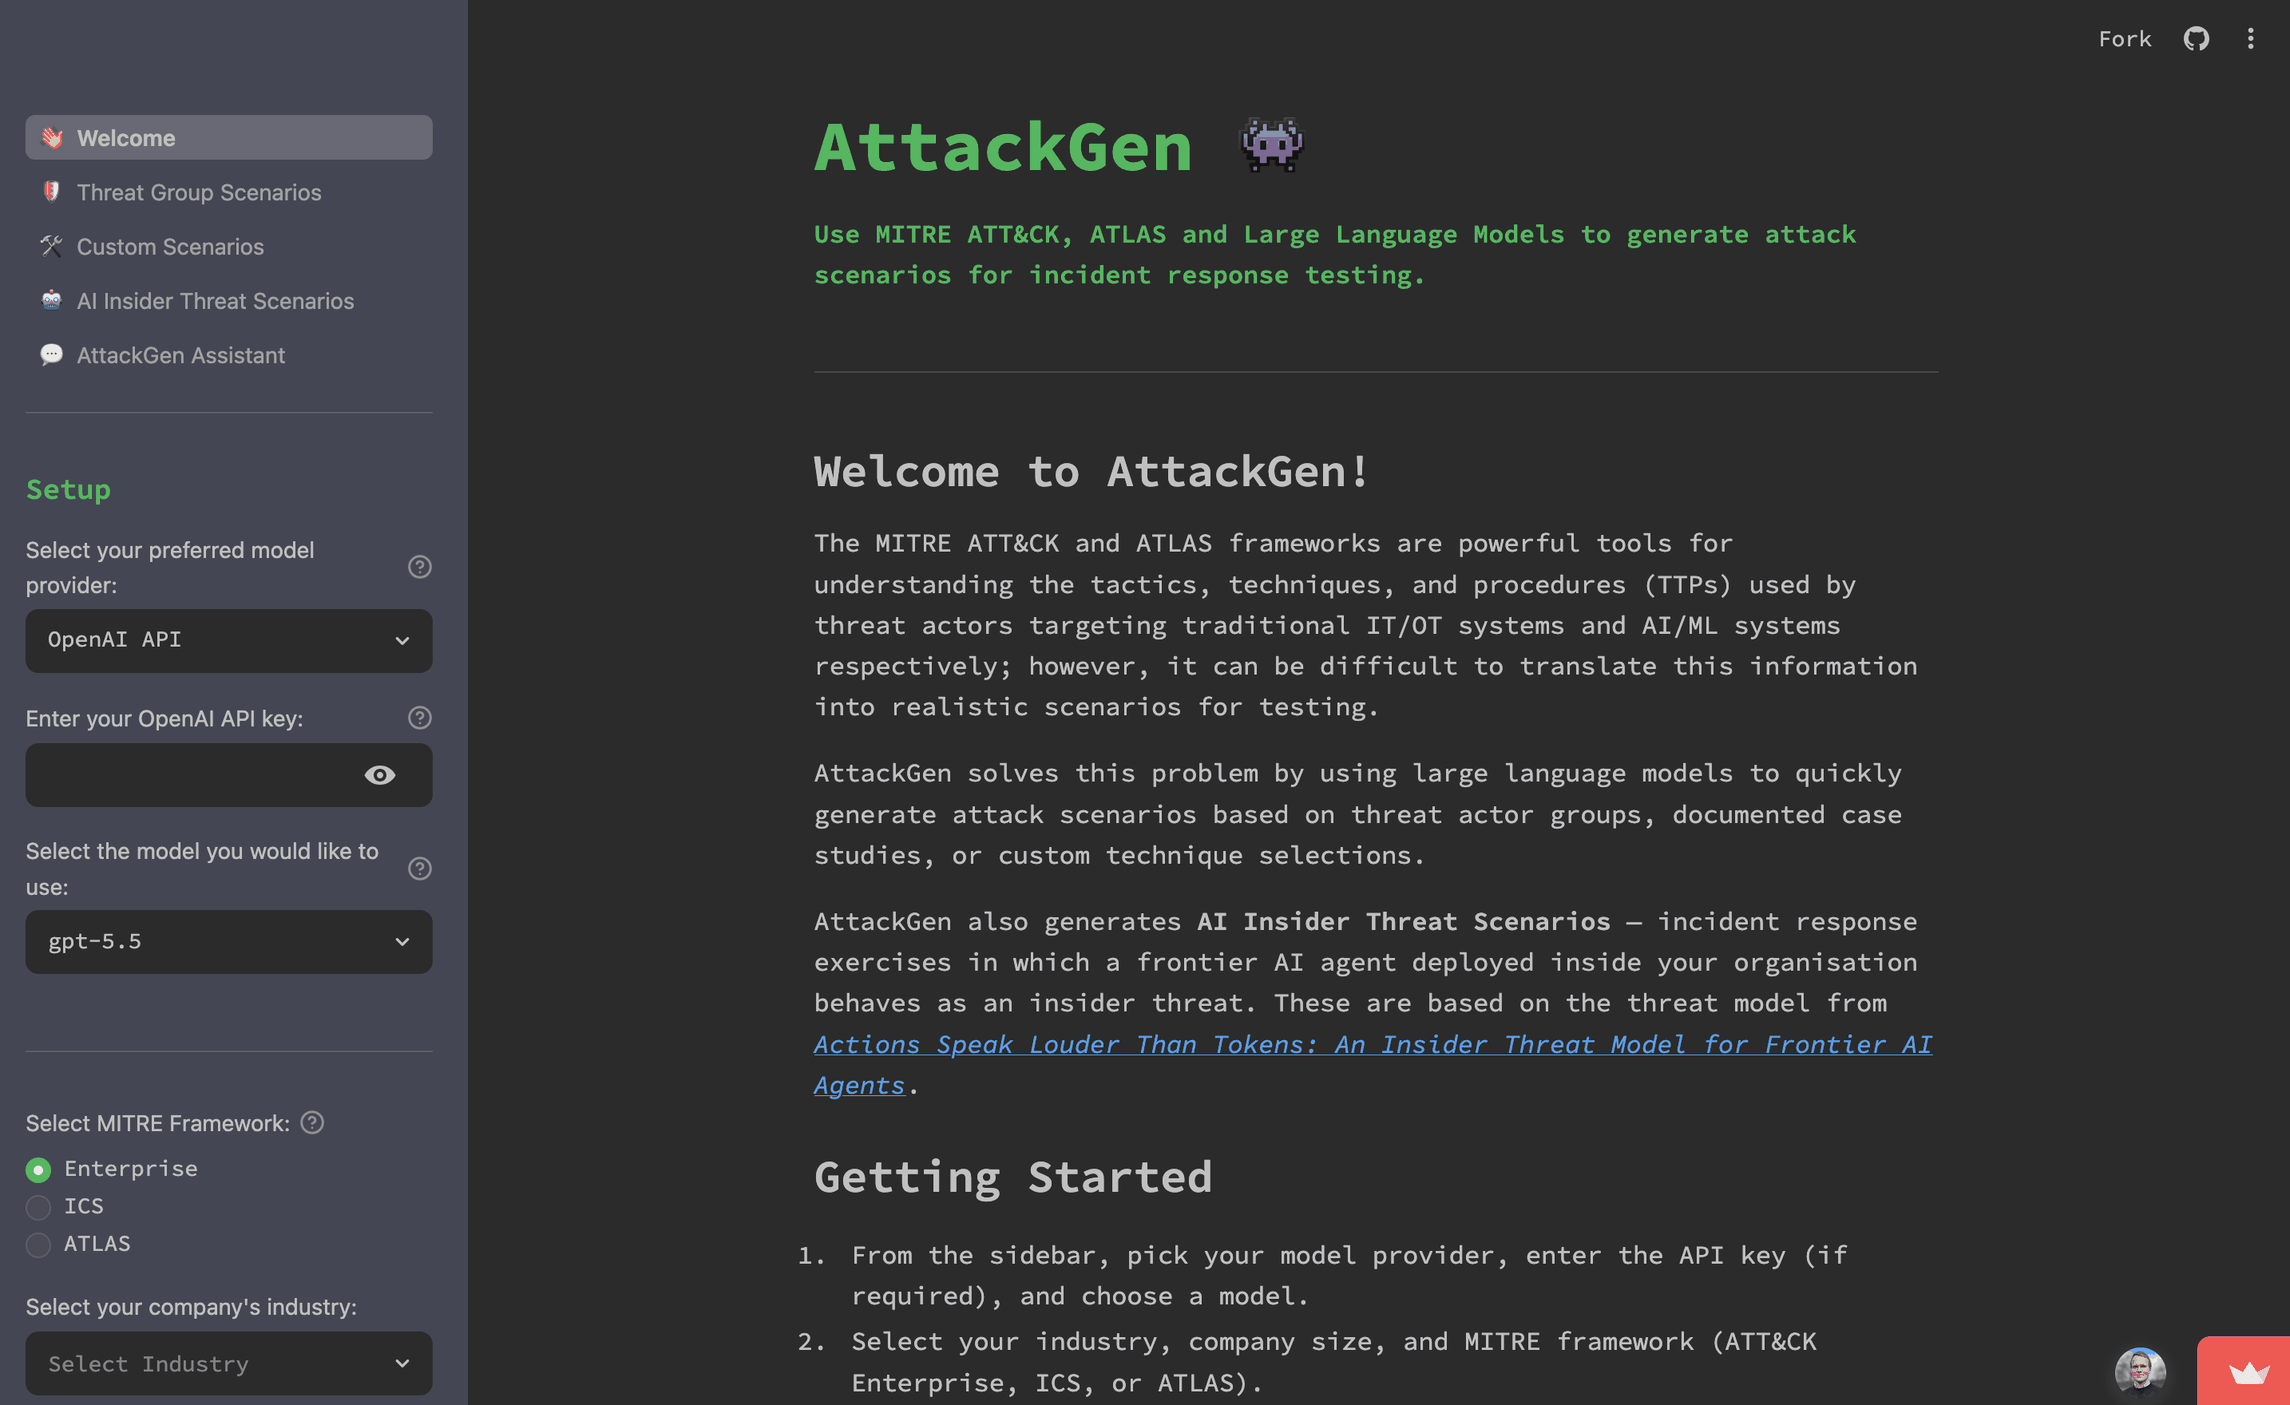

AttackGen est un outil de test de réponse aux incidents en cybersécurité qui exploite la puissance des grands modèles de langage et du cadre complet MITRE ATT&CK. L'outil génère des scénarios de réponse aux incidents adaptés, en fonction des groupes d'acteurs de menace sélectionnés par l'utilisateur et des informations de votre organisation.
# AttackGen AttackGen est un outil de test de réponse aux incidents de cybersécurité qui exploite la puissance des grands modèles de langage ainsi que les frameworks complets MITRE ATT&CK et ATLAS. L'outil génère des scénarios de réponse aux incidents sur mesure en fonction des groupes d'acteurs de menace sélectionnés par l'utilisateur, des études de cas d'attaques par IA et des détails de votre organisation. ## Table des matières - [Star the Repo](#star-the-repo) - [Fonctionnalités](#fonctionnalités) - [Versions](#versions) - [Prérequis](#prérequis) - [Installation](#installation) - [Configuration de LangSmith](#configuration-de-langsmith) - [Configuration des données](#configuration-des-données) - [Exécution d'AttackGen](#exécution-dattackgen) - [Serveur MCP](#serveur-mcp) - [Agent Skills](#agent-skills) - [Utilisation](#utilisation) - [Bonnes pratiques de sécurité](#bonnes-pratiques-de-sécurité) - [Contribuer](#contribuer) - [Licence](#licence) ## Star the Repo Si vous trouvez AttackGen utile, pensez à mettre une étoile au dépôt sur GitHub. Cela aide davantage de personnes à découvrir l'outil. Votre soutien est grandement apprécié ! ⭐ ## Fonctionnalités - Génère des scénarios de réponse aux incidents uniques en fonction des groupes d'acteurs de menace choisis ou des études de cas ATLAS. - Vous permet de préciser la taille et le secteur de votre organisation pour un scénario sur mesure. - Prend en charge les frameworks MITRE ATT&CK Enterprise, ICS (Industrial Control Systems) et ATLAS (Adversarial Threat Landscape for AI Systems). - Affiche une liste détaillée des techniques utilisées par le groupe d'acteurs de menace ou l'étude de cas sélectionné. - Créez des scénarios personnalisés à partir d'une sélection de techniques ATT&CK ou ATLAS. - Utilisez des modèles de scénarios pour générer rapidement des scénarios personnalisés basés sur des types courants d'incidents cyber, y compris des schémas d'attaque spécifiques à l'IA/ML. - Générez des **Scénarios de menace interne par IA** - des exercices de réponse aux incidents dans lesquels un agent IA de pointe déployé au sein de votre organisation se comporte comme une menace interne, en s'appuyant sur le modèle de menace de [*Actions Speak Louder Than Tokens: An Insider Threat Model for Frontier AI Agents*](https://ai-insider-threat.matt-adams.co.uk). Les scénarios sont façonnés par l'archétype de déploiement de l'agent (niveau d'autonomie), la catégorie de menace, les menaces STRIDE et une amorce de scénario en texte libre facultative. - AttackGen Assistant - une interface de chat pour mettre à jour et/ou poser des questions sur les scénarios générés, avec un retour direct vers la page d'origine du scénario. - Configuration guidée : chaque page affiche la même barre latérale **Setup**, liste toutes les exigences non satisfaites dans un résumé de préparation unique, et maintient **Generate** désactivé jusqu'à ce que le flux de travail soit prêt. - Les résultats persistent pour la session : chaque page de scénario conserve son propre dernier résultat, ses entrées capturées et ses téléchargements à travers les réexécutions et la navigation, et seuls un **Regenerate** ou un **Clear result** explicite le remplace ou le supprime. - Les scénarios longs sont accompagnés d'un résumé compact et d'une navigation par sections, incluant des raccourcis vers les injects, les critères de réussite, les métriques, les artefacts et les règles d'engagement à partir desquels un facilitateur mène l'exercice. - Recueillez les retours des utilisateurs sur la qualité des scénarios générés. - Scénarios téléchargeables au format Markdown. - Utilisez l'API OpenAI, l'API Anthropic (modèles Claude), l'API Google AI, l'API Mistral, l'API Groq, ou tout endpoint personnalisé compatible OpenAI (Ollama, LM Studio, Azure OpenAI, OpenRouter, etc.) pour générer des scénarios de réponse aux incidents. Tous les fournisseurs sont acheminés via [LiteLLM](https://github.com/BerriAI/litellm) derrière un wrapper interne unique, de sorte que l'ajout d'un nouveau modèle se fait en une seule ligne. - Disponible sous forme d'image de conteneur Docker pour un déploiement facile. - Intégration facultative avec [LangSmith](https://docs.smith.langchain.com/) pour un débogage, des tests et une surveillance puissants des performances des modèles. - Gestion sécurisée des identifiants via un fichier .env pour les clés API et les secrets. 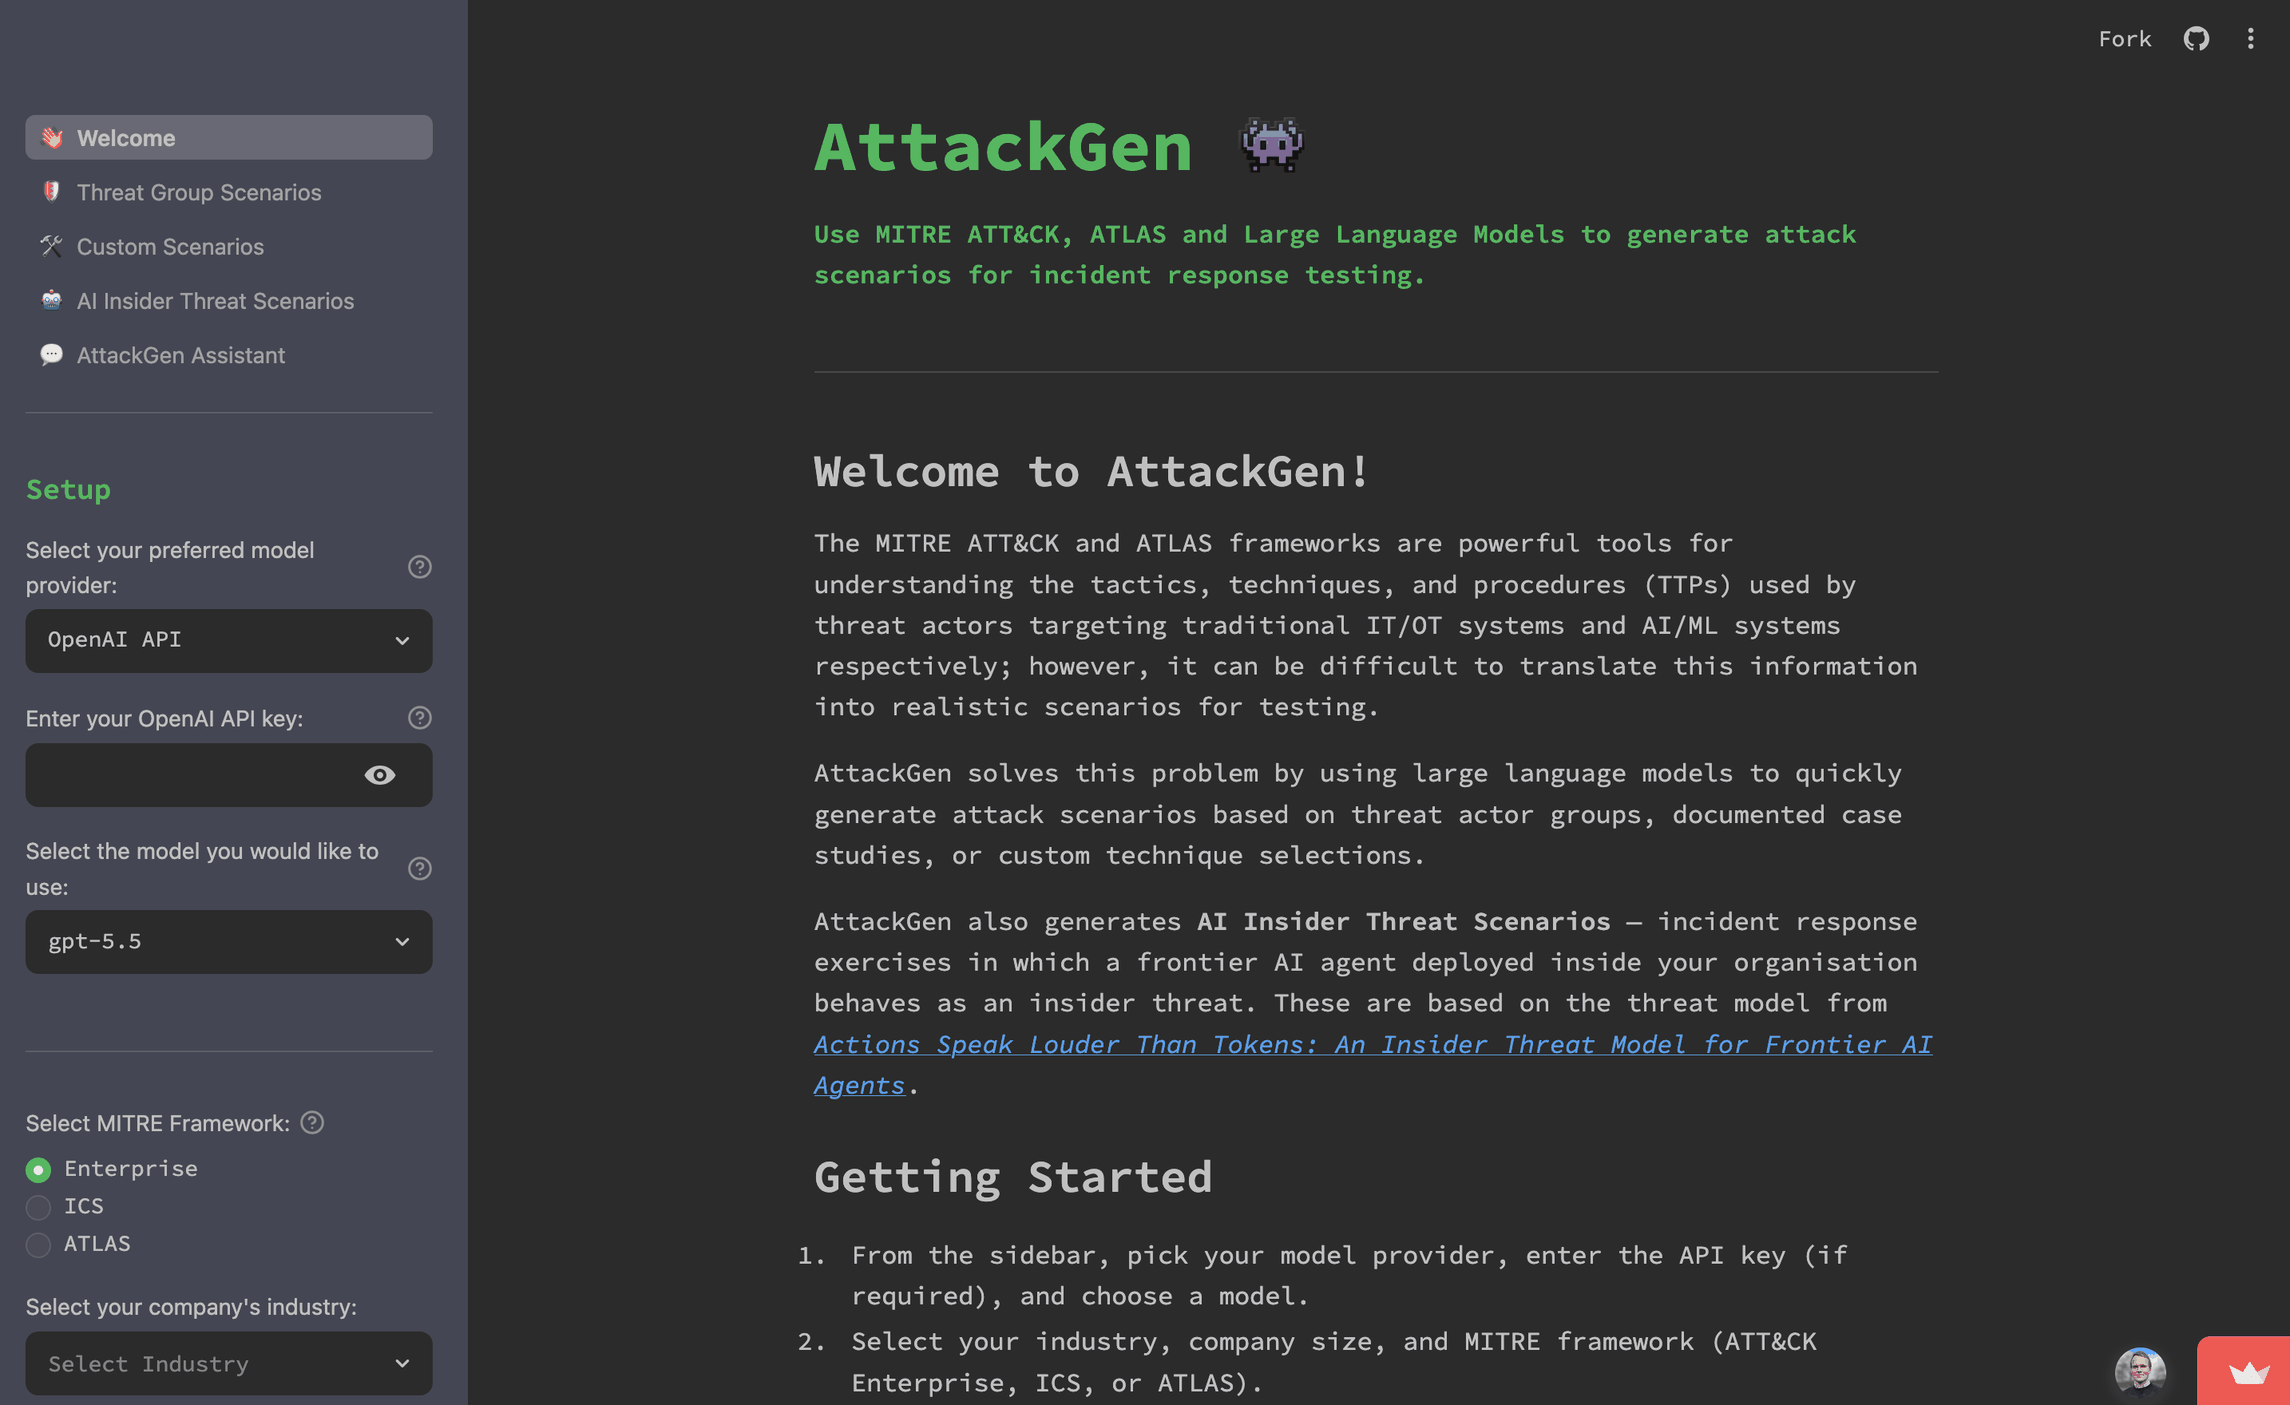 ## Versions ### v0.17 | Quoi de neuf ? | En quoi est-ce utile ? | | ----------- | ----------------- | | Apply Assistant Refinements to the Downloads | - Changes Reach the Files: The Assistant's chat used to refine a conversation only, so the scenario and Detection & Response downloads never changed. A new **Apply changes to downloads** button rewrites them from the conversation, in a dedicated model call that returns the complete revised document. In **Scenario + Detection & Response** mode it revises both, each given the other's current text so they stay aligned.<br><br>- The Reference Section Stays Exact: A Detection & Response apply rewrites only the narrative. The deterministic detection and mitigation reference drawn from the ATT&CK data is carried over byte for byte. The Navigator layer is not regenerated and is captioned as reflecting the original scenario's techniques.<br><br>- Safe to Try: An empty reply from the model is refused with no changes made. The scenario page and the Assistant both caption a refined result with the time of the last apply, and **Revert to original** restores the scenario and narrative together.<br><br>- Download Where You Edit: The Assistant now offers the same **Download Scenario** and **Download Detection & Response** buttons as the scenario page.<br><br>- One Conversation per Scenario: Each chat belongs to the scenario it is about, so a newly generated scenario starts a fresh conversation, and the whole history stays visible after an apply. | | Guided, Resilient Scenario Workflow | - Readiness Before the Click: Every page now lists what is still missing — the page's own selection first, then any incomplete Setup field — and keeps **Generate** disabled until nothing is outstanding, so a click is never spent discovering a validation error.<br><br>- Options Before the Action: The AI-enhanced adversary and purple-team toggles sit above **Generate**, with the purple-team option stating that it makes a second model call.<br><br>- Confirm Before You Spend: A one-line summary of the framework, organisation profile, selection and modifiers is shown before generation starts.<br><br>- Results That Survive Navigation: Each page keeps its own latest result, the inputs that produced it and its download names for the session — open the Assistant and come back and the scenario, its Navigator layer and its Detection & Response report are still there. Editing the form leaves the result in place with a note that your selections have moved on; **Regenerate** and **Clear result** are explicit actions.<br><br>- Find Your Way Around a Long Scenario: A compact summary and section index sit above the full Markdown, with shortcuts to injects, discussion questions, success criteria, metrics, artefacts and rules of engagement.<br><br>- Useful Empty States: With no scenario, the Assistant links to all three ways to create one; with one, it names the scenario it is discussing and links back to the page that generated it. | | Recover From a Failed or Slow Narrative | - Keep What Worked: If the optional purple-team narrative fails or is stopped, the base scenario, its downloads, the Navigator layer and the deterministic Detection & Response reference stay fully usable, with a message saying what failed.<br><br>- Retry Only What Failed: **Retry purple-team narrative** reruns the narrative alone, with no second base-scenario call, and merges it into the Detection & Response view and download. A failed base scenario offers its own retry using the inputs captured at **Generate**.<br><br>- A Timer That Keeps Moving: The elapsed time now advances while waiting for a model's first token, so a long wait no longer looks like a hang. | | Clearer Failures When Techniques Won't Load | - Failures Reported as Failures: A threat group whose technique lookup fails is no longer shown as a group with no techniques, and Custom Scenarios no longer hides its technique picker and asks you to select techniques when the list failed to load.<br><br>- A Next Step, Not a Dead End: Both blockers now say what you can do about the failure. | | Accessibility and Leaner Copy | - Keyboard and Screen-Reader Friendly: Icon-only controls have meaningful accessible names, form labels are unique, and keyboard order and focus are visible and logical. The layout no longer overflows horizontally at phone width, and the empty theme-colour console warnings are gone.<br><br>- Checked in CI: Real-browser smoke tests for console hygiene and accessibility now run on every pull request and gate the release image.<br><br>- Less to Read: The scenario pages no longer repeat the pre-flight summary in a second expander or explain their own state management. | | Model Registry Refresh | - Latest Models: The model list is refreshed against each provider's current docs — **GPT-6 Astra** heads the OpenAI list, **Claude Opus 5.5**, **Claude Opus 5** and **Claude Fable 5.1** join the Anthropic one, and Google gains **Gemini 3.8 Flash** alongside **Gemini 3.5 Flash Lite**, with one prior generation kept for continuity in each case. Anthropic's list now leads with **Claude Opus 5.5** — the sidebar's default when you haven't picked one — rather than the pricier Fable 5.1.<br><br>- Removed Retired Entries: Dropped ids the providers have superseded or shut down — Claude Opus 4.7 and 4.8 (more than one Opus generation back once Opus 5.5 lands) and Groq's `llama-3.3-70b-versatile` and `llama-3.1-8b-instant` (both shut down 16 Aug 2026) — so the sidebar can't offer a model that only errors once you press **Generate**. Groq's open-weight reasoning tier is now `qwen/qwen3.8-27b`.<br><br>- Temperature Rule Kept Honest: `supports_temperature` is set from each Anthropic model's actual sampling behaviour — every Claude from 4.7 on rejects a custom temperature, and Haiku 4.5 remains the only listed model that accepts one. The test guarding this now fails when a new Anthropic entry omits the flag, rather than only when someone sets it by hand. | | Platform & Security Housekeeping | - Python 3.11 Minimum: Python 3.10 is no longer supported. LiteLLM 1.98.0 and later import a typing feature that only exists from 3.11.<br><br>- Patched Base Image: The Docker image is rebuilt on a current `python:3.14-slim`, clearing the Debian base-image CVEs flagged by Trivy, including three critical ones in `perl-base`.<br><br>- Real Errors From Failed Calls: `tenacity` is now declared, so a failed model call reports the provider's actual error (for example an invalid API key) instead of an instruction to install `tenacity`.<br><br>- Feedback Stays With Its Scenario: A rating is recorded against the run that produced the scenario on screen, never another page's latest run. | <details> <summary>Earlier releases (v0.16 and older)</summary> ### v0.16 | Quoi de neuf ? | En quoi est-ce utile ? | | ----------- | ----------------- | | Base-Scenario-First Generation | - Scenario Before the Wait: Generation now runs in phases — the base scenario renders first with its **Download Scenario** and **Download ATT&CK Navigator Layer** buttons already live, and the optional purple-team narrative streams in afterwards. If that second pass is slow, or you don't need it, the scenario is usable straight away rather than withheld until everything finishes.<br><br>- Inputs Frozen at Generate: Each run works from a snapshot taken the moment you press **Generate**, so changing the sidebar mid-run can't half-rewrite the scenario being produced.<br><br>- Honest Progress: A running elapsed-time label and named phases — preparing inputs, generating the base scenario, building the deterministic exports, generating the purple-team narrative — show where a long run has actually got to. | | Neutral, Dead-End-Free Selectors | - Only Options That Work: The threat-group and case-study selectors now offer only the choices that actually produce a scenario, so a selection can no longer lead to a dead end.<br><br>- Natural Ordering: Groups sort in natural numeric order, so APT3 comes before APT28 and APT30 rather than being sorted as text and landing between them. | | Shared Setup Sidebar on Every Page | - Set Up Once: Provider, model, framework, industry and company size now live in a single shared **Setup** sidebar on every scenario page — Threat Group, Custom and AI Insider Threat — instead of being re-entered on each one.<br><br>- Survives Navigation: Non-secret selections persist as you move between pages and are mirrored to the URL, while API keys are deliberately kept out of the query string. | | Platform & Security Housekeeping | - MCP on the 2.x SDK: The MCP server has moved to the `mcp` 2.x SDK.<br><br>- Newer Base Image: The Docker image is now built on `python:3.14-slim`.<br><br>- CI Gates Rather Than Warns: The security scans now fail the build on findings instead of only reporting them — pip-audit and Bandit gate, Trivy no longer miscounts pip's vendored SBOM as installed packages, and the actionable image CVEs are cleared. GitHub Actions have moved off the Node 20 runtime and Dependabot now tracks the workflow actions themselves. | ### v0.15 | Quoi de neuf ? | En quoi est-ce utile ? | | ----------- | ----------------- | | Evaluation Environment Escape Preset & Scenario Seed | - Rehearse a Specific Incident: A new AI insider-threat template rehearses an evaluation agent reaching real systems from an environment assumed to be isolated — forcing containment, credential rotation, third-party notification and evidence preservation. It covers the July 2026 disclosures of eval agents escaping their sandboxes, where the isolation boundary was *assumed* rather than enforced.<br><br>- Templates Now Reach the Prompt: Quick-start templates previously only pre-filled the page's widgets and never influenced the generated scenario. They now carry a narrative `brief` and the `required_decisions` the Discussion Questions must force, both threaded into the prompt — so a template produces a usable timed tabletop rather than a grab-bag of questions. This splits them into two classes: the six original **archetype** templates set decisions only, so the model invents the premise and re-running one yields a fresh exercise for the same threat profile; **incident** templates also set a brief, pinning the situation.<br><br>- Free-Text Scenario Seed: An optional seed box on the AI Insider Threat page steers the narrative on any scenario. Selecting a template pre-fills it, and you can edit it or write your own from scratch.<br><br>- Taxonomy Extended to 27 Threats / 6 Categories: Adds a sixth threat category (**Containment & Third-Party Impact**) and four STRIDE threats the exercise turns on — `S5` reusable workload credential replay, `R4` agent-side telemetry suppression, `I5` third-party & downstream compromise, and `E5` containment boundary assurance failure. AttackGen now *extends* the published threat model rather than mirroring it.<br><br>- Templates Usable Over MCP: `get_ai_insider_prompt` and `generate_ai_insider_scenario` accept `template=` and `scenario_seed=`, and `list_ai_insider_options` returns each template with the selections and brief it applies — so a client can pick a preset on merit and call with just a template, industry and company size. Previously the template names were listed but no tool accepted one. | | attackgen-tabletop Skill: AI Insider-Threat Path | - A Second Exercise Path: The [Agent Skill](https://github.com/mrwadams/attackgen/blob/main/skills) now builds a tabletop from the AI insider-threat model as well as from a MITRE kill chain. Pick a quick-start template (or a deployment archetype and threat categories) and it turns `get_ai_insider_prompt`'s payload into an MSEL.<br><br>- Same Shape, Different Spine: The exercise keeps the same six sections, but the kill-chain table becomes an agent profile and STRIDE threat scope, the detection scorecard is judged against the deployment archetype's detection posture — so the rows that *wouldn't* fire become the finding — and the template's required decisions become mandatory discussion questions.<br><br>- Path Chosen for You: The skill's description now triggers on rogue-agent phrasing, so asking for an "AI insider threat tabletop" reaches the right path. An external actor with AI-accelerated tradecraft stays on the MITRE path.<br><br>- Response, Not Exploit: Both paths are explicitly bounded to rehearsing the decisions a response team must make — no exploit code, payloads or real unpatched vulnerabilities — and the AI path attributes agent behaviour to configuration, access and objective rather than human motive. | | Fix: MCP AI-Insider Prompts Dropped the Agent Capabilities | - Same Template, Same Prompt: The frontier-agent capability block — the benchmark-grounded lines that make an AI insider scenario credible — was omitted from every `get_ai_insider_prompt` / `generate_ai_insider_scenario` call that didn't name `capabilities` explicitly. No template supplies them, so the argument fell through to empty and the prompt substituted a generic "assume a capable frontier coding agent" line, while page 3 sent all four for the same template.<br><br>- Defaults Now Match the App: Omitting `capabilities` applies the full set, as the page's multiselect does. Passing `[]` still leaves them unspecified, so the deliberate opt-out is unchanged. | | Fix: Anthropic Claude 4.7+ scenario generation | - Every Claude Model Works Again: Claude 4.7 and later reject any sampling `temperature`, returning `BadRequestError: 'temperature' is deprecated for this model`. Four of the five listed Anthropic models — Fable 5, Opus 4.8, Sonnet 5 and Opus 4.7 — could not generate a scenario on any page; only Haiku 4.5 worked.<br><br>- Gated Per Model, Not Per Provider: The temperature rule was previously routed from the provider, which cannot express a provider whose models disagree. `ModelInfo.supports_temperature` now marks the models that reject one, so Haiku 4.5 keeps its configured temperature while its siblings omit it. OpenAI stays a provider-level rule (every current chat model is a reasoning model), and unregistered models — local Ollama / LM Studio endpoints — still receive a temperature. |### v0.14 | Quoi de neuf ? | En quoi est-ce utile ? | | ----------- | ----------------- | | Serveur MCP pour clients agentiques | - Génération de scénarios sous forme d'outils : un nouveau serveur FastMCP (`mcp_server.py`, SDK officiel `mcp`) expose AttackGen aux clients agentiques via stdio, de sorte qu'un assistant comme Claude Code ou Claude Desktop peut récupérer les données MITRE et générer des scénarios sans l'interface Streamlit.<br><br>- Deux niveaux : les **outils de données** (`list_threat_groups`, `list_case_studies`, `get_kill_chain`, `get_detection_report`, `get_navigator_layer`, `list_ai_insider_options`, `get_ai_insider_prompt`) n'effectuent aucun appel LLM et ne nécessitent aucune clé API — ils renvoient des données MITRE structurées et, le cas échéant, un prompt prêt à l'emploi, ce qui les rend sûrs à héberger via HTTP. Les **outils de génération** (`generate_threat_group_scenario`, `generate_custom_scenario`, `generate_ai_insider_scenario`) prennent une configuration avec votre propre clé et renvoient du Markdown finalisé — conservez-les en stdio local.<br><br>- Implémentation partagée : le serveur réutilise les mêmes constructeurs sans interface `core/prompts.py` et les mêmes chargeurs `core/attack_data.py` que les pages Streamlit, de sorte que les scénarios correspondent à l'application au lieu de diverger. Lancez avec `python -m mcp_server` ou le script console `attackgen-mcp`. | | Compétence d'agent attackgen-tabletop | - Exercices prêts pour l'animateur : une nouvelle [compétence d'agent](https://github.com/mrwadams/attackgen/blob/main/skills) s'appuie sur les outils de données MCP pour transformer un groupe de menaces ou une étude de cas MITRE ATT&CK/ATLAS en un exercice tabletop de réponse aux incidents / MSEL complet — narration du scénario, kill chain mappée par phase, injects horodatés, questions de discussion NIST SP 800-61 et une grille d'évaluation de la couverture de détection.<br><br>- Fonctionne sur le modèle de l'appelant : la compétence fournit l'art de l'exercice tandis que le serveur MCP fournit les données, de sorte qu'elle s'exécute sur le propre modèle du client sans clé API supplémentaire.<br><br>- Deux formats de sortie : livré en Markdown (par défaut) ou sous forme de rapport HTML autonome et adapté à l'impression. | | L'assistant affine la sortie de détection et de réponse | - Édition purple-team : l'assistant AttackGen peut désormais affiner la narration **Détection et réponse**, et pas seulement le scénario. Lorsqu'un scénario est généré avec le bouton 🟣 narration purple-team (pages Threat Group / Custom), un sélecteur **Editing:** apparaît sur la page Assistant afin que le chat puisse cibler soit le scénario, soit le déroulé du défenseur — auparavant, l'assistant ne disposait que du texte du scénario.<br><br>- Mode d'édition combiné : une troisième cible **Scenario + Detection & Response** affine les deux ensemble, de sorte qu'un changement transversal — un secteur différent, un acteur de menace, une technique ou une chronologie différente — est appliqué de manière cohérente à travers le scénario de l'attaquant et la narration du défenseur plutôt que d'être effectué deux fois et de diverger.<br><br>- Faits déterministes intacts : seule la narration LLM est une cible d'affinement ; la jointure de détection STIX locale n'est jamais éditée par LLM. Chaque mode d'édition conserve son propre historique de chat, et la passe combinée est étiquetée `purple_team_narrative` dans LangSmith. | | Registre de modèles simplifié | - Une chose en moins par modèle : l'argument `max_completion_tokens` et la règle de température des modèles de raisonnement sont désormais routés depuis le **fournisseur** plutôt que via un indicateur `uses_max_completion_tokens` par modèle — tous les modèles de chat OpenAI actuels les utilisent, donc l'indicateur dupliquait un fait déjà capturé par la clé du fournisseur. L'ajout d'un nouveau modèle OpenAI reste une modification d'une seule entrée dans `MODELS`, sans indicateur supplémentaire à retenir.<br><br>- Aucun changement de comportement : une simplification interne uniquement — le wrapper construit des arguments LiteLLM identiques pour chaque modèle actuel. | ### v0.13.1 | Quoi de neuf ? | En quoi est-ce utile ? | | ----------- | ----------------- | | Correctif : génération de scénarios OpenAI GPT-5.x | - Gestion correcte des modèles de raisonnement : les modèles de raisonnement GPT-5.x d'OpenAI rejettent toute `temperature` d'échantillonnage autre que leur valeur par défaut, de sorte que chaque génération GPT-5.x échouait avec `BadRequestError: 'temperature' does not support 0.7 with this model`. AttackGen n'envoie plus de température personnalisée à ces modèles, tandis que les autres fournisseurs conservent la valeur configurée. | | Actualisation du registre de modèles | - Derniers modèles : liste de modèles actualisée par rapport à la documentation actuelle de chaque fournisseur — **OpenAI GPT-5.6** (paliers Sol / Terra / Luna), **Claude Fable 5** et **Claude Sonnet 5**, avec une génération précédente conservée par fournisseur pour la continuité.<br><br>- Entrées obsolètes supprimées : modèles que les fournisseurs ont remplacés ou retirent — notamment `qwen3-32b` de Groq (arrêté le 17 juillet 2026) et Magistral Medium de Mistral — afin que la barre latérale ne puisse pas proposer un modèle qui génère une erreur à la sélection.<br><br>- Ajout d'un palier Groq rapide/économique (`llama-3.1-8b-instant`). | ### v0.13 | Quoi de neuf ? | En quoi est-ce utile ? | | ----------- | ----------------- | | Mode purple-team : détection et réponse | - Compagnon défensif : chaque scénario Threat Group et Custom affiche désormais une section **Détection et réponse** qui relie chacune des techniques du scénario aux stratégies de détection, analyses, sources de journaux et mitigations MITRE ATT&CK déjà présentes dans les données fournies — transformant une narration purement red-team en un exercice purple-team (« voici l'attaque, et voici exactement ce que votre SOC aurait dû voir »).<br><br>- Aucun appel LLM pour les faits : la section de détection est une **jointure de données locale**, et non un appel à un modèle — les analyses, sources de journaux et mitigations qu'elle liste sont donc le contenu MITRE réel et actuel plutôt que des suppositions du modèle. Elle est proposée comme son propre téléchargement `..._detection.md` aux côtés du scénario et de la couche.<br><br>- Sources de journaux à activer : un récapitulatif par scénario liste les sources de journaux distinctes que les détections lisent (par ex. `WinEventLog:Security (EventCode=4624)`), afin qu'un SOC puisse voir d'un coup d'œil quelle télémétrie l'exercice suppose.<br><br>- Narration purple-team facultative : un bouton **🟣 narration purple-team** par page ajoute une seconde passe de modèle qui parcourt le scénario étape par étape du point de vue du défenseur — ce qui devrait se déclencher, ce que l'analyste voit, comment réagir — en s'appuyant strictement sur les détections et mitigations ci-dessus (aucune détection inventée).<br><br>- Compatible ATLAS : les scénarios ATLAS listent les mitigations (ATLAS n'a pas encore de stratégies de détection) et le précisent, plutôt que de n'afficher rien. | | MITRE ATT&CK v19.1 et dernières données ATLAS | - Frameworks mis à jour : les données MITRE ATT&CK Enterprise et ICS ont été actualisées de la v18.1 à la **v19.1**, et MITRE ATLAS actualisé à la dernière version, de sorte que les scénarios générés reflètent les tactiques, techniques et études de cas actuelles.<br><br>- Listes de groupes actualisées : les menus déroulants de groupes de menaces sont régénérés à partir des bundles v19.1 (174 groupes Enterprise et 14 groupes ICS actifs). Les groupes que MITRE a révoqués ou fusionnés en amont (par ex. APT34 → OilRig, UNC2452 → APT29) n'apparaissent plus, tandis que des groupes nouvellement suivis comme MirrorFace apparaissent.<br><br>- Plus d'études de cas ATLAS : la bibliothèque d'études de cas ATLAS est passée à 57 (17 incidents, 40 exercices).<br><br>- Actualisation reproductible : un nouveau script `scripts/generate_groups.py` régénère les mappages de groupes à partir des bundles STIX fournis, en complément du script existant d'études de cas ATLAS — de sorte que la prochaine actualisation est une étape scriptée plutôt qu'une curation manuelle. | | Export de couche ATT&CK Navigator | - Couche téléchargeable : chaque scénario généré sur les pages Threat Group et Custom Scenario propose désormais une couche ATT&CK Navigator (`.json`) en plus du téléchargement Markdown, afin que les techniques d'un scénario puissent être visualisées, annotées et partagées dans l'ATT&CK Navigator. Pour la consulter, téléchargez la couche et ouvrez-la via **Open Existing Layer → Upload from local** dans le Navigator.<br><br>- Les trois matrices : le bon domaine Navigator est défini automatiquement par matrice — importez les couches Enterprise et ICS dans le [MITRE ATT&CK Navigator](https://mitre-attack.github.io/attack-navigator/), et les couches ATLAS dans le fork [ATLAS Navigator](https://mitre-atlas.github.io/atlas-navigator/). (Une couche ATLAS ne se chargera pas dans l'ATT&CK Navigator, et inversement, car chacun ne reconnaît que son propre domaine.)<br><br>- Les techniques restent visibles : les sous-techniques notées développent automatiquement leur parent et les identifiants de techniques sont mis en évidence dans la mise en page, de sorte que les techniques mises en évidence du scénario sont immédiatement apparentes plutôt que masquées dans des lignes repliées.<br><br>- Aucun appel LLM supplémentaire : la couche est une sérialisation locale des techniques déjà sélectionnées pour le scénario — aucun appel de modèle supplémentaire ni recherche externe.<br><br>- Noms de fichiers de téléchargement descriptifs : les téléchargements de scénarios et de couches sont désormais nommés d'après l'acteur de menace / le scénario personnalisé et la matrice avec un horodatage de génération (par ex. `AttackGen_APT29_Enterprise_20260714-153045.md`), de sorte que les fichiers enregistrés sont significatifs et n'entrent pas en collision entre scénarios. | ### v0.12 | Quoi de neuf ? | En quoi est-ce utile ? | | ----------- | ----------------- | | Scénarios de menace interne par IA | - Nouveau type de scénario : une page dédiée génère des exercices tabletop de réponse aux incidents dans lesquels un agent IA de pointe déployé au sein de votre organisation se comporte comme une menace interne — par désalignement, reward hacking, objectifs émergents ou compromission par injection de prompt. Basé sur le modèle de menace de [*Actions Speak Louder Than Tokens: An Insider Threat Model for Frontier AI Agents*](https://ai-insider-threat.matt-adams.co.uk).<br><br>- Piloté par l'archétype de déploiement : les scénarios sont façonnés par le niveau d'autonomie de l'agent (assistant supervisé L1 → flotte entièrement autonome L4), qui est le principal déterminant de sa surface de menace et de sa posture de détection.<br><br>- Cinq catégories de menaces internes : compromission d'identifiants, sabotage de la chaîne d'approvisionnement, exfiltration de données, sabotage d'infrastructure, et tromperie et évasion — chacune mappée à des manifestations concrètes d'agents IA plutôt qu'à des motivations humaines.<br><br>- 23 menaces STRIDE pour agents IA : une taxonomie STRIDE complète (usurpation, altération, répudiation, divulgation d'informations, déni de service, élévation de privilèges) adaptée aux agents IA de pointe, utilisée en option pour restreindre le périmètre du scénario.<br><br>- Contrôles alignés sur le NIST CSF : les scénarios générés incluent des mitigations priorisées mappées au NIST Cybersecurity Framework (Identify, Protect, Detect, Respond, Recover).<br><br>- Parité des fournisseurs : prend en charge le même ensemble de fournisseurs que le reste d'AttackGen avec traçage LangSmith facultatif. | --- [Read more](https://github.com/mrwadams/attackgen)

