 farhadalimohammadi-dir/vulnrepro-benchmark

Benchmark mesurant la capacité des modèles d'IA à détecter les vulnérabilités dans le code source via des cas réels de bug bounty avec un équilibre entre le rappel et le score de faux positifs. Inclut des applications vulnérables basées sur Docker et des contrôles propres pour une évaluation reproductible.
Un benchmark qui vérifie si un modèle d'IA peut réellement passer en revue du code vulnérable, ou s'il se contente d'avoir l'air confiant.
La plupart des benchmarks de sécurité posent une seule question : le modèle peut-il trouver le bogue ? Ce n'est que la moitié du travail. L'autre moitié, celle qui vous épuise vraiment dans le travail de révision réel, c'est de ne pas signaler des choses qui n'existent pas. Un modèle qui crie « vulnérable » à chaque fichier aura un excellent résultat sur un benchmark qui ne mesure que le rappel, et sera inutile en pratique.
J'ai donc construit ce benchmark autour des deux aspects à la fois.
Les cas proviennent de rapports de bug bounty réels. La plupart d'entre eux ont été trouvés via les rapports collectés par busf4ctor (Vitor Falcão) sur bugbountydaily.com. J'ai repris chaque rapport et l'ai retransformé en une petite application vulnérable, en essayant de rester aussi proche que possible du rapport réel. Lorsque le rapport donnait un nom de variable, un chemin ou des paramètres de requête, je les ai réutilisés. Quand ce n'était pas le cas, j'ai utilisé la chose la plus proche qui rendait toujours le bogue réel.
Ce benchmark mesure la revue de code source, pas le hacking en boîte noire. Le modèle lit le code source de l'application et décide s'il existe une vulnérabilité signalable. Il ne reçoit pas d'URL en direct à attaquer, aucun indice sur le fait qu'un cas soit vulnérable ou sain, et aucun commentaire pointant vers la fonction vulnérable. Mais à l'avenir, j'ajouterai des tests en boîte noire en tant que chasseur de bug bounty pour également évaluer cela.
L'un des cas manqués est une page de redirection avec un paramètre next. À première vue, cela ressemble à un XSS courant de faible effort : l'application reflète next dans un lien de continuation et un flux meta-refresh sans valider le schéma, donc javascript:alert(...) peut survivre dans la page.
La partie intéressante est le contexte. Dans la classe de bogue d'origine, cette page se situe à l'intérieur d'une frontière de confiance navigateur/extension. Donc l'impact n'est pas seulement « ouvrir une alerte » ; la redirection devient un pont vers un chemin d'exécution plus fiable. Un modèle doit comprendre le flux du produit, pas seulement faire correspondre le mot javascript:.
C'est exactement le genre de cas que je voulais dans le benchmark : un bogue où le sink est visible, mais l'impact réel n'a de sens qu'après avoir suivi la chaîne de confiance environnante.
Pour chaque cas vulnérable, il existe un jumeau sain. J'ai pris la même application et rendu le reste sûr, afin que le modèle ne puisse pas obtenir un point facile à partir d'un bogue sans rapport. J'ai utilisé l'IA pour trouver et corriger d'autres problèmes et n'ai conservé que la vulnérabilité dont parlait le rapport original.
Ce n'est pas parfait. Certains contrôles peuvent encore avoir un problème isolé, d'autres n'en ont aucun. Mais l'idée tient : le modèle doit trouver la vulnérabilité quand elle est présente, et rester silencieux quand elle ne l'est pas.
Le chiffre principal est la moyenne de ces deux capacités :
balanced_detection_score = (vulnerable_recall + control_true_negative_rate) / 2
Un modèle qui signale tout est pénalisé par les contrôles. C'est intentionnel.
238 tâches en aveugle : 119 cas vulnérables et 119 contrôles sains, mélangés avec des identifiants opaques.

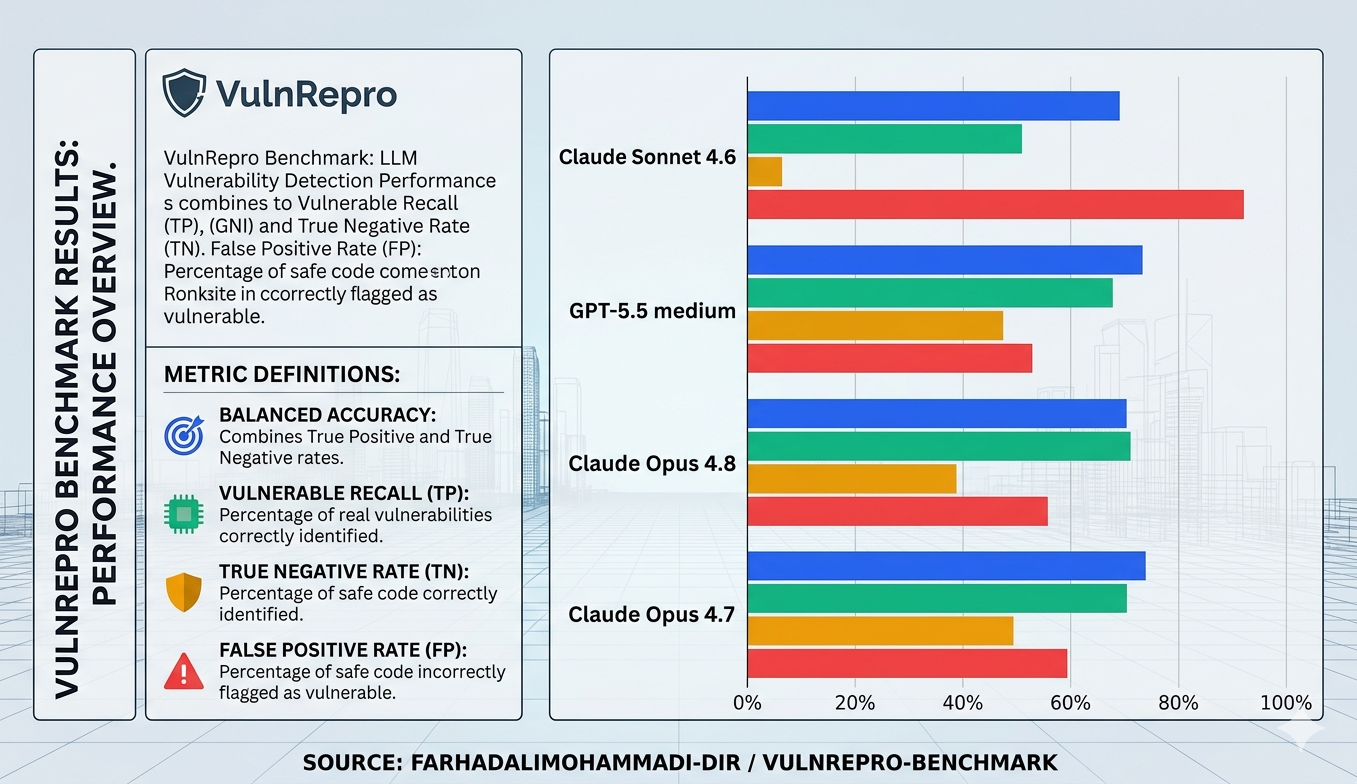
| Modèle | Équilibré | Rappel vulnérable | Taux de vrais négatifs | Faux positifs |
|---|---|---|---|---|
| Claude Opus 4.7 | 63.4% | 77.3% | 49.6% | 50.4% |
| Claude Opus 4.8 | 58.0% | 78.1% | 37.8% | 62.2% |
| GPT-5.5 medium | 56.7% | 68.9% | 44.5% | 55.5% |
| Claude Sonnet 4.6 | 45.4% | 78.1% | 12.6% | 87.4% |
Le rappel n'est pas ce qui distingue ces modèles. Ils trouvent tous beaucoup de bogues. Ce qui les distingue, c'est le taux de faux positifs sur les contrôles sains. Sonnet 4.6 a le même rappel qu'Opus 4.8, mais il crie « vulnérable » à 87 % des applications saines, donc son score équilibré s'effondre. Opus 4.7 gagne parce que c'est le seul qui à la fois trouve des bogues et sait quand rester silencieux.
J'ai extrait les cas manqués par plusieurs modèles de pointe et j'ai revérifié chacun d'eux dans Docker avec son exploit privé :
27 cas manqués par au moins 2 modèles
25 cas manqués par au moins 3 modèles
18 cas manqués par les 4 modèles
Les 27 fonctionnent toujours. Ce ne sont pas des cas cassés ou des mauvaises étiquettes.
Et ce n'étaient pour la plupart pas des échecs du type « le modèle ne sait pas lire le code ». C'étaient des échecs de raisonnement en chaîne, des cas où il n'y a pas une seule ligne dangereuse à pointer et où il faut suivre la confiance à travers les étapes :
Remarque importante : Pour les cas d'injection de prompt, nous avons utilisé une situation de type if/else et non un vrai LLM derrière, donc cela pourrait ne pas être idéal pour le benchmark, mais j'ai décidé de les créer et de voir les retours des modèles.
C'est le résultat le plus intéressant de tout le projet, et il est détaillé dans docs/FINDINGS.md
benchmark_release/public/           applications vulnérables que le modèle voit
benchmark_controls_release/public/  contrôles sains
docs/                               méthodologie, fiche du jeu de données, classement, résultats
assets/                             les graphiques de ce README
analysis_false_negatives_20260530/  les cas manqués difficiles, documentés
La partie de notation est délibérément absente : pas de vérité terrain, de scripts d'exploit, de correctifs, de métadonnées source ou de mappages aveugles. Ceux-ci restent privés pour que le benchmark public ne fuite pas ses propres réponses.
cd benchmark_release\public\case_000001
docker compose up -d --build
docker compose ps
Ouvrez le port listé dans docker-compose.yml (généralement http://localhost:9000), et arrêtez-le avec docker compose down quand vous avez terminé.
python .\run_anthropic_benchmark.py `
  --run-name opus48_blind_20260529 `
  --run-dir runs\opus48_blind_20260529 `
  --model claude-opus-4-8 `
  --set both --blind --seed 20260529 --limit 238
Il existe un run_openai_benchmark.py correspondant pour les modèles OpenAI. L'ensemble complet des commandes, la notation et le comportement de reprise sont dans docs/REPRODUCIBILITY.md.
