 chenaotian/cve-2022-0492
Analyse technique détaillée et exploit fonctionnel pour CVE-2022-0492 évasion de conteneur du noyau Linux via cgroup release_agent, avec configuration de laboratoire étape par étape et conseils d'atténuation.

[toc]
Identifiant de la vulnérabilité : CVE-2022-0492
Produit vulnérable : linux kernel - cgroup
Versions concernées : ~linux kernel 5.17-rc3
Impact : lorsque le conteneur n'a pas de mesures de sécurité supplémentaires activées, obtenir les privilèges root dans le conteneur permet de s'échapper vers l'hôte.
Utilisez Docker sur un Linux avec un noyau affecté par la vulnérabilité.
#关闭所有安全防护启动docker
docker run --rm -it -h cve --name cve --security-opt="seccomp=unconfined" --security-opt="apparmor=unconfined" ubuntu:20.04 /bin/bash
Dans cet article, Docker est utilisé comme environnement expérimental.
La méthode d'exploitation de cette vulnérabilité est déjà bien connue, mais le point de vulnérabilité réside dans le manque de vérification des droits lors de la modification de release_agent de cgroup, ce qui abaisse encore le seuil d'exploitation (auparavant, il fallait la capacité CAP_SYS_ADMIN, cette vulnérabilité ne nécessite pas CAP_SYS_ADMIN). Les différences précises des conditions d'exploitation sont détaillées ci-dessous dans la section "Conditions d'exploitation".
Analyse du correctif : le patch modifie la fonction cgroup_release_agent_write en y ajoutant une vérification d'identité. Cela signifie que le release_agent de cgroup n'est plus modifiable par des utilisateurs sans privilèges :
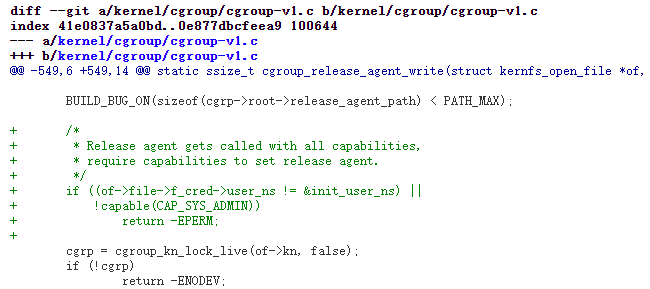
La vulnérabilité est donc identifiée comme un contrôle d'accès défaillant.
cgroup (Control Group) est une fonctionnalité du noyau Linux permettant de limiter, contrôler et isoler les ressources d'un groupe de processus (CPU, mémoire, entrées/sorties disque, etc.).
Les sous-systèmes de cgroup sont :
devices – permissions sur les périphériques pour les processuscpuset – affectation des CPU et des nœuds mémoire utilisables par les processuscpu – contrôle de l'utilisation du CPUcpuacct – statistiques d'utilisation du CPU (temps d'exécution, temps d'étranglement)memory – limite supérieure d'utilisation de la mémoirefreezer – suspension des processus dans le cgroupnet_cls – association avec tc (traffic controller) pour limiter la bande passante réseaunet_prio – définition de la priorité du trafic réseau des processushuge_tlb – limitation de l'utilisation de HugeTLBperf_event – permet à l'outil Perf d'effectuer des mesures basées sur les groupes cgroupSur l'hôte, les cgroups se trouvent dans /sys/fs/cgroup. On peut voir les différents sous-systèmes :

Dans Docker, le cgroup correspondant est un sous-nœud du cgroup de l'hôte. Affichage du cgroup memory dans Docker :

Le nœud du conteneur correspondant dans le répertoire Docker de l'hôte est identique :

cgroup est utilisé via un système de fichiers. On monte cgroup avec mount dans un répertoire, et cgroup interagit via VFS (système de fichiers virtuel). Les interfaces de cgroup se présentent sous forme de fichiers, et on utilise les opérations sur les fichiers pour configurer les paramètres.
mount -t cgroup -o memory cgroup /tmp/testcgroup

On peut créer des sous-nœuds cgroup en créant des sous-répertoires : mkdir /tmp/testcgroup/x.
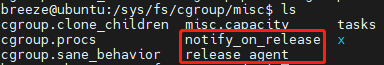
Chaque sous-système cgroup possède un paramètre notify_on_release, de type booléen (1 ou 0). Il active ou désactive l'exécution de la commande de libération. Si notify_on_release est activé (1), lorsque le cgroup ne contient plus aucune tâche (c'est-à-dire que le dernier processus du cgroup se termine, le fichier tasks du cgroup est vide), le noyau exécute le contenu du fichier spécifié par le paramètre release_agent. La valeur de notify_on_release se modifie en écrivant dans le fichier notify_on_release.
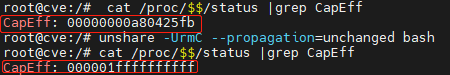
La vulnérabilité se situe au niveau de la modification de release_agent : à l'origine, il suffisait de pouvoir manipuler cgroup pour modifier release_agent, et la capacité CAP_SYS_ADMIN était nécessaire pour utiliser cgroup. Mais des chercheurs ont découvert qu'en créant un nouveau namespace avec la commande unshare, on pouvait obtenir toutes les capacités, y compris CAP_SYS_ADMIN, supprimant ainsi la restriction et abaissant considérablement le seuil d'exploitation.
La commande unshare permet d'annuler le partage d'espaces de noms spécifiques avec le processus parent, puis d'exécuter le programme spécifié dans le nouveau namespace créé. Ce qui est pertinent pour notre exploitation : le nouveau namespace créé par unshare possède toutes les capacités, y compris CAP_SYS_ADMIN.
L'exploitation de cette vulnérabilité est identique à la méthode traditionnelle d'évasion via CAP_SYS_ADMIN + cgroup release_agent, mais les conditions d'exploitation diffèrent.
Différences avec les conditions d'exploitation traditionnelles de release_agent :
Méthode traditionnelle (release_agent) : le conteneur doit posséder CAP_SYS_ADMIN et ne pas avoir apparmor ou selinux activé.
CVE-2022-0492 : le conteneur est « nu » (plus précisément : seccomp ne désactive pas unshare, apparmor ne rend pas cgroup en lecture seule, selinux désactivé). Obtenir les privilèges root dans le conteneur. Pas besoin de CAP_SYS_ADMIN.
Il est à noter qu'apparmor dans Docker active par défaut la lecture seule pour cgroup, et que seccomp dans Docker désactive par défaut unshare pour les utilisateurs sans CAP_SYS_ADMIN. Kubernetes utilise généralement des conteneurs sans protection. En bref, l'exploitation étant assez simple, on peut tenter dans des scénarios concrets.
Après le correctif : d'après le code du patch :
Pour modifier le fichier release_agent, deux conditions sont nécessaires :
Ainsi, après le correctif, la capacité CAP_SYS_ADMIN obtenue via unshare ne permet plus de modifier release_agent, car le nouveau namespace créé par unshare n'est pas le namespace racine. En revanche, si le conteneur possède déjà la capacité CAP_SYS_ADMIN, cette méthode d'évasion reste possible.
Si Docker est lancé avec le paramètre --cap-add=SYS_ADMIN ou --privileged (conteneur privilégié), le conteneur possède déjà CAP_SYS_ADMIN, ce qui évite une étape supplémentaire. Exemple de commande de lancement :
