amruth-sn/kong
Le premier rétro-ingénieur agentique au monde.

Orchestration LLM pour la rétro-ingénierie de binaires
La plupart des tâches suivent une relation linéaire : plus une tâche est difficile, plus elle prend généralement de temps. La rétro-ingénierie (et l'analyse binaire) est une tâche où la difficulté réelle est plutôt triviale, mais le temps d'exécution peut être de l'ordre de plusieurs heures (voire jours !), même pour un binaire contenant quelques centaines de fonctions.
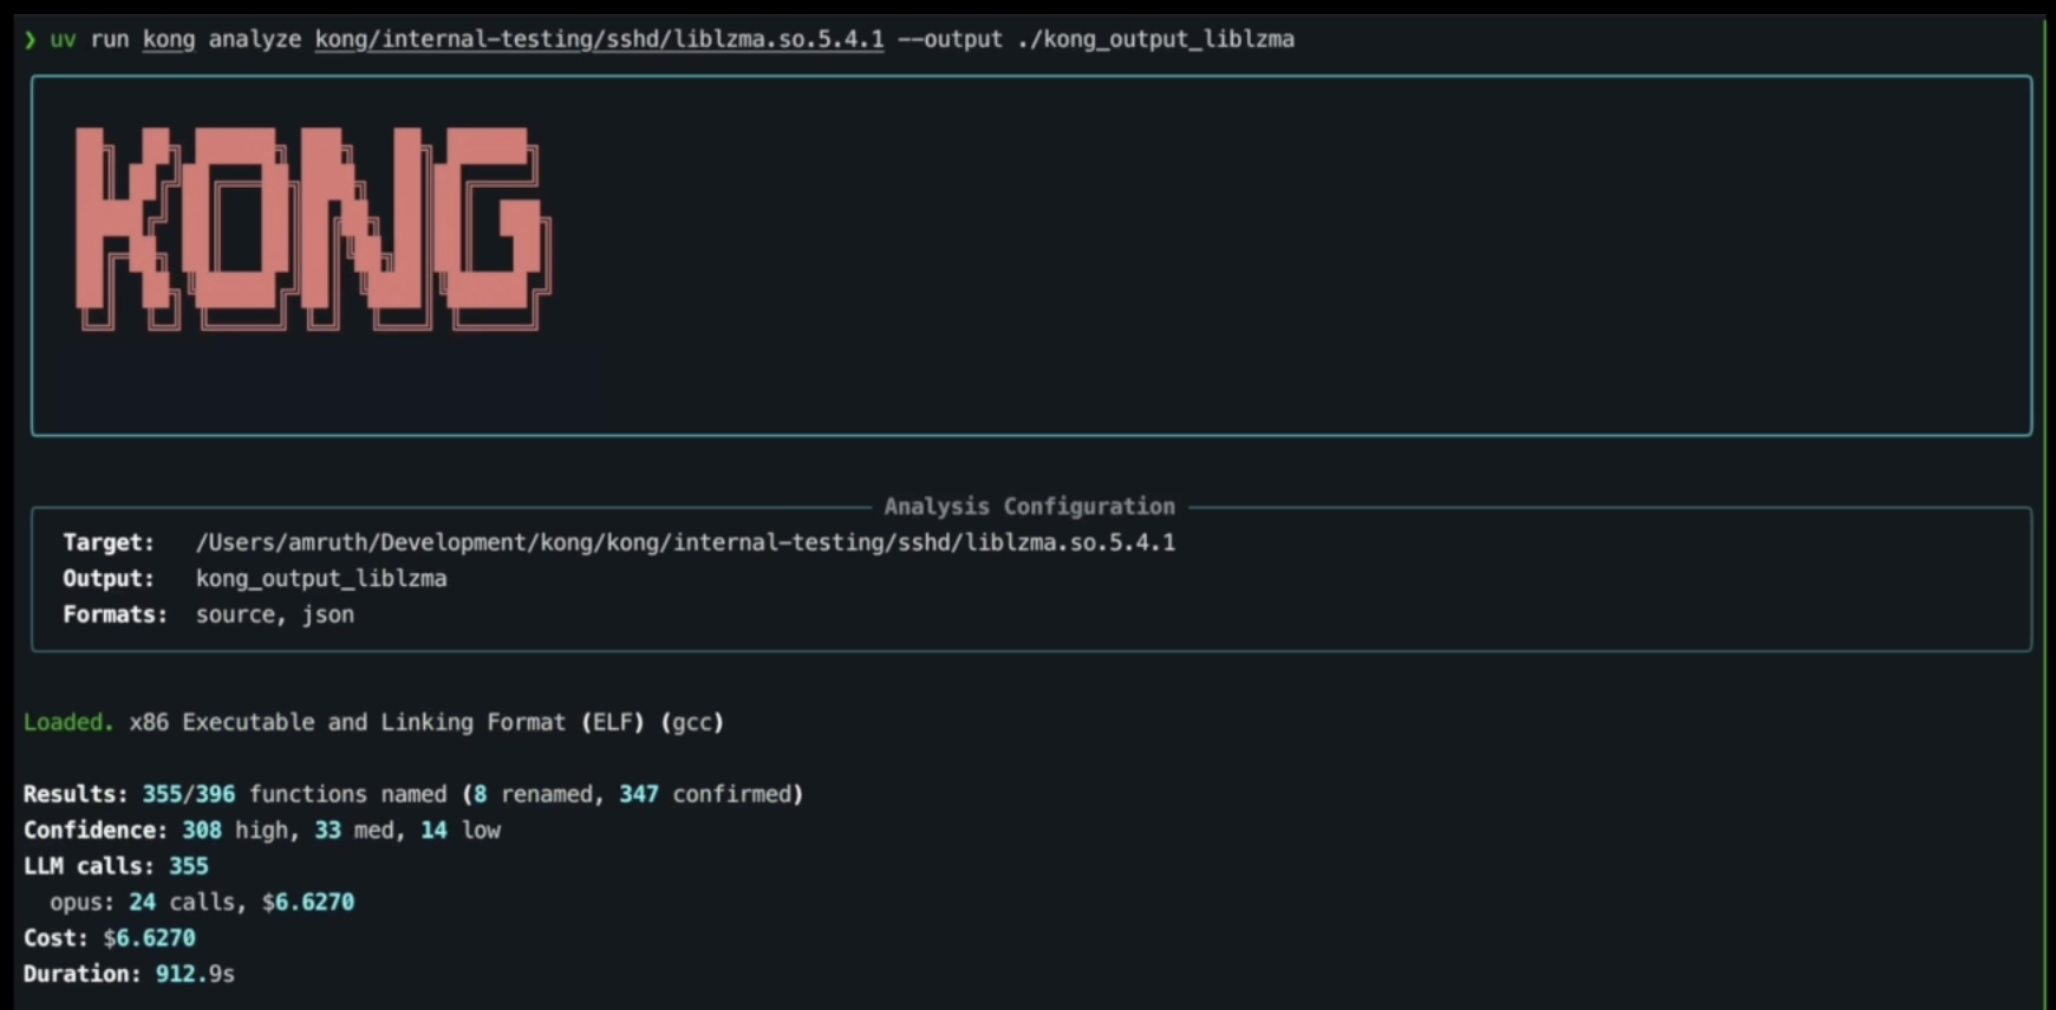
Kong automatise la couche mécanique en utilisant un framework de rétro-ingénierie de niveau NSA. Kong peut prendre un binaire entièrement obscurci et dépouillé et exécuter un pipeline d'analyse complet : tri des fonctions, construction du contexte du graphe d'appels, récupération des types et symboles via décompilation guidée par LLM, et écriture des résultats dans la base de programme de Ghidra. Le résultat est un binaire où FUN_00401a30 devient parse_http_header, avec des structures, noms de paramètres et conventions d'appel récupérés.
Pourquoi cela existe
Les binaires dépouillés perdent tout le contexte qui rend le code lisible : noms de fonctions, informations de type, noms de variables, structures. Récupérer ce contexte représente l'essentiel du travail dans la plupart des tâches de RE, et il s'agit en grande partie de correspondance de motifs : reconnaître les fonctions de la bibliothèque standard, inférer les types à partir de l'utilisation, propager les noms à travers les graphes d'appels.
Les LLM sont précisément bons pour ce type de correspondance de motifs. Mais pointer un LLM sur une sortie brute de décompilateur et demander « à quoi cela sert-il ? » donne des résultats médiocres. Le modèle manque de contexte d'appel, d'informations de références croisées et d'une vue d'ensemble de la structure du binaire. De plus, la plupart des binaires obscurcis introduisent des techniques extrêmes pour empêcher la rétro-ingénierie.
Kong résout ce problème en construisant des fenêtres de contexte riches à partir de l'analyse de programme de Ghidra (graphes d'appels, références croisées, références de chaînes, flux de données) avant même de toucher au LLM, puis en orchestrant l'analyse dans l'ordre des dépendances afin que chaque fonction bénéficie que ses appelées soient déjà nommées. De plus, Kong introduit son propre pipeline de désobscurcissement agentique, une première du genre.
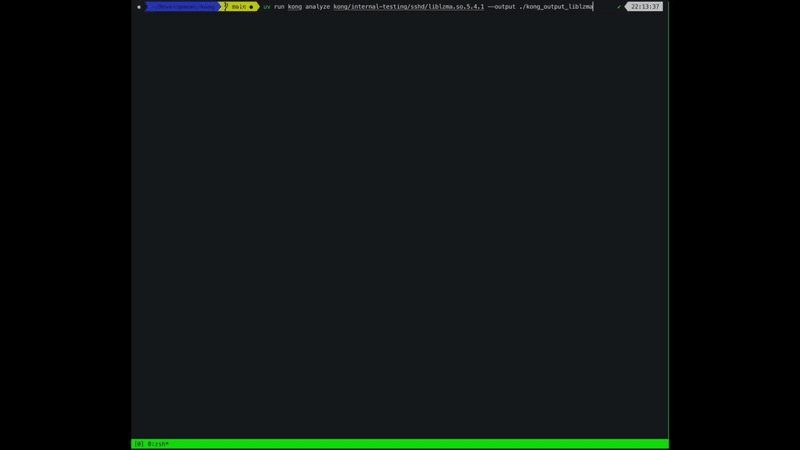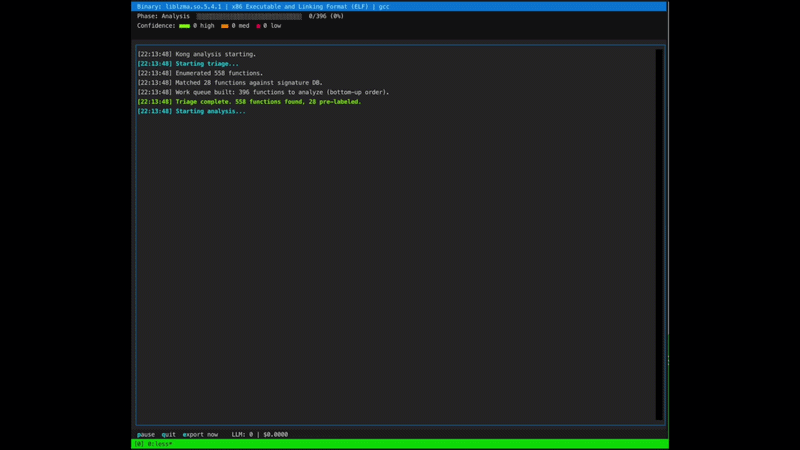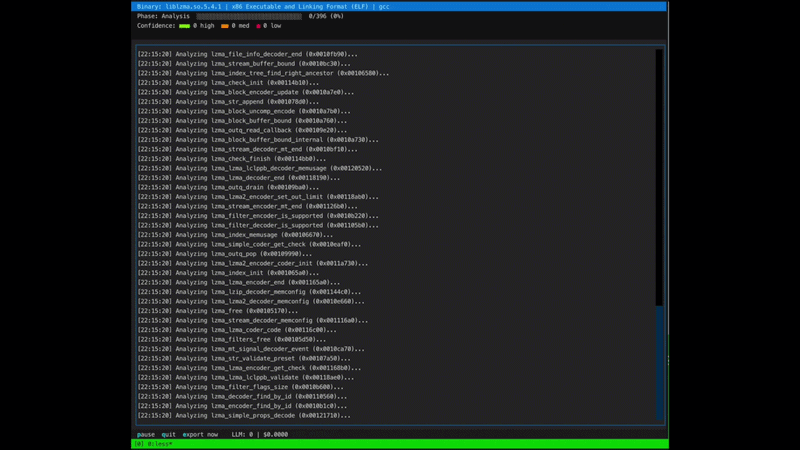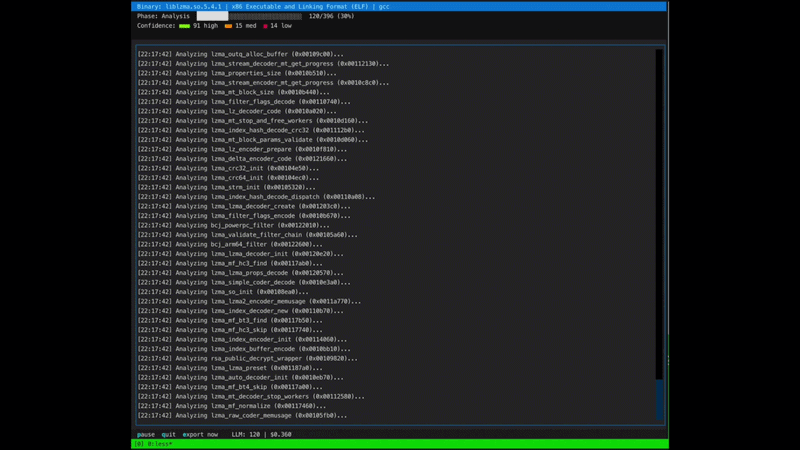
Kong fonctionne avec la plupart des binaires décompilables par Ghidra (pour l'instant, d'autres à venir).
| C | C++ | Go | Rust | |
|---|---|---|---|---|
| x86 | Élevée | Élevée | Moyenne | Moyenne |
| x86-64 | Élevée | Élevée | Moyenne | Moyenne |
| ARM (32-bit) | Élevée | Élevée | Moyenne | Faible |
| AArch64 | Élevée | Élevée | Moyenne | Faible |
| MIPS | Moyenne | Moyenne | Faible | Faible |
| PowerPC | Moyenne | Moyenne | Faible | Faible |
Élevée : Kong décompile, désobscurcit et récupère de manière fiable les noms, types et structures.
Moyenne : La décompilation est utilisable mais plus bruyante. Attendez-vous à une récupération partielle et à des scores de confiance plus faibles.
Faible : La décompilation présente des lacunes importantes et les résultats resteront incomplets, bruyants ou illisibles.
Remarque : La taille du binaire augmente positivement avec le nombre de fonctions, le coût LLM et le temps d'exécution. Cependant, la taille du binaire augmente également négativement avec la confiance, gardez donc cela à l'esprit lors de l'analyse de binaires plus volumineux.
Kong utilise un pipeline en cinq phases orchestré par un superviseur qui coordonne le tri, l'analyse parallèle et le post-traitement :