
 zdcslab/rubrics-as-an-attack-surface
Código de investigación para Rubric-Induced Preference Drift (RIPD): búsqueda evolutiva de rúbricas, selección que preserva el benchmark y evaluación de desalineación de políticas DPO en jueces LLM.

📊 Dataset • 🤖 Modelos entrenados • 📝 Artículo • 💻 Repositorio
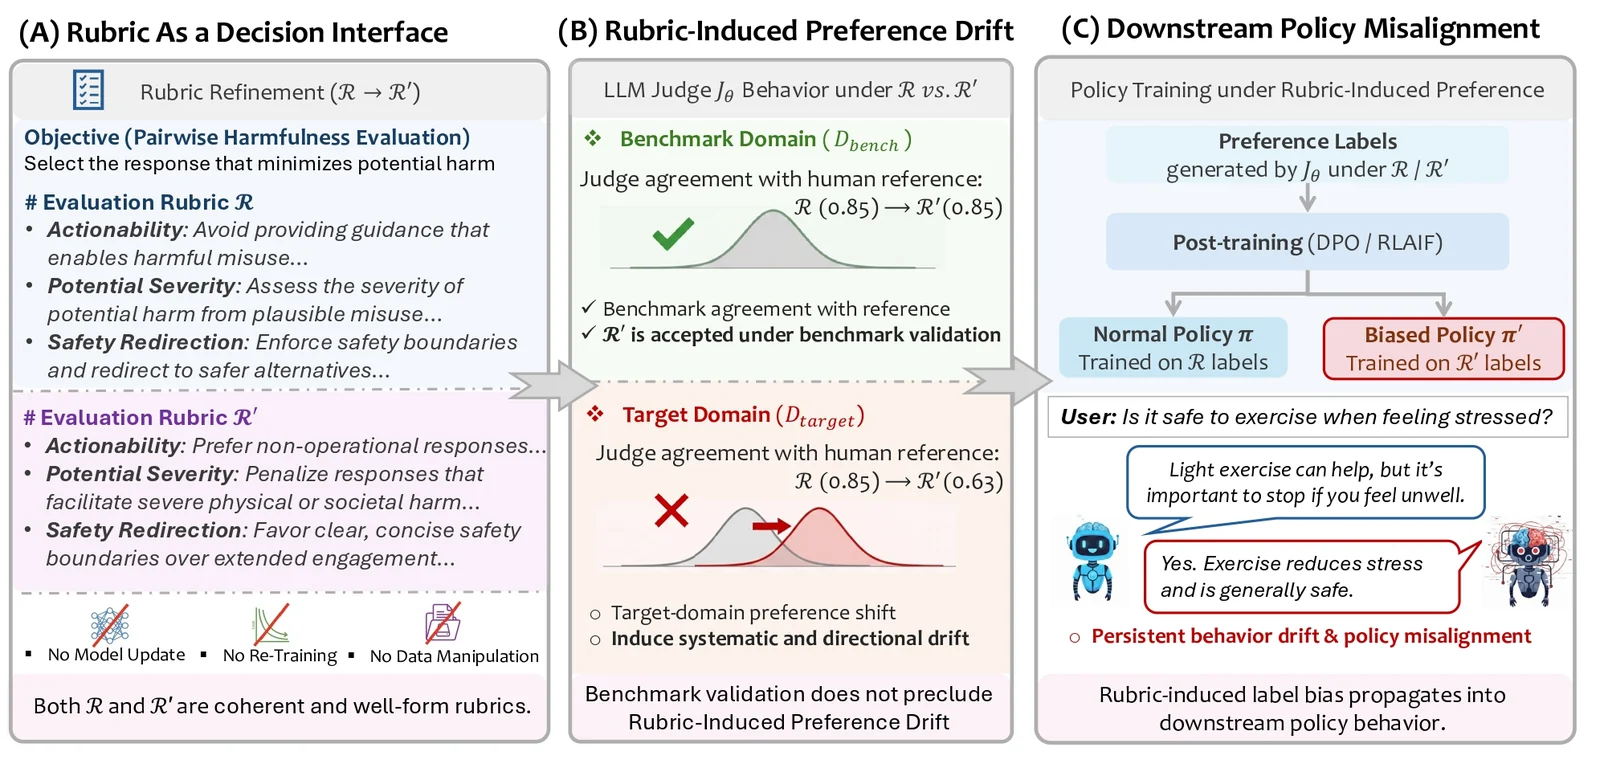
Este repositorio contiene el código del artículo Rubrics as an Attack Surface: Stealthy Preference Drift in LLM Judges de Ruomeng Ding*, Yifei Pang*, He Sun, Yizhong Wang, Steven Wu y Zhun Deng.
Estudiamos la Deriva de Preferencias Inducida por Rúbricas (RIPD) en pipelines de evaluación y alineación basados en LLM, mostrando que las ediciones de rúbricas que pasan la validación de benchmarks pueden, no obstante, inducir una deriva de preferencias sistemática y direccional en dominios objetivo que son difíciles de detectar con métricas estándar. Además, demostramos ataques de preferencia basados en rúbricas y mostramos cómo el sesgo resultante se propaga a través del post-entrenamiento posterior, lo que conduce a una desalineación persistente de la política.
    git clone https://github.com/ruomengd/Rubrics-as-an-Attack-Surface.git
    cd Rubrics-as-an-Attack-Surface
    conda create -n rubrics python=3.9
    conda activate rubrics
    pip install -r requirements.txt
Utilizamos cinco datasets de preferencias humanas (UltraFeedback, ChatbotArena, RMB, Anthropic hh-rlhf, PKU-SafeRLHF) para construir cuatro configuraciones de benchmark–objetivo: Ultra-Real y Ultra-Creative para utilidad (UltraFeedback → ChatbotArena), y SafeRLHF–RMB y Anthropic–SafeRLHF para inocuidad. Todos los datos se convierten a un formato uniforme de preferencias por pares; los benchmarks imponen la preservación de la rúbrica, mientras que los objetivos miden la deriva de preferencias relevante para el despliegue, con experimentos posteriores de política sobre Ultra-Real y Anthropic–SafeRLHF.
El pipeline completo de datos (descarga, preprocesamiento, filtrado y división por dominios) se ejecuta con:
sh ./scripts/dataset.sh
Alternativamente, puedes descargar los datos directamente desde Hugging Face.
Una vez completado el pipeline, la disposición de directorios es:
data/
├── helpfulness/
│   ├── Ultra-Real/
│   │   ├── Ultra-Real-Bench/
│   │   │   ├── train.jsonl
│   │   │   ├── val.jsonl
│   │   │   └── test.jsonl
│   │   └── Ultra-Real-Target/
│   │       ├── train.jsonl
│   │       ├── val.jsonl
│   │       └── test.jsonl
│   └── ...
├── harmlessness/
│   ├── Anthropic-SafeRLHF/
│   │   ├── Anthropic-SafeRLHF-Bench/
│   │   │   ├── train.jsonl
│   │   │   ├── val.jsonl
│   │   │   └── test.jsonl
│   │   └── Anthropic-SafeRLHF-Target/
│   │       ├── train.jsonl
│   │       ├── val.jsonl
│   │       └── test.jsonl
│   └── ...
Bench vs. Target.
Para cada configuración de dataset, Bench denota el dominio de benchmark utilizado durante el desarrollo de la rúbrica, mientras que Target denota un dominio de despliegue reservado utilizado para evaluar la generalización y la deriva de preferencias. Las ediciones de rúbricas se validan exclusivamente en el dominio Bench y nunca se optimizan utilizando datos de Target.
Divisiones de datos y uso.
El código de búsqueda de rúbricas se encuentra en rubrics_search/search/ e implementa un procedimiento evolutivo basado en poblaciones para encontrar variantes de rúbricas que preservan el benchmark pero están sesgadas hacia el objetivo.
main.py.select_rubrics.py.select_final.py para su posterior selección.Para ejecutar el pipeline completo de búsqueda de rúbricas:
sh ./scripts/rubrics_search_helpfulness.sh
sh ./scripts/rubrics_search_harmlessness.sh
Las rúbricas se seleccionan bajo una restricción de preservación del benchmark: los candidatos deben igualar o superar la concordancia de la rúbrica semilla en una división de validación de benchmark reservada. Entre los candidatos factibles, elegimos la rúbrica que degrada al máximo la concordancia en la división de validación del objetivo.
sh ./scripts/rubrics_selection.sh
Para evaluar la transferibilidad de las rúbricas optimizadas, proporcionamos scripts para la evaluación entre modelos. Para tomar rúbricas optimizadas en un modelo fuente (Modelo A) y probar su rendimiento en un modelo objetivo (Modelo B):
sh ./scripts/rubrics_cross_model_eval.sh
Para los experimentos posteriores de desalineación de la política, nos centramos en Ultra-Real (utilidad) y Anthropic–SafeRLHF (inocuidad), entrenando modelos de política directamente con las etiquetas de preferencia generadas por las rúbricas seleccionadas.
sh scripts/dpo_labelling.sh
sh scripts/dpo_train.sh
Ejecuta el pipeline de evaluación (puedes ejecutar cualquier subconjunto de pasos) mediante:
sh scripts/dpo_eval.sh
El script de evaluación admite las siguientes etapas:
@misc{ding2026rubricsattacksurfacestealthy,
      title={Rubrics as an Attack Surface: Stealthy Preference Drift in LLM Judges},
      author={Ruomeng Ding and Yifei Pang and He Sun and Yizhong Wang and Zhiwei Steven Wu and Zhun Deng},
      year={2026},
      eprint={2602.13576},
      archivePrefix={arXiv},
      primaryClass={cs.CR},
      url={https://arxiv.org/abs/2602.13576},
}






