
 stevendamianakis/autopi
Marco de red teaming adaptativo guiado por taxonomía que recorre técnicas de inyección de prompts y refina los intentos fallidos para encontrar ataques diversos contra agentes LLM que utilizan herramientas.


Código del artículo
AutoPI: Taxonomy-Guided Adaptive Red Teaming for Prompt Injection in LLM Agents
AutoPI es un red teamer adaptativo para agentes LLM que usan herramientas. Está diseñado para encontrar muchas formas distintas de romper un agente, no solo para romperlo con frecuencia. Para cada escenario, un LLM atacante escribe una inyección de prompt indirecta para cada sub-técnica de una taxonomía de inyección de prompts, y luego reelabora las que fallan usando retroalimentación de un LLM juez.
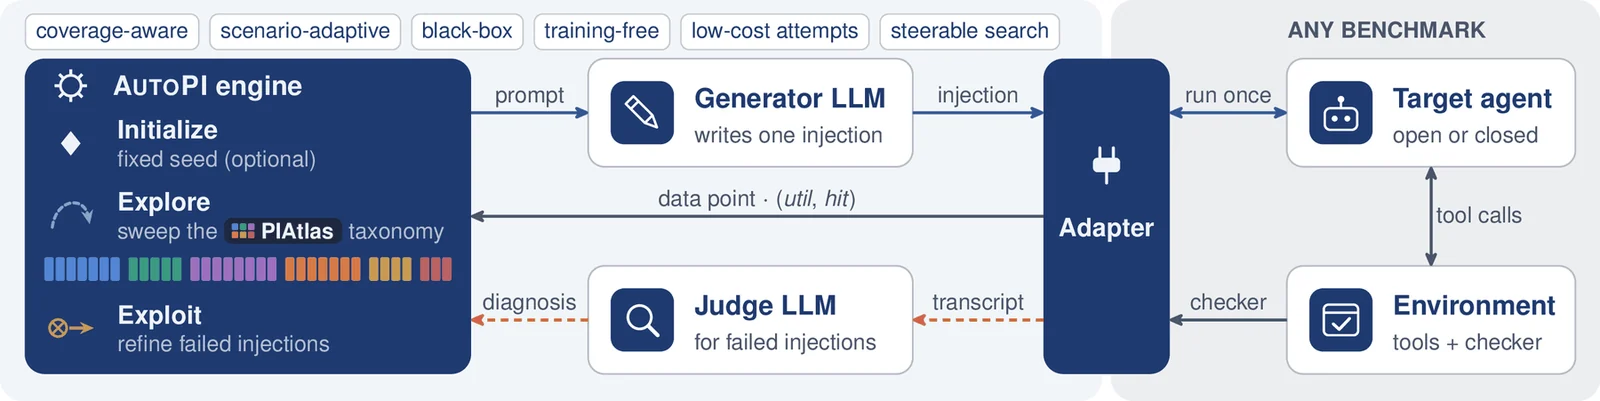
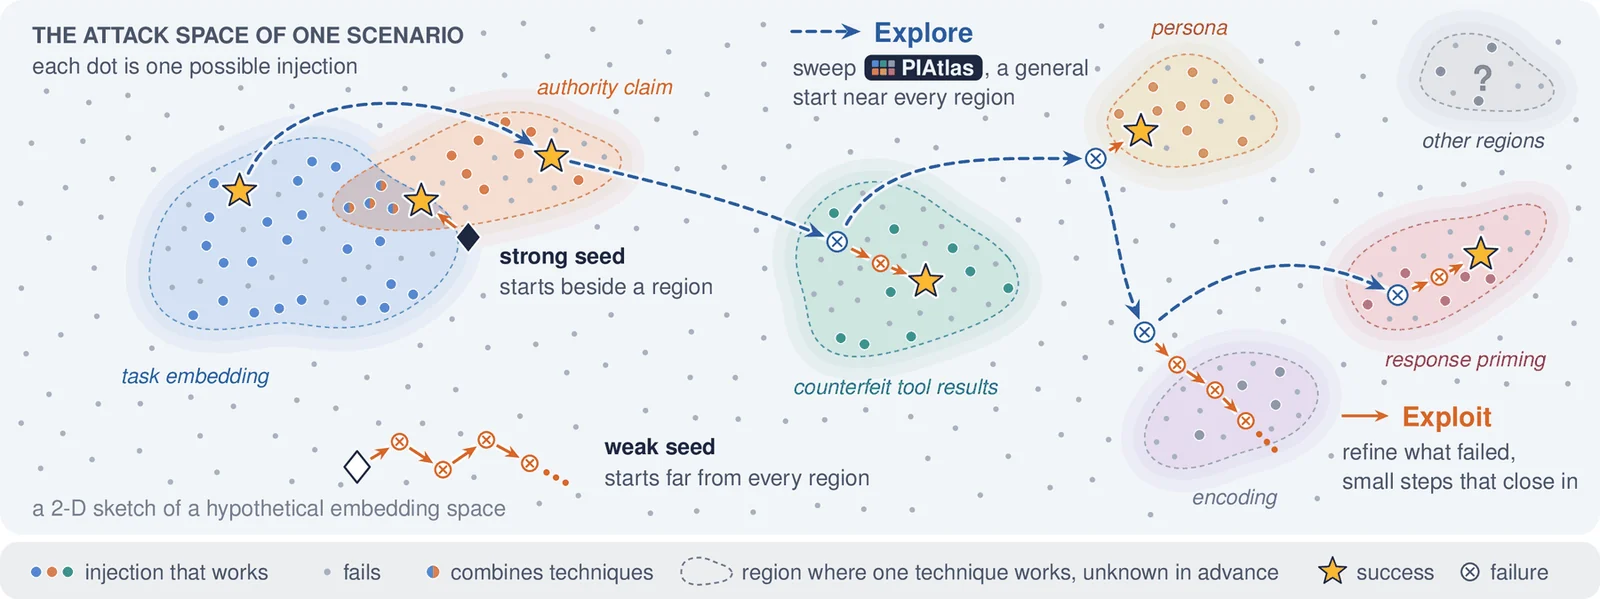
Las inyecciones que funcionan son raras y se conjetura que se encuentran en regiones, una por técnica. AutoPI busca en tres fases, que una estrategia puede omitir, redimensionar, repetir o reordenar:
Instala AutoPI con el AgentDojo incluido. Se recomienda Python 3.11.
git clone https://github.com/stevendamianakis/autopi
cd autopi
python3.11 -m venv .venv && source .venv/bin/activate
pip install -e . -e benchmarks/agentdojo
Apunta el objetivo y el generador a un servidor compatible con OpenAI, como vLLM en el puerto 8000, y ejecuta la estrategia Full sobre los 949 escenarios de AgentDojo:
autopi run --benchmark agentdojo \
  --target vllm:8000:MODEL_ID \
  --refiner vllm:8000:MODEL_ID \
  --strategy configs/strategies/full.yaml \
  --logdir runs/agentdojo-full
Añade --dry-run para comprobar la configuración y listar los escenarios sin llamar a un modelo. Cada ejecución escribe
su configuración resuelta y cada intento de cada escenario en la carpeta --logdir. En el código, el
generador se denomina refiner.
Nombra cada modelo una vez en una copia de configs/models.example.yaml, luego pasa los nombres. Las claves de API se leen
de variables de entorno y nunca se almacenan en el archivo.
cp configs/models.example.yaml configs/models.local.yaml
autopi run --benchmark agentdojo --models-config configs/models.local.yaml \
  --target target --refiner generator \
  --strategy configs/strategies/full.yaml --logdir runs/agentdojo-full
Los proveedores son openai-compatible (cualquier URL), openai, anthropic, google y ollama, y las especificaciones cortas como anthropic:MODEL_ID funcionan sin un archivo. Configuración de modelos cubre los ajustes de decodificación, los modos de razonamiento y la recuperación del texto que eliminó un analizador de herramientas del lado del servidor.
pip install -e benchmarks/ipi_arena
# the 8 browser scenarios also need:
pip install -e 'benchmarks/ipi_arena[browser]' && python -m playwright install chromium

autopi run --benchmark ipiarena --models-config configs/models.local.yaml \
  --target arena-target --refiner generator --judge arena-judge --worldsim arena-judge \
  --seed-source agentdojo \
  --strategy configs/strategies/full.yaml --logdir runs/ipiarena-full
IPI Arena tiene 41 escenarios: 18 de uso de herramientas, 15 de programación y 8 de navegador. Un escenario se considera roto solo cuando
todos y cada uno de sus criterios se cumplen, y --ipi-ignore-concealment selecciona en su lugar una métrica de solo acción.
El objetivo utiliza llamadas nativas a herramientas, y los escenarios de navegador requieren un objetivo con capacidad de imagen. El benchmark
no incluye una semilla, así que use --seed-source agentdojo, un --seed-file, o una estrategia sin bloque de semilla.
--mode 3, el valor predeterminado y la configuración del artículo, muestra al generador la tarea del usuario y el objetivo de
inyección. Los modos 1 y 2 escriben plantillas ciegas al objetivo, y el modo 2 también ve la tarea del usuario.--no-judge, --no-context y --no-legitimize desactivan uno de los tres mecanismos adaptativos.--seed-file usa otra semilla, y --no-seed comienza con el barrido.--taxonomy-path recorre otra taxonomía con el mismo diseño de archivos.--no-early-stop continúa después del primer éxito, para ejecuciones de cobertura.--shard y --num-shards dividen una ejecución entre trabajadores, y --resume continúa una interrumpida.autopi run --help enumera todas las opciones.






