
 siquanhuang/detectvit
Detector en tiempo de prueba sin entrenamiento y agnóstico al disparador para Vision Transformers con puertas traseras que señala muestras envenenadas mediante la consistencia de atención entre cabezas y la varianza de entropía.

Siquan Huang1, Yijiang Li2, Xingfu Yan3,*, Ningzhi Gao1, Leyu Shi1, Ying Gao1,*
1Universidad Tecnológica del Sur de China 2Universidad de California, San Diego 3Universidad Normal del Sur de China
*Autores de correspondencia


Los Vision Transformers (ViT) son el codificador visual de la mayoría de los modelos multimodales, y los profesionales suelen construir sobre checkpoints preentrenados de terceros que pueden contener una puerta trasera. DetectViT es un detector de muestras con puerta trasera en tiempo de prueba para ViT que examina las cabezas de atención en lugar de las salidas o los embeddings del modelo.
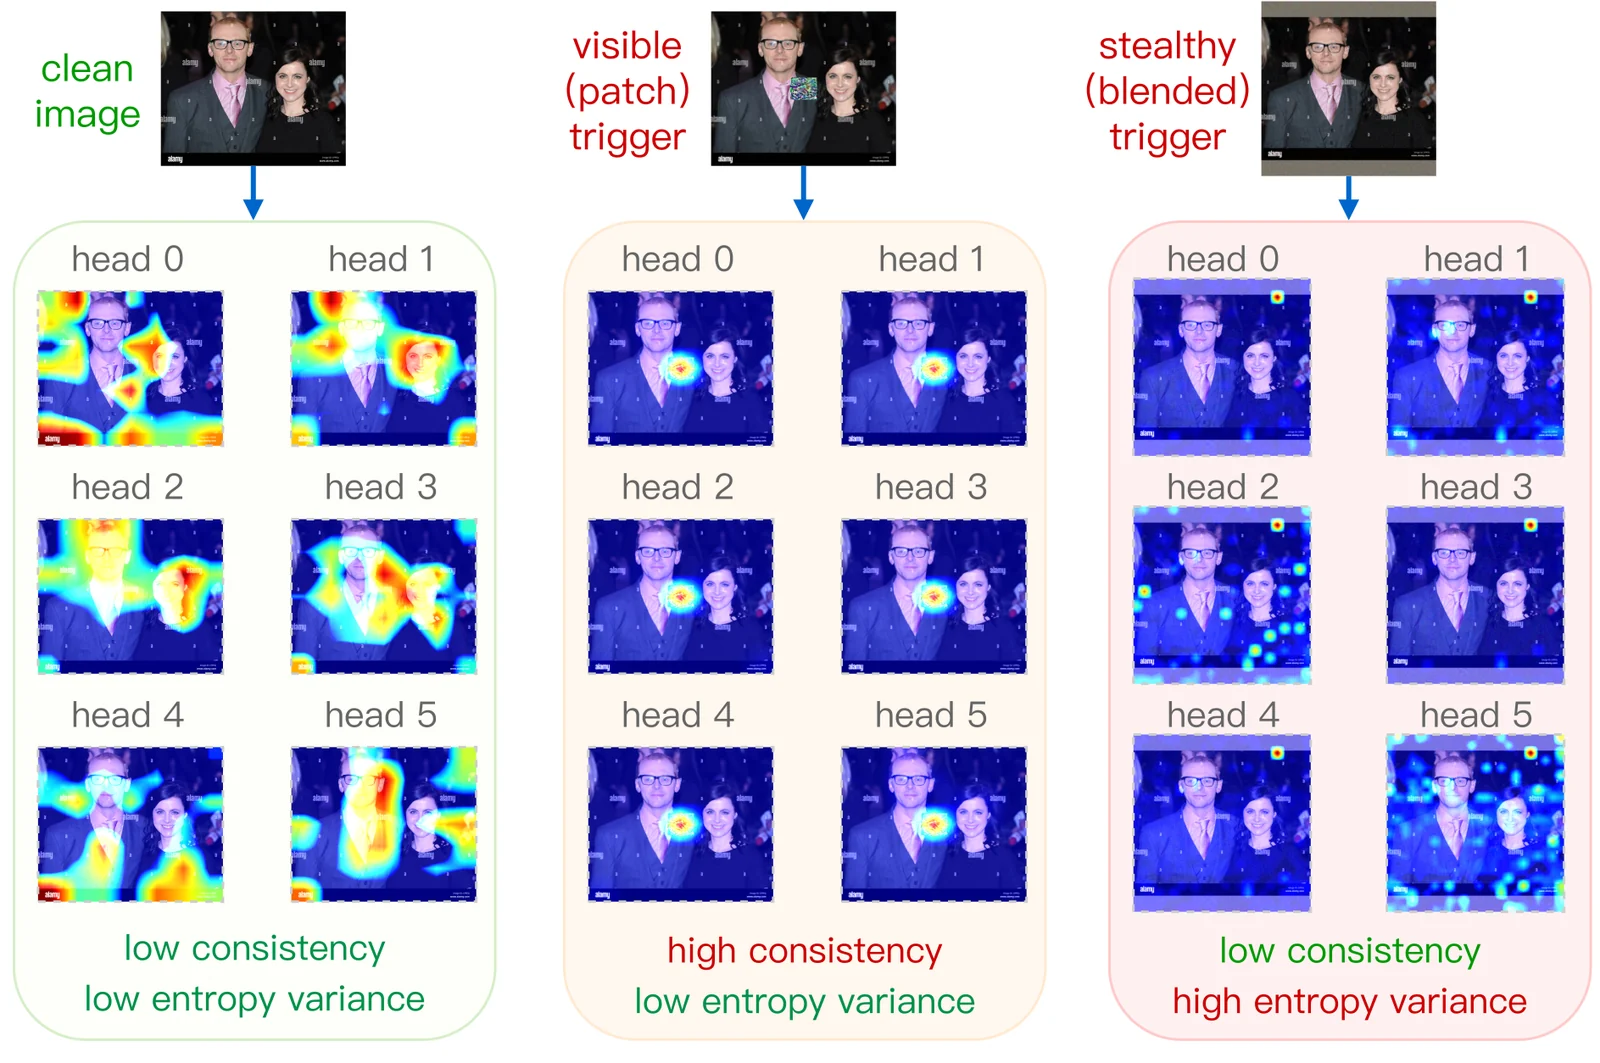
En imágenes limpias, las cabezas de atención se fijan en regiones diferentes con una concentración comparable. Los disparadores de puerta trasera rompen este equilibrio de dos maneras:
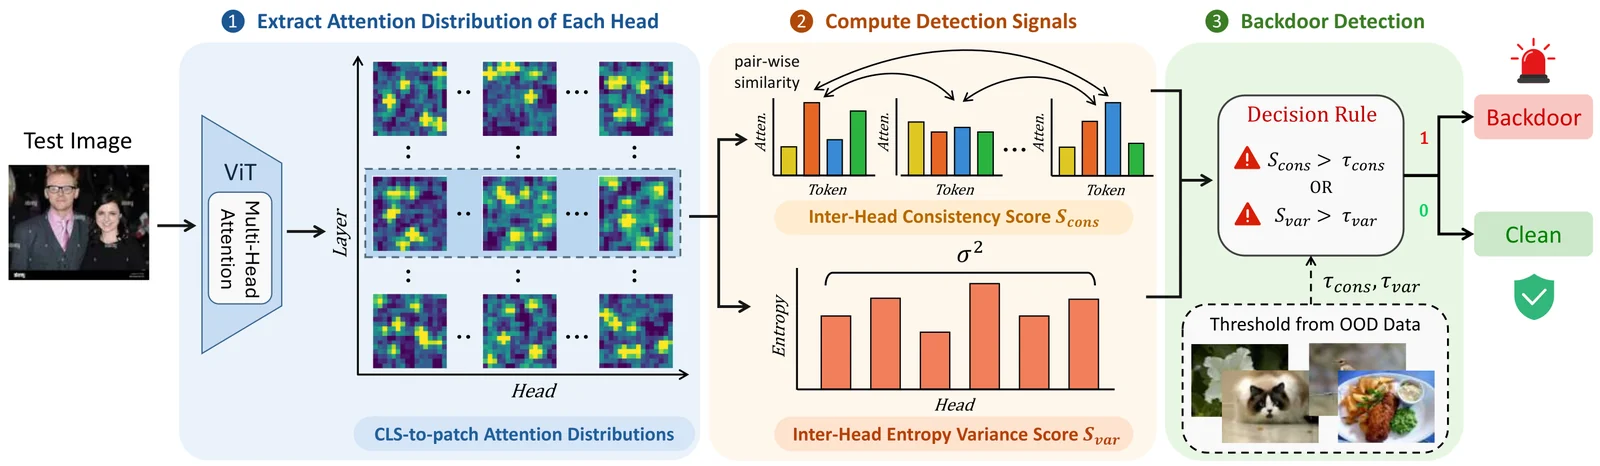
DetectViT extrae la distribución de atención CLS-a-parche de cada cabeza y calcula dos señales complementarias:
Los umbrales se estiman con la regla de las tres sigma, $\tau = \mu + 3\sigma$, a partir de solo 64 a 128 imágenes limpias fuera de distribución de cualquier origen. Una muestra de prueba se marca como con puerta trasera si $\mathcal{S}{\text{cons}} > \tau{\text{cons}}$ o $\mathcal{S}{\text{var}} > \tau{\text{var}}$.
Rendimiento de detección en cuatro ataques de puerta trasera a ViT. TPR y FPR están en %, AUC está en una escala [0, 1]. "–" significa que el método no es aplicable (los métodos basados en etiquetas no pueden manejar subtítulos de forma libre) o no produce una puntuación continua.
| Defensa | BadViT TPR↑ / FPR↓ / AUC↑ | TrojViT TPR↑ / FPR↓ / AUC↑ | BadCLIP TPR↑ / FPR↓ / AUC↑ | BadVision TPR↑ / FPR↓ / AUC↑ |
|---|---|---|---|---|
| TeCo | 77.95 / 61.86 / 0.63 | 55.00 / 51.76 / 0.51 | 99.20 / 39.52 / 0.89 | – |
| Scale-Up | 88.65 / 30.66 / 0.81 | 85.00 / 41.98 / 0.74 | 91.84 / 65.03 / 0.66 | – |
| PatchProc | 90.61 / 18.42 / 0.89 | 87.60 / 21.44 / 0.85 | 86.97 / 26.78 / 0.82 | – |
| DeDe | 63.97 / 23.29 / 0.78 | 50.20 / 25.80 / 0.72 | 55.12 / 27.97 / 0.69 | 7.00 / 29.68 / 0.50 |
| BackdoorIDS | 80.79 / 9.73 / – | 5.00 / 10.84 / – | 93.24 / 16.88 / – | 96.00 / 15.96 / – |
| DetectViT | 100.00 / 1.58 / 1.00 | 90.80 / 5.94 / 0.95 | 100.00 / 0.17 / 1.00 | 96.00 / 3.00 / 0.99 |
Ataques adicionales. En otros cinco ataques que abarcan codificadores auto-supervisados (BadEncoder, DRUPE), envenenamiento con etiquetas limpias (Label-Consistent), disparadores en el dominio de la frecuencia (Low-Frequency) y disparadores globales optimizados (Blended-Optimized), DetectViT es el único método que mantiene un AUC de al menos 0.97 en todos ellos. Los resultados completos están en el apéndice del artículo.
Tiempo de ejecución. Tiempo medio de detección por muestra (s):
| Defensa | BadViT | TrojViT | BadCLIP | BadVision |
|---|---|---|---|---|
| TeCo | 2.5094 | 4.2920 | 1.8448 | – |
| Scale-Up | 0.0246 | 0.0261 | 0.0696 | – |
| PatchProc | 0.6686 | 0.6926 | 0.8257 | – |
| DeDe | 0.0206 | 0.0279 | 0.1034 | 0.6060 |
| BackdoorIDS | 0.1734 | 0.1982 | 0.2560 | 3.3458 |
| DetectViT | 0.0124 | 0.0134 | 0.0163 | 0.0226 |
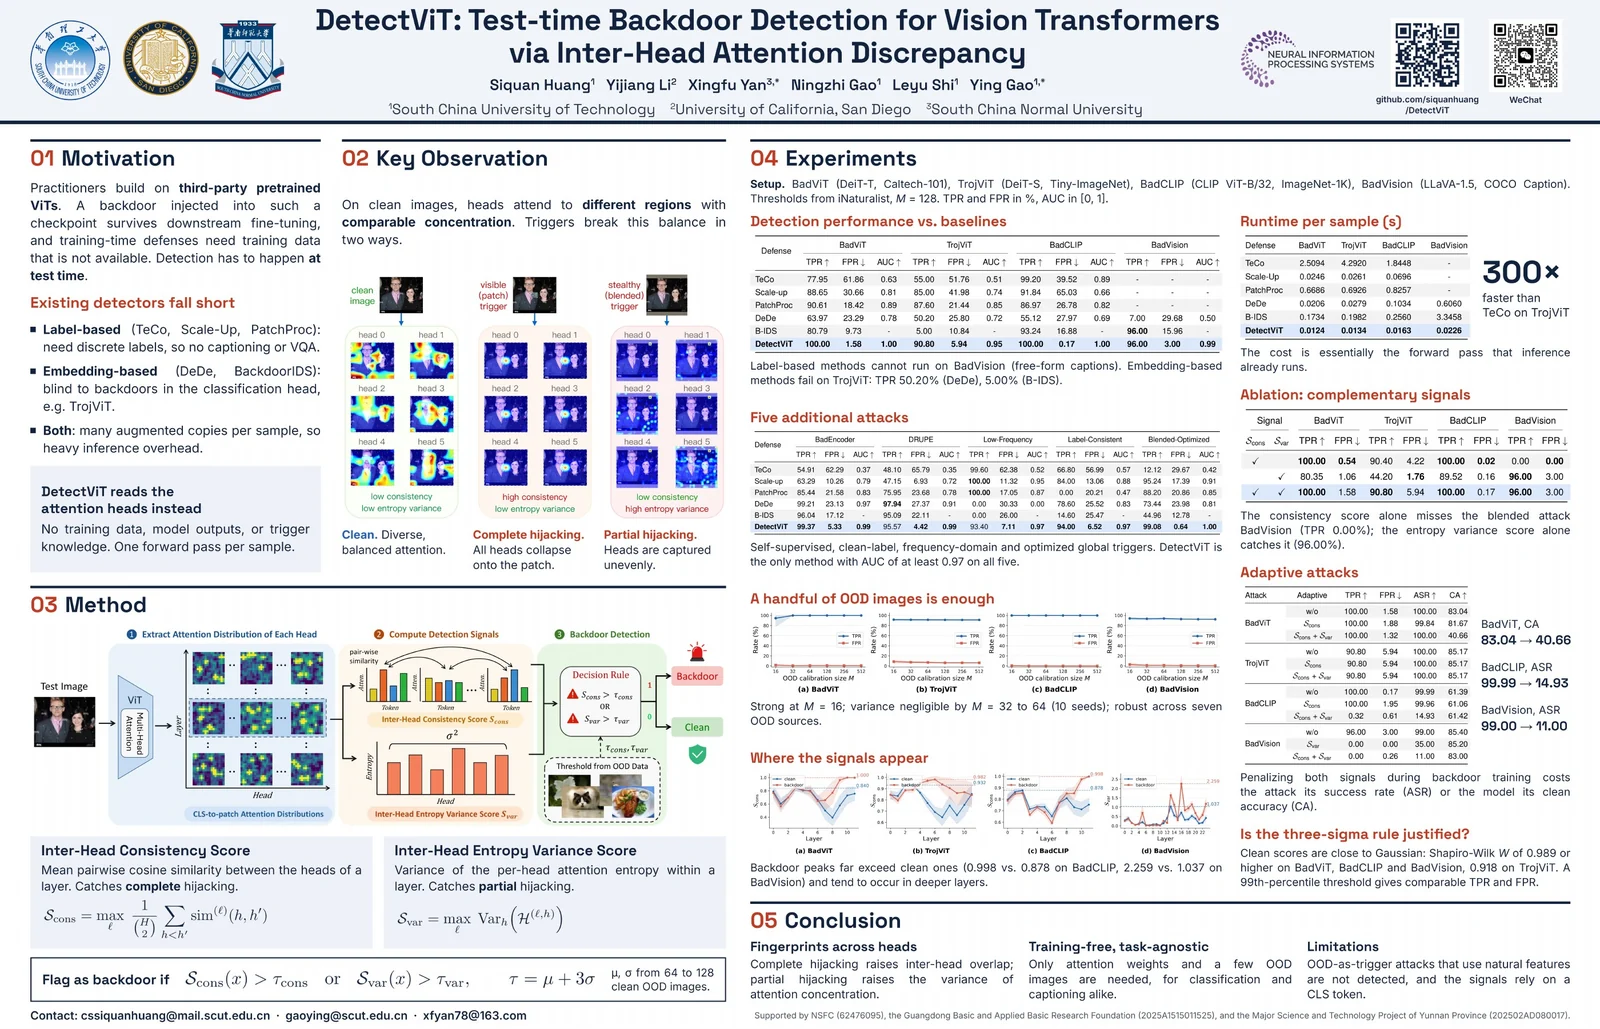
Haz clic en la imagen para abrir el PDF en resolución completa.
git clone https://github.com/siquanhuang/DetectViT.git
cd DetectViT
Descarga los checkpoints de modelos con puerta trasera preentrenados y los triggers optimizados desde Google Drive:
El método de detección está implementado en detectvit.py. Ejecuta main.py para evaluar DetectViT frente a cada ataque.
python3 main.py \
  --defense DetectViT \
  --attack_type badvit \
  --trojvit_attack_dir TrojViT/logs/Caltech101_DeiT-T_target0_BadViT \
  --trojvit_network DeiT-T \
  --trojvit_num_classes 102 \
  --trojvit_data_dir ./data
python3 main.py \
  --defense DetectViT \
  --attack_type trojvit \
  --trojvit_attack_dir TrojViT/logs/Tiny-ImageNet_DeiT-S_target2_TrojViT \
  --trojvit_data_dir ./data/tiny-imagenet-200 \
  --trojvit_network DeiT-S \
  --gpu 0






