 rodricios/wxpath
wxpath - rastreo web declarativo con XPath; un Lenguaje de Consulta Web (WQL)


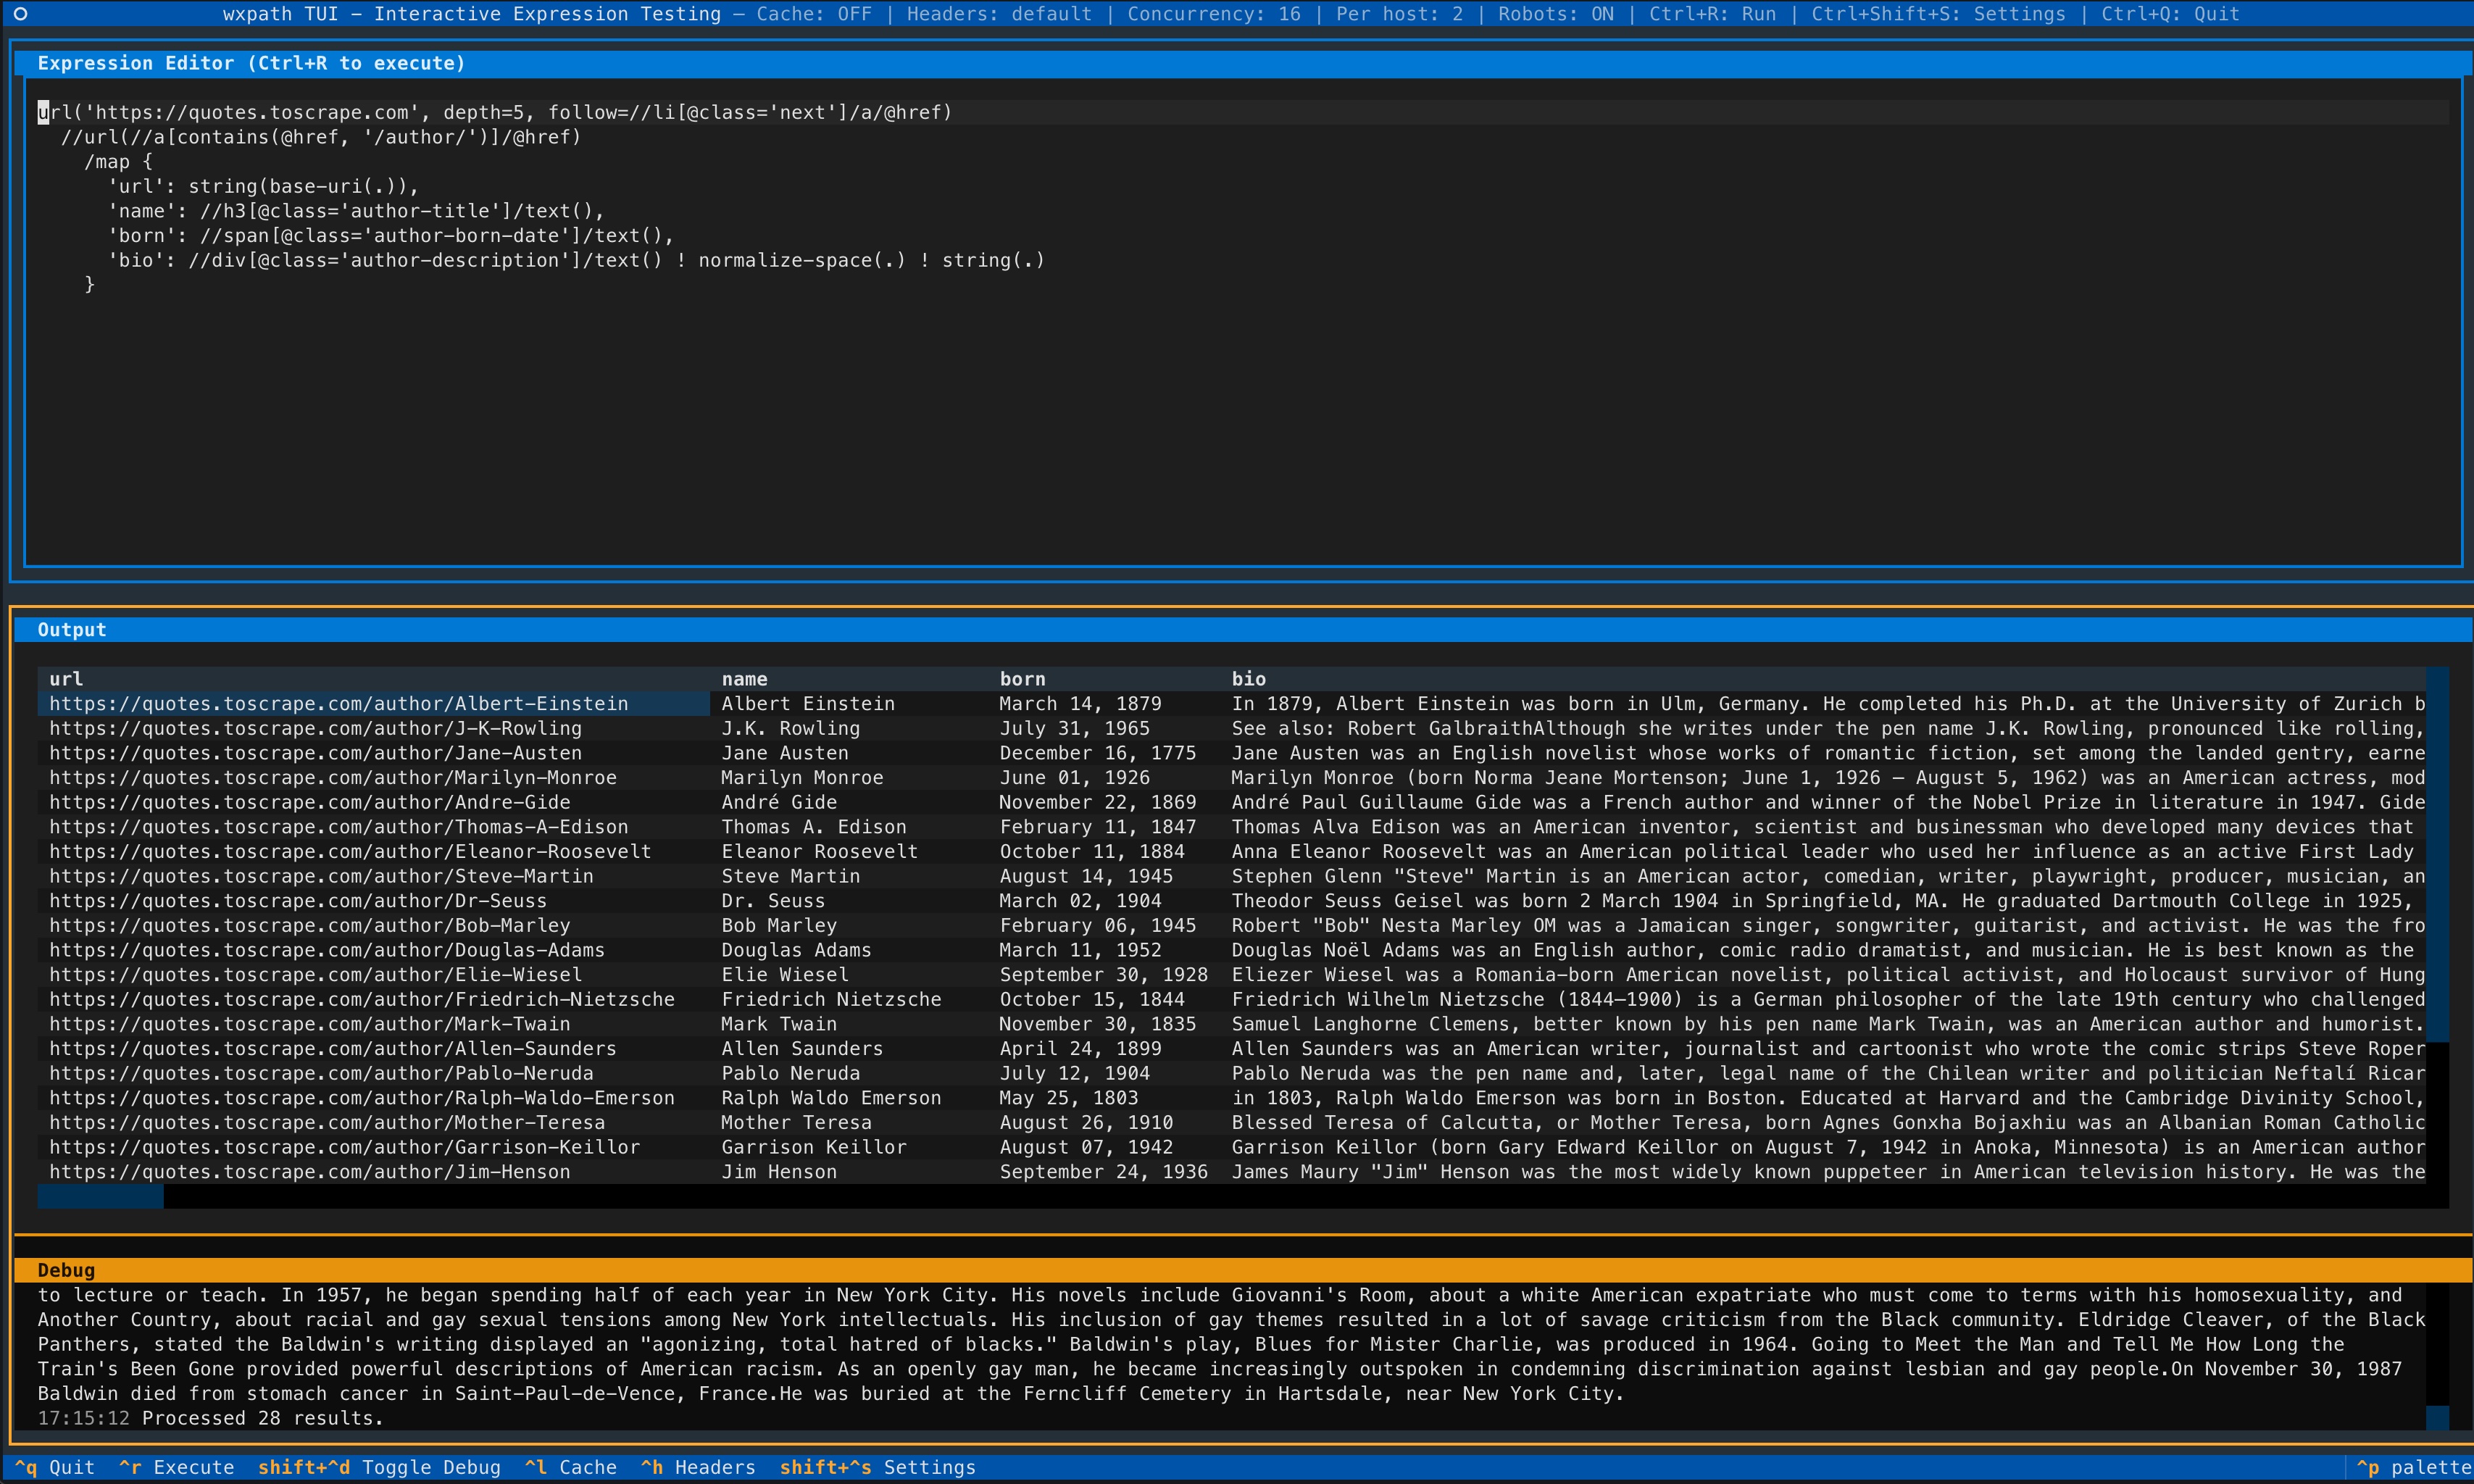
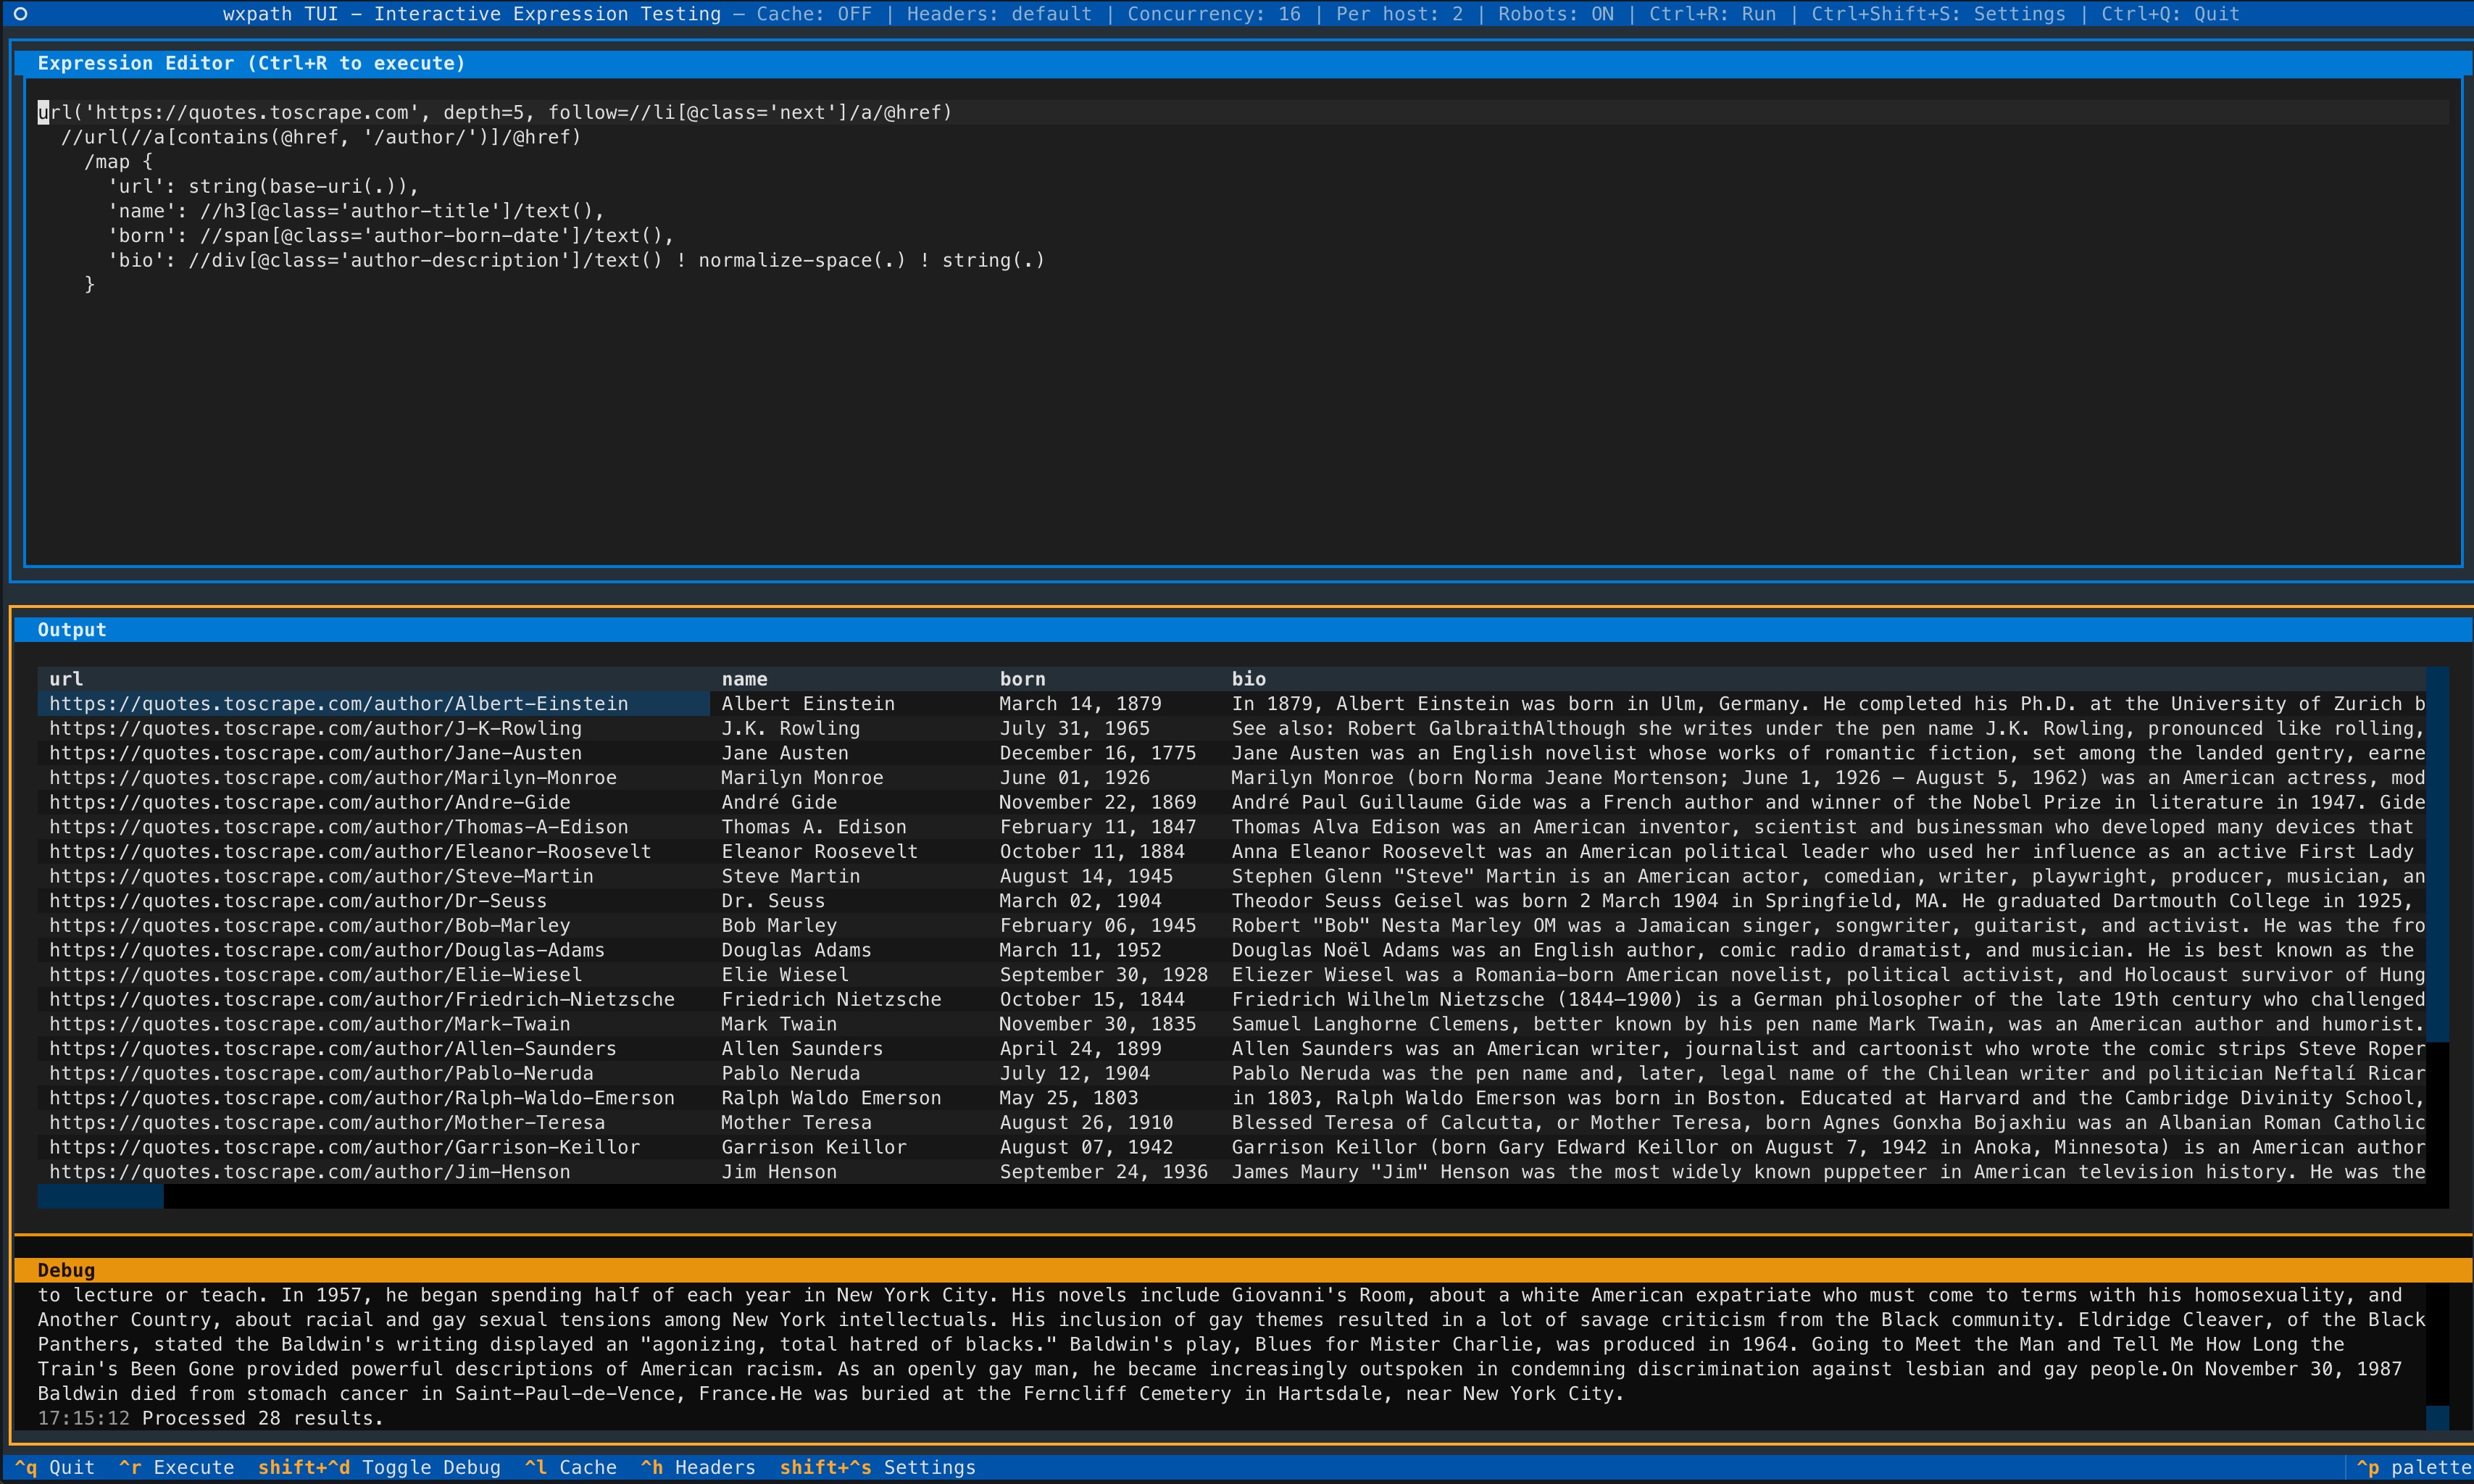
NUEVO: TUI – Interfaz de terminal interactiva (impulsada por Textual) para probar expresiones wxpath y exportar datos.
Requiere Python 3.10+.
pip install wxpath
# For TUI support:
pip install "wxpath[tui]"
# Immediately launch the TUI via uv:
uvx --from "wxpath[tui]" wxpath-tui
wxpath es un rastreador web declarativo donde el recorrido se expresa directamente en XPath. En lugar de escribir bucles de rastreo imperativos, wxpath te permite describir qué seguir y qué extraer en una sola expresión. wxpath ejecuta esa expresión de forma concurrente, en un orden similar a primero en anchura, y transmite los resultados a medida que se descubren.
Esta expresión obtiene una página, extrae enlaces y los transmite concurrentemente, sin necesidad de un bucle de rastreo:
import wxpath

expr = "url('https://quotes.toscrape.com')//a/@href"

for link in wxpath.wxpath_async_blocking_iter(expr):
    print(link)
Al introducir el operador url(...) y la sintaxis ///, el motor de wxpath puede realizar rastreo y extracción web recursivos (o paginados):
import wxpath

path_expr = """
url('https://quotes.toscrape.com')
  ///url(//a/@href)
    //a/@href
"""

for item in wxpath.wxpath_async_blocking_iter(path_expr, max_depth=1):
    print(item)
La mayoría de los raspadores web te obligan a escribir primero el flujo de control del rastreo y luego la extracción.
wxpath unifica esos dos pasos en uno:
Extrae jerarquías JSON limpias y estructuradas directamente del grafo: alimenta tus LLMs con señal, no con ruido. Consulta Integración con LangChain para más detalles.
wxpath es determinista (léase: no impulsado por LLMs). Aunque no podemos garantizar que la red sea estable, podemos garantizar que el recorrido lo es.
La documentación ya está disponible aquí.
url(...) y ///url(...) explicadosimport wxpath
from wxpath.settings import CRAWLER_SETTINGS
# Custom headers for politeness; necessary for some sites (e.g., Wikipedia)
CRAWLER_SETTINGS.headers = {'User-Agent': 'my-app/0.4.0 (contact: [email protected])'}
# Crawl, extract fields, build a knowledge graph
path_expr = """
url('https://en.wikipedia.org/wiki/Expression_language')
///url(
//main//a/@href[
starts-with(., '/wiki/') and not(contains(., ':'))
]
)
/map{
'title': (//span[contains(@class, "mw-page-title-main")]/text())[1] ! string(.),
'url': string(base-uri(.)),
'short_description': //div[contains(@class, 'shortdescription')]/text() ! string(.),
'forward_links': //div[@id="mw-content-text"]//a/@href ! string(.)
}
"""
for item in wxpath.wxpath_async_blocking_iter(path_expr, max_depth=1):
print(item)
Nota: Algunos sitios (incluyendo Wikipedia) pueden bloquear solicitudes sin las cabeceras adecuadas.
Consulta Avanzado: Configuración del motor y rastreador para establecer un User-Agent personalizado.
La expresión anterior hace lo siguiente:
https://en.wikipedia.org/wiki/Expression_language.<main> que empiezan con /wiki/ y no contienen dos puntos (:).url(...) y ///url(...) explicadosurl(...) es un operador personalizado que obtiene el contenido de la URL especificada por el usuario o generada internamente y lo devuelve como un lxml.html.HtmlElement para su posterior procesamiento con XPath.///url(...) indica un rastreo profundo. Le dice al motor que continúe siguiendo enlaces hasta el max_depth especificado. A diferencia de saltos repetidos con url(), permite que una sola expresión describa una exploración más profunda del grafo. ADVERTENCIA: Úsalo con cuidado y con restricciones (mediante max_depth o predicados XPath) para evitar explosión del recorrido.Consulta DESIGN.md para más detalles sobre el diseño del lenguaje. Allí verás los conceptos centrales y el diseño del lenguaje desde cero.
wxpath evalúa una expresión como una lista de pasos de recorrido y extracción (internamente llamados Segment).
url(...) crea tareas de rastreo, ya sea estáticamente (mediante una URL fija) o dinámicamente (mediante una URL derivada de la expresión XPath). Las URLs se deduplican globalmente, con el mejor esfuerzo, no por profundidad.
Los segmentos XPath operan sobre documentos obtenidos (a través de las operaciones url(...) inmediatamente anteriores).
///url(...) indica rastreo profundo: procede en orden similar a primero en anchura hasta max_depth.
Los resultados se entregan tan pronto como están listos.
wxpath es ante todo asyncio/aiohttp, proporcionando una API asíncrona para rastrear y extraer datos.
import asyncio
from wxpath import wxpath_async

items = []

async def main():
    path_expr = "url('https://en.wikipedia.org/wiki/Expression_language')///url(//@href[starts-with(., '/wiki/')])//a/@href"
    async for item in wxpath_async(path_expr, max_depth=1):
        items.append(item)

asyncio.run(main())
wxpath también proporciona una API asíncrona-dentro-de-síncrona, que permite rastrear varias páginas concurrentemente manteniendo la simplicidad del código síncrono. Esto es especialmente útil para rastreos en entornos estrictamente síncronos (es decir, fuera de un bucle de eventos asyncio) donde el rendimiento es importante.
from wxpath import wxpath_async_blocking_iter
