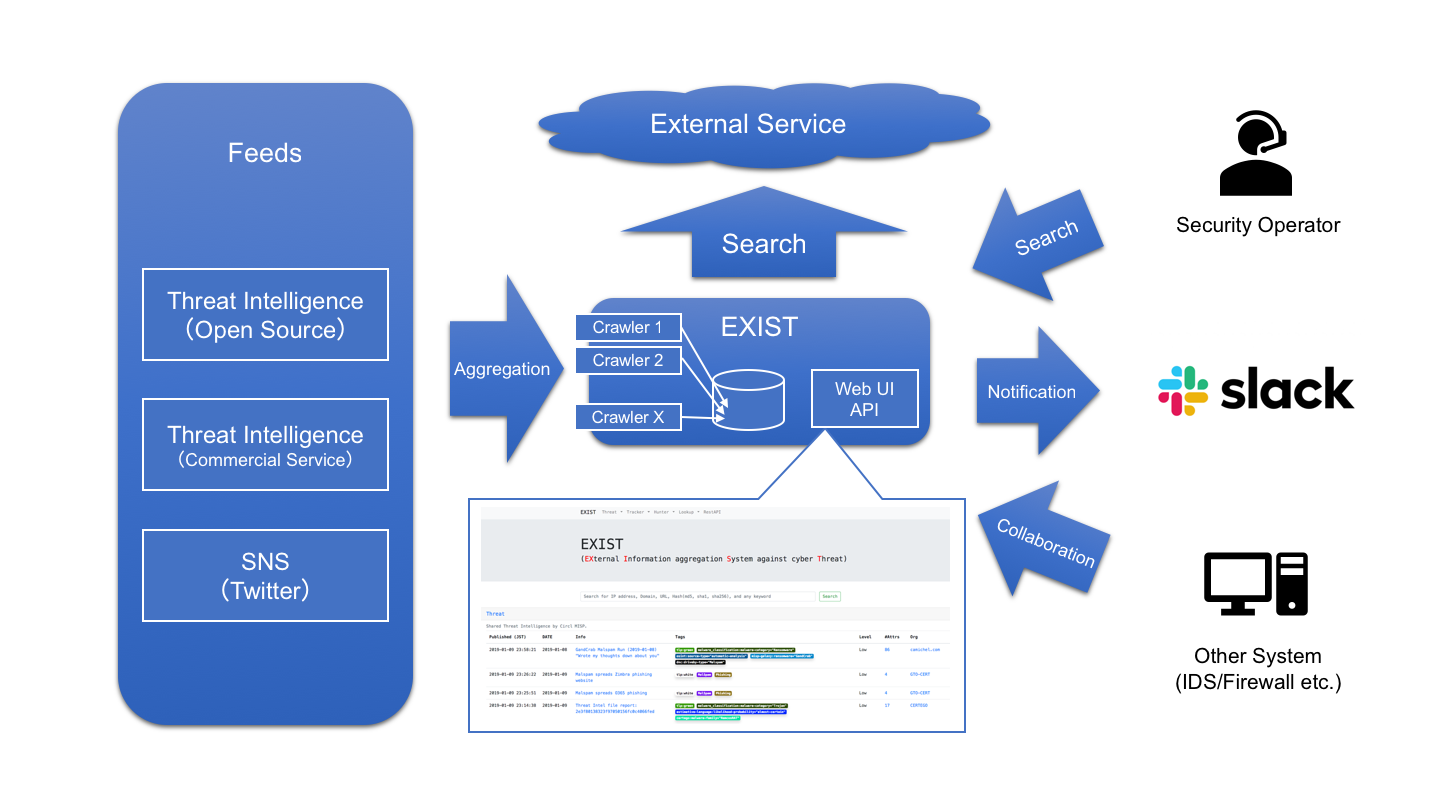

EXIST es una aplicación web para agregar y analizar inteligencia de amenazas cibernéticas.
⚠️ Este repositorio no tiene mantenimiento / está archivado. Los problemas de seguridad no se corregirán.
EXIST es una aplicación web para agregar y analizar CTI (inteligencia de amenazas cibernéticas).
EXIST está escrito con el siguiente software.
EXIST es una aplicación web para agregar CTI que ayuda a los operadores de seguridad a investigar incidentes basados en indicadores relacionados.
EXIST obtiene automáticamente datos de varios servicios de CTI y Twitter a través de sus API y fuentes. Puede realizar búsquedas cruzadas de indicadores a través de la interfaz web y la API.
Si tiene servidores que registran comportamientos de red de clientes (por ejemplo, registros de servidores DNS y proxy HTTP, etc.), podrá analizar los registros correlacionándolos con los datos de EXIST. Si implementa algunos programas usando la API, logrará un centro de operaciones de seguridad automatizado impulsado por CTI.
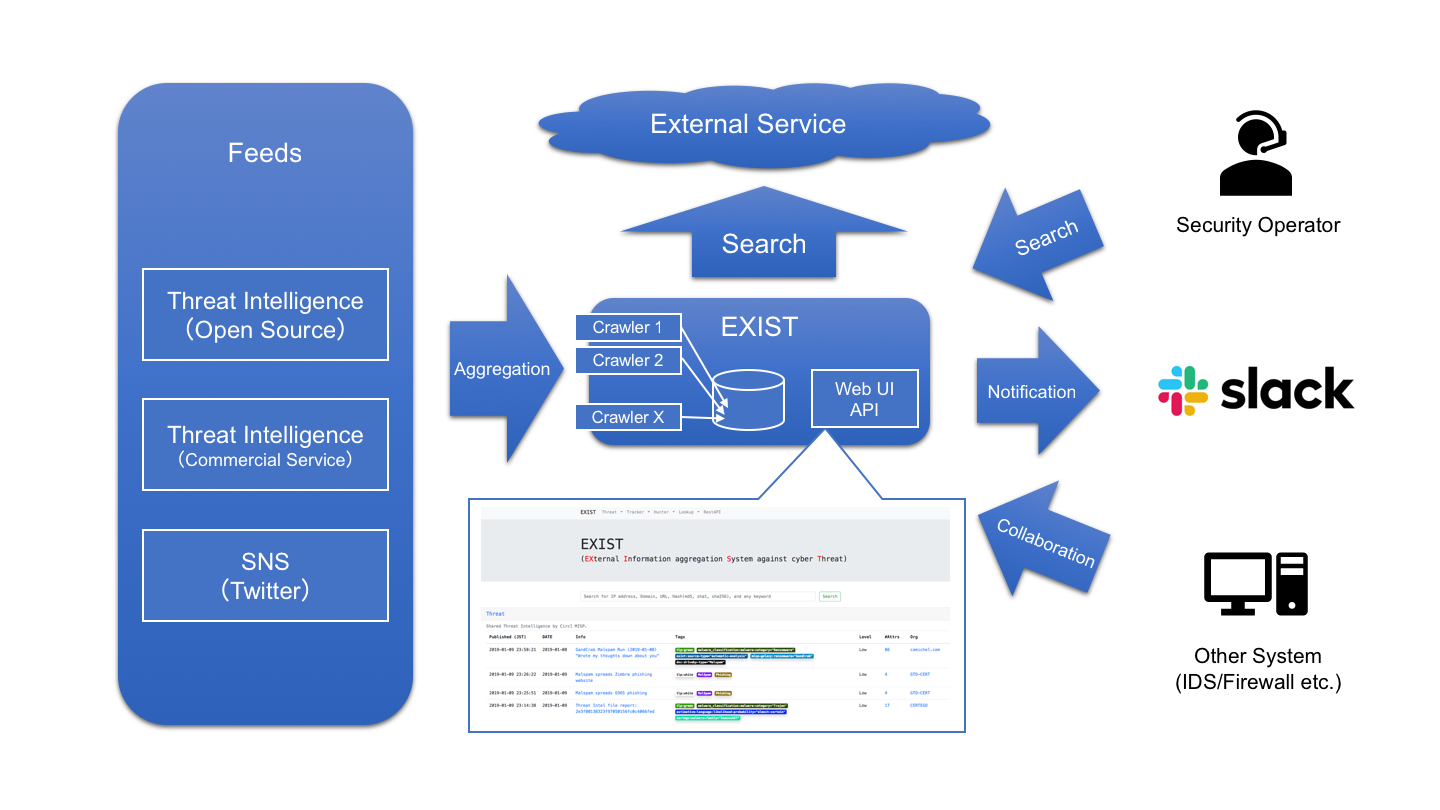
Simplemente escriba el dominio en el formulario de búsqueda.
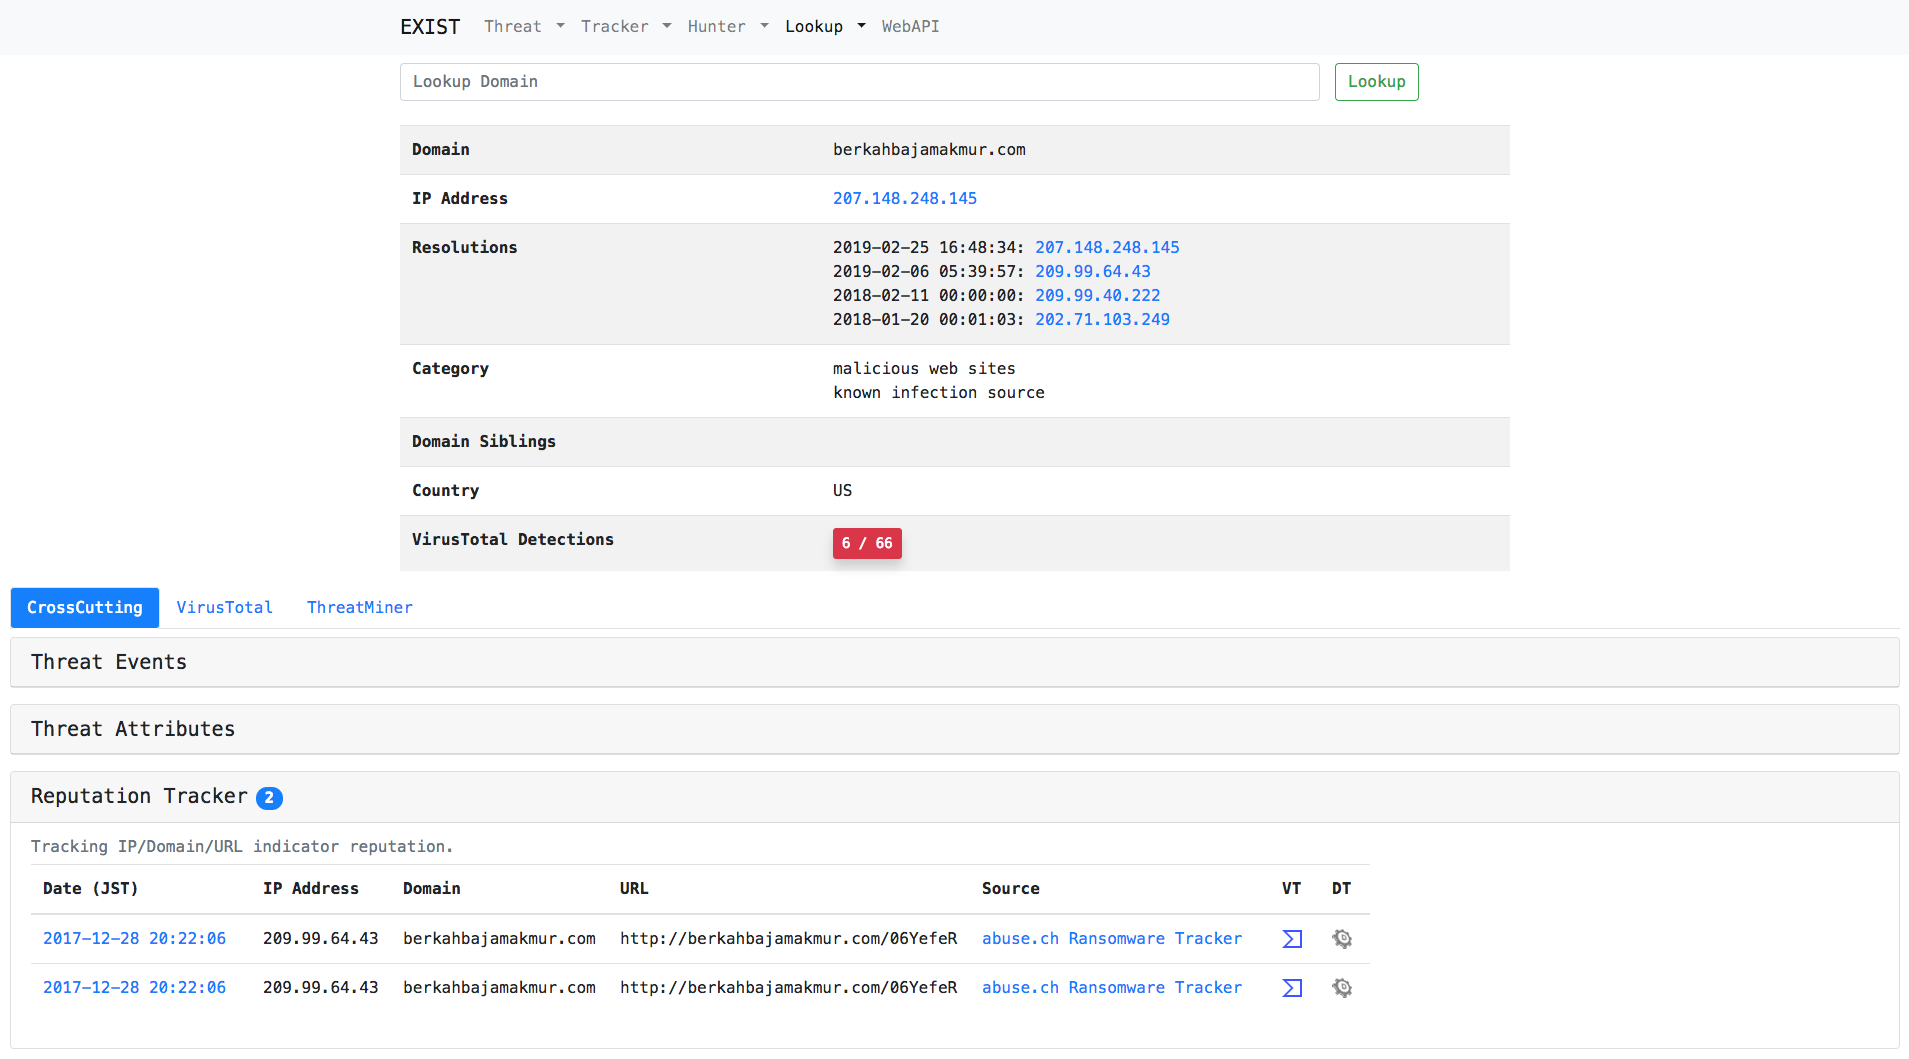
Simplemente escriba la URL en el formulario de búsqueda.
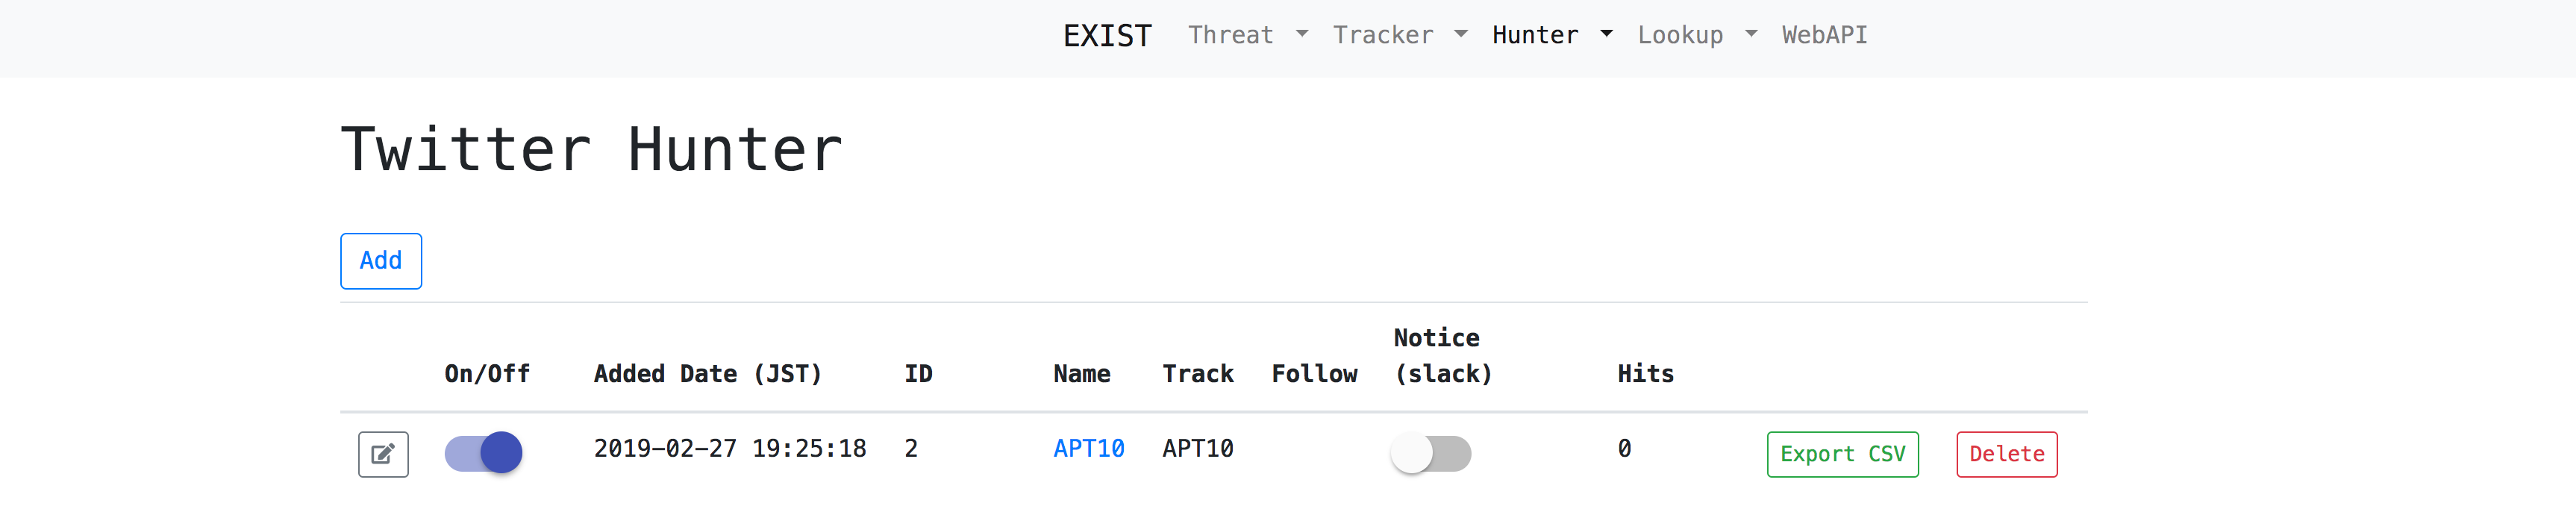
Simplemente agregue palabras clave en Threat Hunter o Twitter Hunter.
Tracker recopila automáticamente fuentes de datos de varios servicios de CTI.
Hunter nos permite establecer consultas para recopilar datos de varios servicios de CTI y Twitter.
Lookup recupera información relacionada con información específica (por ejemplo, dirección IP, dominio) de varios servicios de Internet (por ejemplo, whois).
Una herramienta para anotar tweets del rastreador de Twitter.
Proporciona datos almacenados en la base de datos de EXIST a través de Web API.
A partir de aquí asumo el entorno de CentOS 7 o Ubuntu 18.04 LTS. Tenga cuidado al implementar en otro entorno.
$ sudo pip install -r requirements.txt
$ curl -sS https://downloads.mariadb.com/MariaDB/mariadb_repo_setup | sudo bash
$ sudo yum install MariaDB-server MariaDB-client
$ sudo apt install mariadb-server mariadb-client
$ sudo systemctl start mariadb
$ sudo systemctl enable mariadb
.env tomando como referencia .env.example. Y edítelo según la configuración de su base de datos.La clave secreta para Django debe escribirse en el archivo .env.
Primero, ejecute el generador de claves:
$ python keygen.py
(ejemplo)> 70mm6h)()h3r&*b9xq$e52=-7($p=5983gfoyz%$d-j-gd7u5@
y escriba la clave secreta en el archivo .env:
...
# Configuración de la aplicación EXIST
EXIST_SECRET_KEY="70mm6h)()h3r&*b9xq$e52=-7($p=5983gfoyz%$d-j-gd7u5@"
...
$ python manage.py makemigrations exploit reputation threat threat_hunter twitter twitter_hunter news news_hunter vuln
$ python manage.py migrate
Reputation tracker utiliza Redis como backend de caché de Celery.
$ sudo yum install redis
$ sudo systemctl start redis
$ sudo systemctl enable redis
$ sudo apt install redis-server
$ sudo systemctl start redis-server
$ sudo systemctl enable redis-server
Reputation tracker utiliza Celery como cola de trabajos asíncronos.
# Nombre de los nodos a iniciar
# aquí tenemos un solo nodo
CELERYD_NODES="w1"
# o podríamos tener tres nodos:
#CELERYD_NODES="w1 w2 w3"

# Ruta absoluta o relativa al comando 'celery':
CELERY_BIN="/ruta/a/tu/celery"

# Instancia de la aplicación a usar
# comente esta línea si no usa una aplicación
CELERY_APP="intelligence"
# o totalmente calificada:
#CELERY_APP="proj.tasks:app"

# Cómo llamar a manage.py
CELERYD_MULTI="multi"

# Argumentos adicionales de línea de comandos para el worker
CELERYD_OPTS="--time-limit=300 --concurrency=8"

# - %n será reemplazado con la primera parte del nombre del nodo.
# - %I será reemplazado con el índice del proceso hijo actual
# y es importante al usar el pool prefork para evitar condiciones de carrera.
CELERYD_PID_FILE="/var/run/celery/%n.pid"
CELERYD_LOG_FILE="/var/log/celery/%n%I.log"
CELERYD_LOG_LEVEL="INFO"
/etc/systemd/system/celery.service. Además, debe establecer la ruta de su configuración de Celery en EnvironmentFile.[Unit]
Description=Servicio de Celery
After=network.target
[Service]
Type=forking
User=SU_USUARIO
Group=SU_GRUPO
EnvironmentFile=/etc/sysconfig/celery
WorkingDirectory=/ruta/a/tu/exist
ExecStart=/bin/sh -c '${CELERY_BIN} multi start ${CELERYD_NODES} \
-A ${CELERY_APP} --pidfile=${CELERYD_PID_FILE} \
--logfile=${CELERYD_LOG_FILE} --loglevel=${CELERYD_LOG_LEVEL} ${CELERYD_OPTS}'
ExecStop=/bin/sh -c '${CELERY_BIN} multi stopwait ${CELERYD_NODES} \
--pidfile=${CELERYD_PID_FILE}'
ExecReload=/bin/sh -c '${CELERY_BIN} multi restart ${CELERYD_NODES} \
-A ${CELERY_APP} --pidfile=${CELERYD_PID_FILE} \
--logfile=${CELERYD_LOG_FILE} --loglevel=${CELERYD_LOG_LEVEL} ${CELERYD_OPTS}'
[Install]
WantedBy=multi-user.target
$ sudo mkdir /var/log/celery; sudo chown SU_USUARIO:SU_GRUPO /var/log/celery
$ sudo mkdir /var/run/celery; sudo chown SU_USUARIO:SU_GRUPO /var/run/celery
#Tipo  Ruta               Modo  UID        GID         Edad  Argumento
d      /var/run/celery    0755  SU_USUARIO  SU_GRUPO  -
$ sudo systemctl start celery.service
$ sudo systemctl enable celery.service
$ python manage.py runserver 0.0.0.0:8000
Nota: Recomiendo usar Nginx y uWSGI en entornos de producción.
Los scripts para insertar fuentes de datos en la base de datos están en scripts/insert2db/*/insert2db.py.

