
 jev-sec/jev-ids
Sistema de Detección de Intrusiones (IDS) ultrarrápido y de tokens eficientes basado en Jev de TypeSafe.


Detección de intrusiones en una sola petición. Muestra a Jev de TypeSafe un flujo de red y cinco ejemplos etiquetados. Responde si el flujo es un ataque y de qué tipo, en medio segundo, sin texto que analizar.
Jev IDS se probó sobre NSL-KDD, un benchmark de referencia de la comunidad de ciberseguridad, frente a un LLM de última generación (Gemini 3.6 Flash en Vertex AI), un modelo clásico de machine learning (Random Forest) y uno no supervisado (Isolation Forest): 2.000 flujos, tres semillas, k de 0 a 8 ejemplos por categoría. Con los mismos cinco ejemplos (k = 1), Jev IDS fue:
El LLM es el mejor detector en F1: 0,880 frente al 0,856 de Jev con k = 1, y va por delante en todos los k (McNemar p < 0,001), porque captura más ataques de los tipos mostrados en los ejemplos. Jev es el segundo mejor, y en ataques zero-day, tipos ausentes de los ejemplos, captura más que el LLM desde k = 1 hasta k = 8 (0,747 frente a 0,713 con k = 1). Los números, las figuras y sus límites están en Evidencia y límites y docs/results.md.
Lee el bucle · La plantilla de la petición · Glosario
Jev es un System One Model. En lugar de escribir texto, lee un state y responde a preguntas tipadas sobre él con probabilidades. Jev IDS coloca un flujo en el estado, junto a las instrucciones, los nombres de las columnas, las cinco descripciones de categoría y los ejemplos etiquetados, y hace dos preguntas. is_attack vuelve como una probabilidad. category vuelve como una de cinco opciones con una confianza. El veredicto es ataque cuando la probabilidad alcanza 0,5.
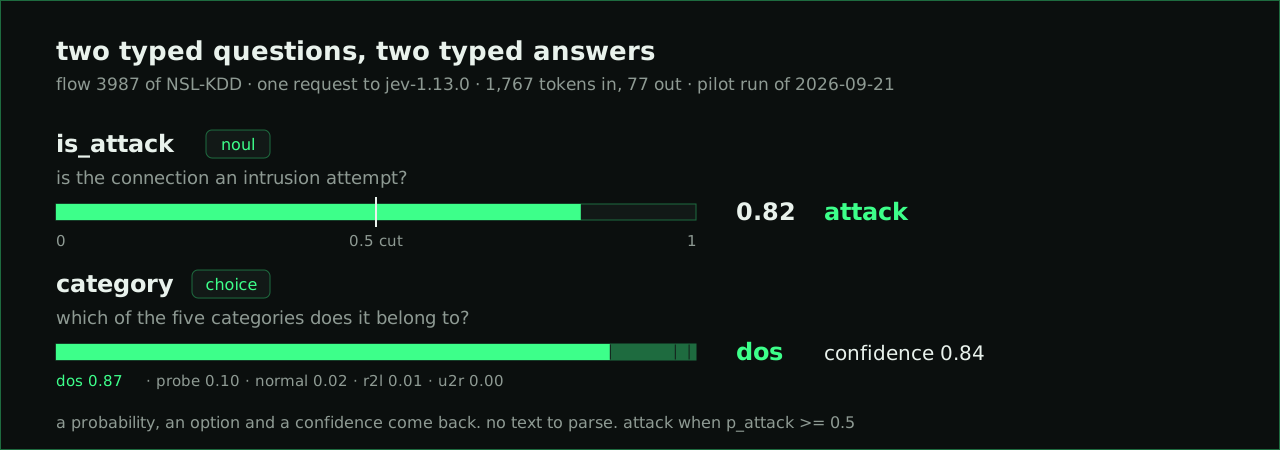
Cada petición sigue el mismo camino:
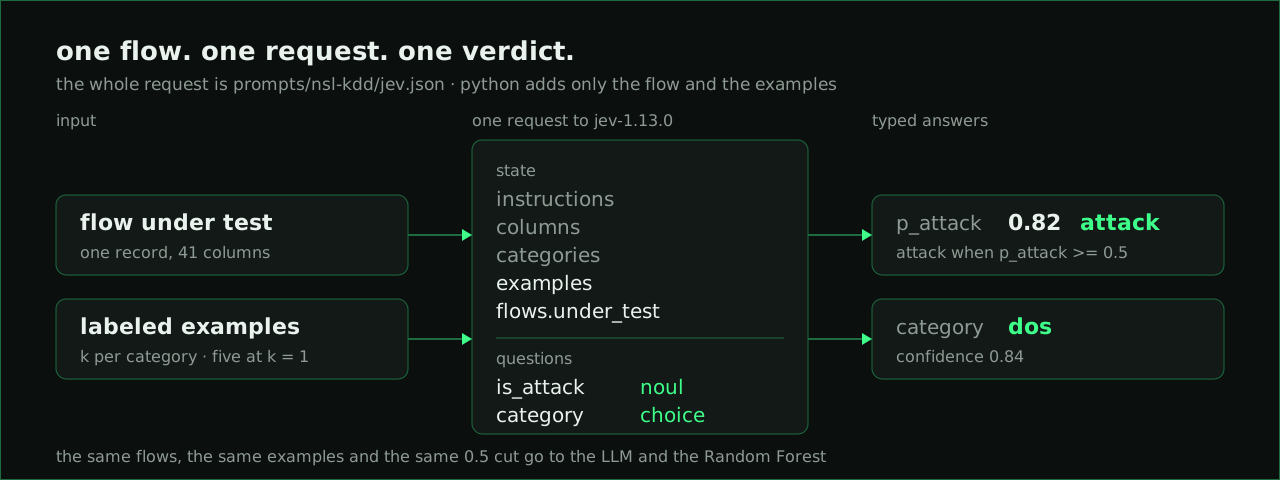
Toda la petición es un solo archivo, prompts/nsl-kdd/jev.json. Python solo añade el flujo y los ejemplos, y el sha256 del archivo viaja en cada fila de predicción como prompt_hash, de modo que las ejecuciones que preguntaron cosas distintas nunca se comparan como iguales. Los ejemplos se etiquetan solo por categoría: los nombres de ataque como neptune nunca llegan a un modelo.
Los mismos flujos, ejemplos y corte de 0,5 se aplican a dos baselines: un LLM a través de un agente Agno con un esquema de salida JSON (Gemini 3.6 Flash mediante Vertex AI en el artículo; GPT-5.6 a través del backend de ChatGPT Codex o DeepSeek como alternativas) y un Random Forest de scikit-learn entrenado con los mismos ejemplos. Un tercer baseline, un Isolation Forest ajustado solo con los flujos benignos del pool, nunca ve un ejemplo: es la referencia no supervisada, solo con k = all.
git clone https://github.com/jev-sec/jev-ids.git
cd jev-ids
uv sync
# .env: TYPESAFE_API_KEY for Jev. Gemini needs `gcloud auth application-default login` and GOOGLE_GENAI_USE_VERTEXAI=true,
# GOOGLE_CLOUD_PROJECT and GOOGLE_CLOUD_LOCATION=global in the environment; DEEPSEEK_API_KEY and CHATGPT_CLIENT_ID only for the other LLMs.
Descarga NSL-KDD en data/raw/nsl-kdd/ y prepáralo una vez:
uv run python -m scripts.prepare_nsl_kdd
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector jev --split smoke --k 0,1
El split smoke son cinco flujos. La ejecución escribe results/<timestamp>-nsl-kdd-jev-smoke/ con config.json, una fila JSON por flujo en predictions.jsonl (el veredicto, la verdad, p_attack, la categoría, la confianza, la latencia y el informe de tokens de la pasarela) y las respuestas en bruto en responses.jsonl.
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector jev --split pilot --k 0,1,2,4,8 --seeds 0,1,2
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector llm:gemini --model gemini-3.6-flash --split pilot --k 0,1,2,4,8
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector random_forest --split pilot --k 1,2,4,8,all
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector isolation_forest --split pilot --k all
uv run jev-ids metrics results/<run_id> [results/<run_id> ...] > results/summary.csv
uv run jev-ids compare --a results/<jev_run> --b results/<rf_run> --subset novel --k-a 0 --k-b all  # novel = zero-day attacks
k es el número de ejemplos etiquetados por categoría. k = 1 con cinco categorías significa cinco ejemplos, y all significa el pool completo. metrics imprime una fila CSV por detector y k con F1, recall en ataques zero-day (novel en el código) y por categoría, PR-AUC y ROC-AUC de p_attack, tokens, latencia y coste. compare empareja dos ejecuciones flujo a flujo y aplica la prueba de McNemar sobre los pares discordantes, porque solo los flujos en los que dos detectores discrepan permiten distinguirlos. El coste se calcula offline como tokens por los precios de tarifa en prices.json, para todos los detectores por igual.
docs/protocol.md fija las entradas (el split paper de 2.000 flujos, los prompts, los ids de modelo, los precios) y make paper ejecuta los cuatro detectores sobre ese split en results/paper/ y escribe results/paper/summary.csv. Cada detector tiene su propio target (make paper-jev, make paper-llm, make paper-random-forest, make paper-isolation-forest), así que pueden ejecutarse en terminales separadas; el LLM es el lento. make paper-llm ejecuta Gemini 3.6 Flash en Vertex AI como cinco procesos en paralelo, uno por k (make -j5 paper-llm); un error de cuota o un timeout es una fila de error, y uv run jev-ids redo-errors results/paper/<run> vuelve a juzgar esos flujos en su sitio. Las tablas y figuras completas están en docs/results.md.

