 jaidedai/easyocr
OCR listo para usar con más de 80 idiomas compatibles y todos los sistemas de escritura populares, incluidos latino, chino, árabe, devanagari, cirílico, etc.


OCR listo para usar con más de 80 idiomas compatibles y todos los sistemas de escritura populares, incluidos: latino, chino, árabe, devanagari, cirílico, etc.
Prueba la demo en nuestro sitio web
Integrado en Huggingface Spaces 🤗 usando Gradio. Prueba la demo web:
24 de septiembre de 2024 - Versión 1.7.2
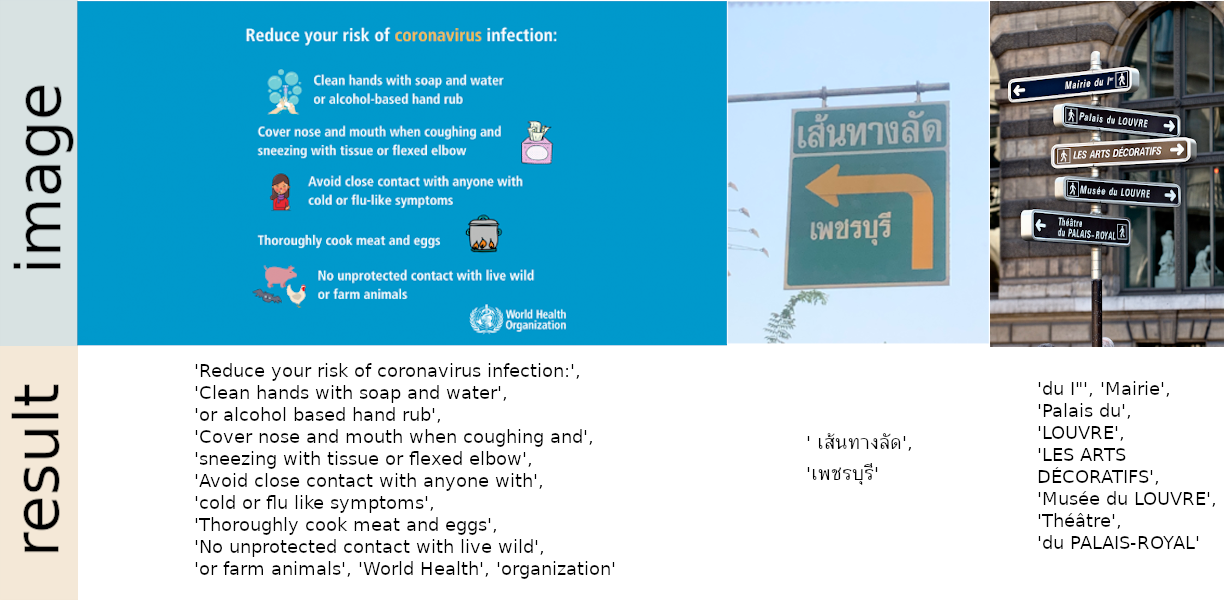
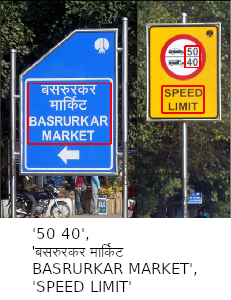
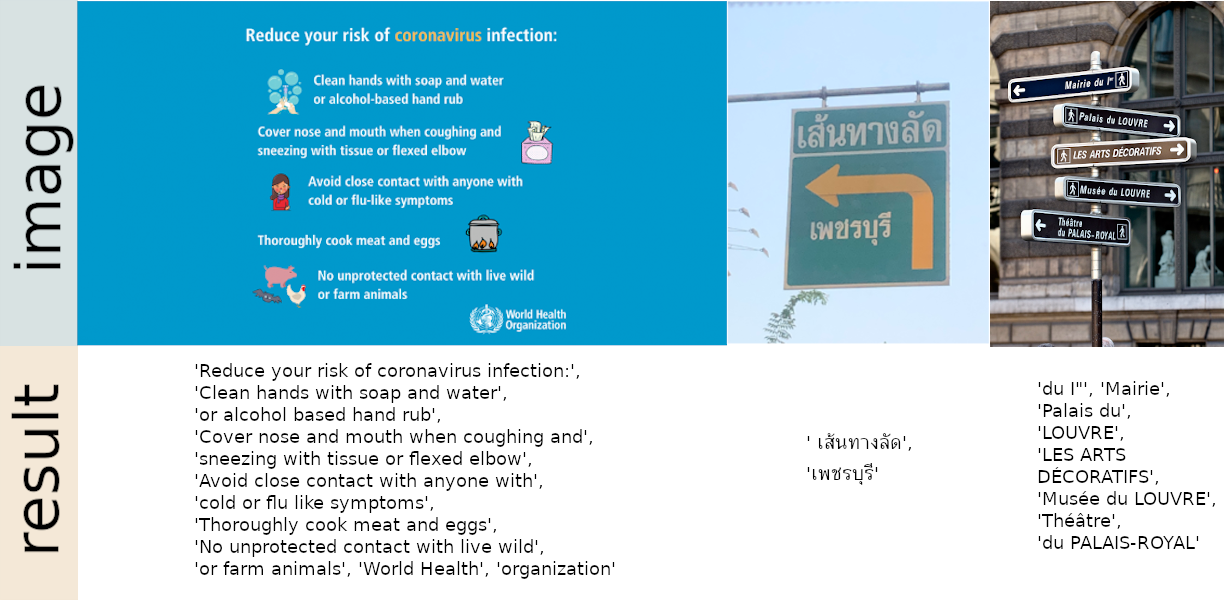
Instalar usando pip
Para la última versión estable:
pip install easyocr
Para la última versión de desarrollo:
pip install git+https://github.com/JaidedAI/EasyOCR.git
Nota 1: Para Windows, instale primero torch y torchvision siguiendo las instrucciones oficiales aquí https://pytorch.org. En el sitio web de pytorch, asegúrese de seleccionar la versión correcta de CUDA que tenga. Si pretende ejecutar solo en modo CPU, seleccione CUDA = None.
Nota 2: También proporcionamos un Dockerfile aquí.
Nota 3: El detector opcional DBNet (detect_network='dbnet18') compila sus operaciones de C++/CUDA en el primer uso, lo que requiere la herramienta de compilación Ninja. Para instalarlo junto con EasyOCR, use pip install "easyocr[dbnet]".
import easyocr
reader = easyocr.Reader(['ch_sim','en']) # this needs to run only once to load the model into memory
result = reader.readtext('chinese.jpg')
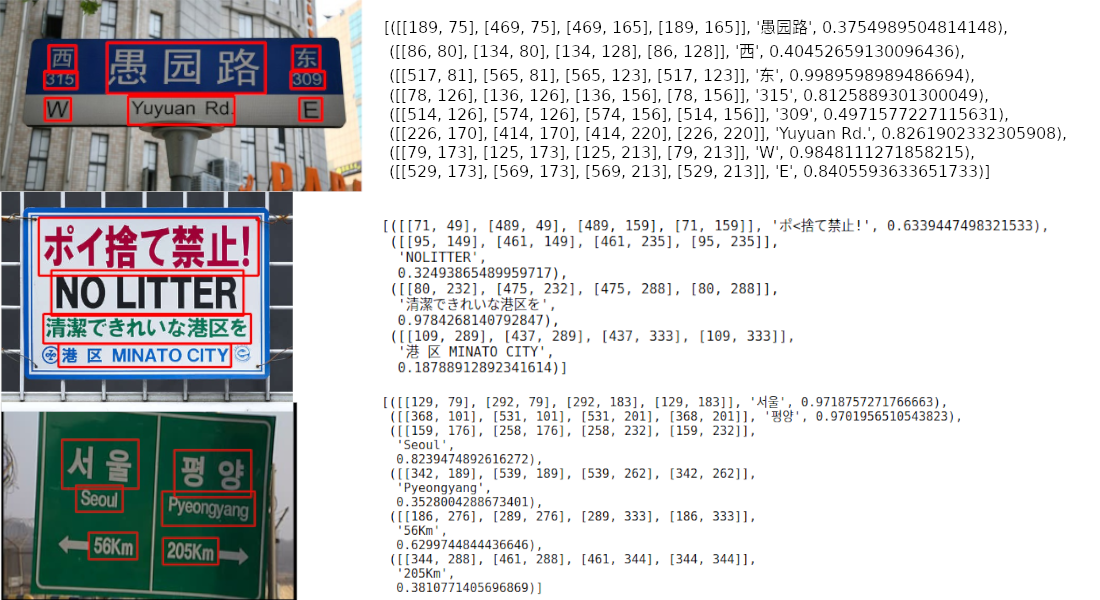
La salida estará en formato de lista; cada elemento representa un cuadro delimitador, el texto detectado y el nivel de confianza, respectivamente.
[([[189, 75], [469, 75], [469, 165], [189, 165]], '愚园路', 0.3754989504814148),
 ([[86, 80], [134, 80], [134, 128], [86, 128]], '西', 0.40452659130096436),
 ([[517, 81], [565, 81], [565, 123], [517, 123]], '东', 0.9989598989486694),
 ([[78, 126], [136, 126], [136, 156], [78, 156]], '315', 0.8125889301300049),
 ([[514, 126], [574, 126], [574, 156], [514, 156]], '309', 0.4971577227115631),
 ([[226, 170], [414, 170], [414, 220], [226, 220]], 'Yuyuan Rd.', 0.8261902332305908),
 ([[79, 173], [125, 173], [125, 213], [79, 213]], 'W', 0.9848111271858215),
 ([[529, 173], [569, 173], [569, 213], [529, 213]], 'E', 0.8405593633651733)]
Nota 1: ['ch_sim','en'] es la lista de idiomas que deseas leer. Puedes pasar
varios idiomas a la vez, pero no todos los idiomas pueden usarse juntos.
El inglés es compatible con todos los idiomas y los idiomas que comparten caracteres comunes suelen ser compatibles entre sí.
Nota 2: En lugar de la ruta de archivo chinese.jpg, también puedes pasar un objeto de imagen de OpenCV (array de numpy) o un archivo de imagen como bytes. También es aceptable una URL a una imagen sin procesar.
Nota 3: La línea reader = easyocr.Reader(['ch_sim','en']) sirve para cargar un modelo en memoria. Tarda algún tiempo, pero solo es necesario ejecutarla una vez.
También puedes establecer detail=0 para una salida más simple.
reader.readtext('chinese.jpg', detail = 0)
Resultado:
['愚园路', '西', '东', '315', '309', 'Yuyuan Rd.', 'W', 'E']
Los pesos del modelo para el idioma elegido se descargarán automáticamente o puedes descargarlos manualmente desde el model hub y colocarlos en la carpeta '~/.EasyOCR/model'
En caso de que no tengas una GPU, o tu GPU tenga poca memoria, puedes ejecutar el modelo en modo solo CPU añadiendo gpu=False.
reader = easyocr.Reader(['ch_sim','en'], gpu=False)
Para obtener más información, lea el tutorial y la Documentación de la API.
$ easyocr -l ch_sim en -f chinese.jpg --detail=1 --gpu=True
Para el modelo de reconocimiento, Lee aquí.
Para el modelo de detección (CRAFT), Lee aquí.
reader = easyocr.Reader(['en'], detection='DB', recognition = 'Transformer')
La idea es poder conectar cualquier modelo de última generación en EasyOCR. Hay muchos genios intentando crear mejores modelos de detección/reconocimiento, pero nosotros no pretendemos ser genios aquí. Solo queremos que sus trabajos sean rápidamente accesibles al público... de forma gratuita. (bueno, creemos que la mayoría de los genios quieren que su trabajo genere un impacto positivo lo más rápido/grande posible) El pipeline debería ser algo como el diagrama siguiente. Las ranuras grises son marcadores de posición para módulos azul claro intercambiables.
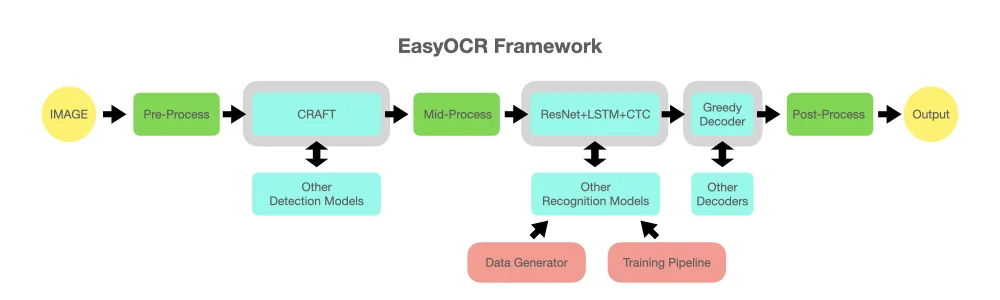
Este proyecto se basa en la investigación y el código de varios artículos y repositorios de código abierto.
Toda la ejecución de aprendizaje profundo se basa en Pytorch. ❤️
La ejecución de la detección utiliza el algoritmo CRAFT de este repositorio oficial y su artículo (Gracias a @YoungminBaek de @clovaai). También utilizamos su modelo preentrenado. El script de entrenamiento es proporcionado por @gmuffiness.

