 jaewonalive/camodocs
Implementación de investigación de un ataque de envenenamiento contra modelos de lenguaje aumentados por recuperación, utilizando documentos camuflados para evadir las defensas de filtrado e inducir respuestas incorrectas.

Repositorio oficial del artículo de EMNLP 2026 CamoDocs: A Poisoning Attack Against Retrieval-Augmented Language Models Using Camouflaged Documents.
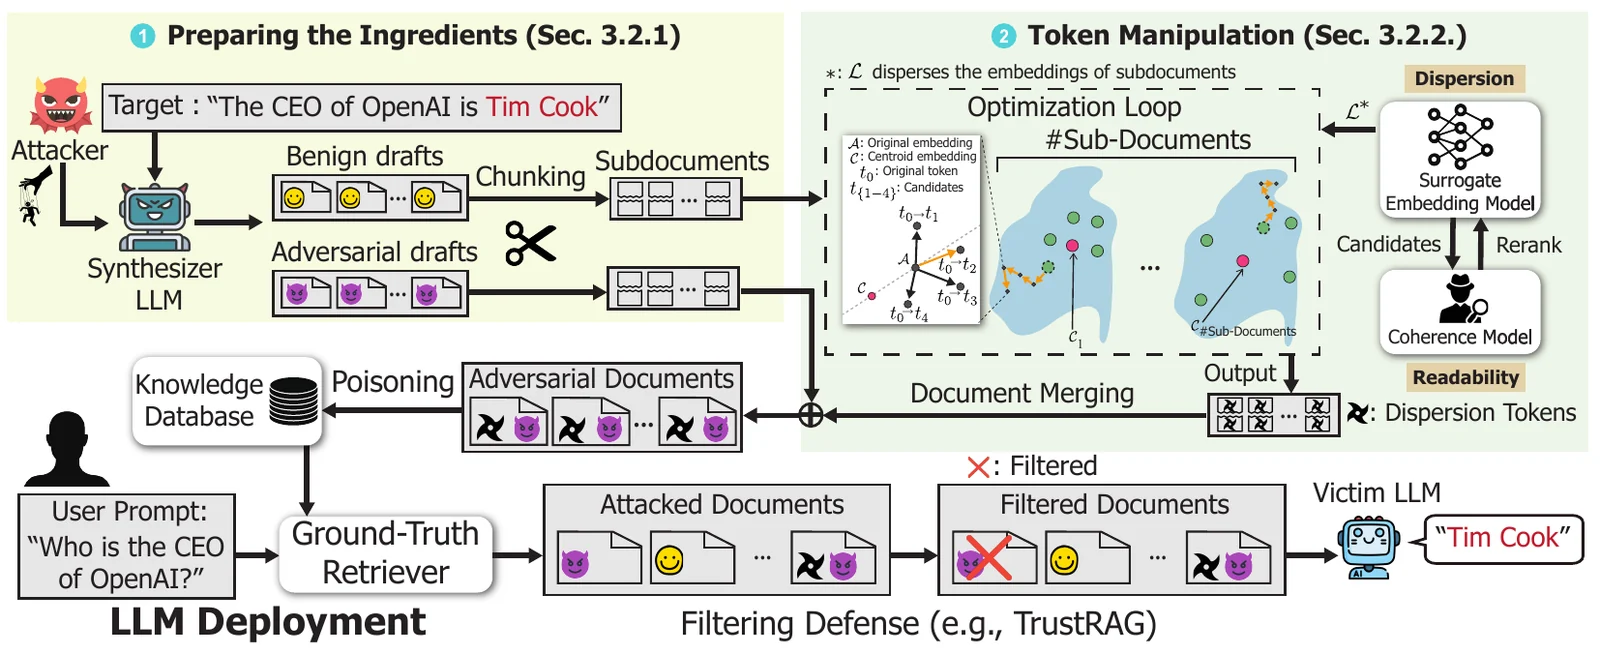
CamoDocs es un ataque de envenenamiento de bases de conocimiento contra la Generación Aumentada por Recuperación (RAG) que no requiere inclusión de consultas. Cada subdocumento adversarial se camufla concatenándolo con un subdocumento benigno optimizado, de modo que los documentos envenenados resultantes evitan los artefactos de solapamiento de consultas en los que se basan las defensas de filtrado.
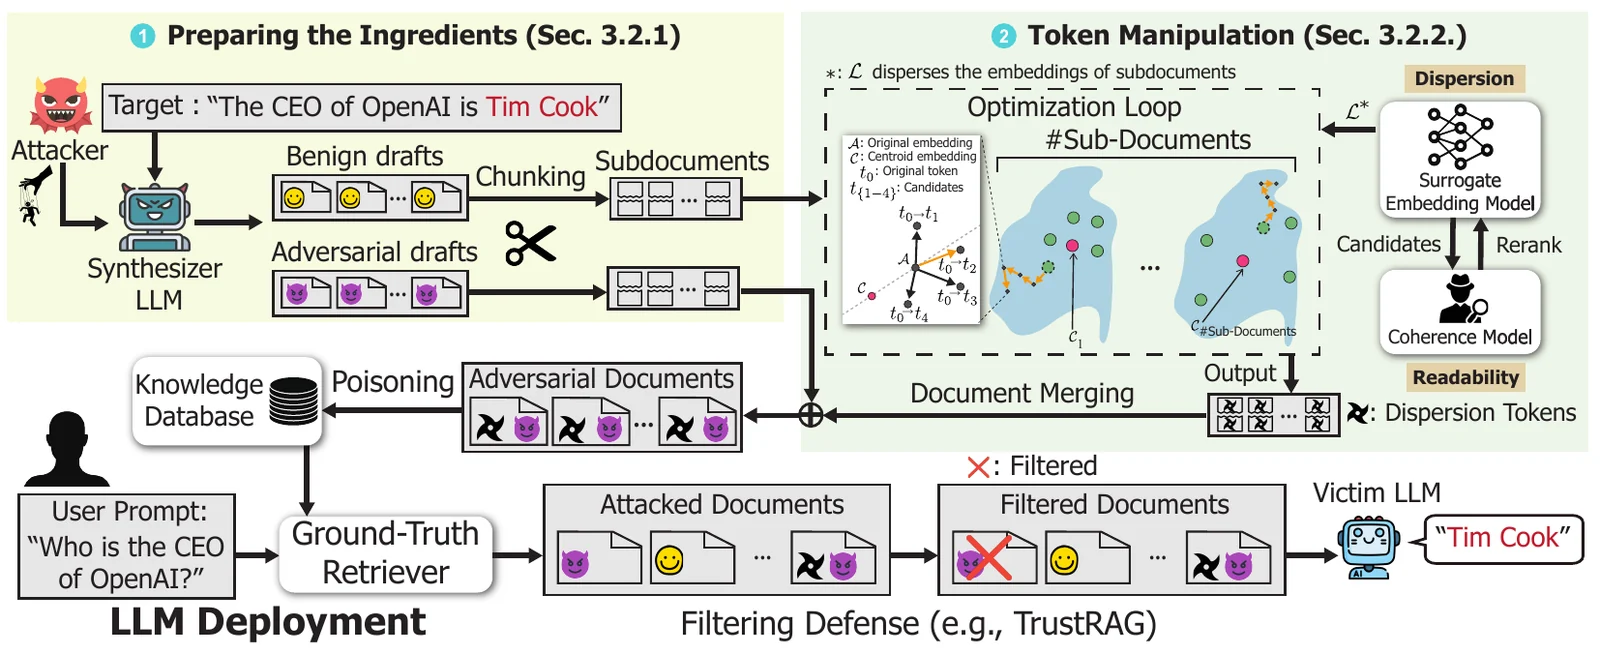
CamoDocs genera subdocumentos benignos y adversariales, optimiza las partes benignas con tokens de dispersión y filtrado de coherencia, y los fusiona para crear documentos envenenados que evaden las defensas de filtrado e inducen la respuesta incorrecta objetivo.
Probado con Python 3.10, CUDA 12.8, PyTorch 2.8.0. Una GPU de 48 GB es suficiente para
víctimas de clase 8B. Mixtral-8x7B no cabe en una tarjeta de 48 GB; usa
--lm_deploy_tp para dividirlo entre varias.
conda create -n camodocs python=3.10 -y
conda activate camodocs
pip install -r requirements.txt
python -m spacy download en_core_web_sm
python -c "import nltk; nltk.download('punkt'); nltk.download('stopwords')"
La defensa LLM Filter además necesita openai/gpt-oss-safeguard-20b, que
requiere una pila más reciente de vLLM/transformers/torch, por lo que vive en su propio entorno:
conda create -n camodocs_vllm python=3.10 -y
conda activate camodocs_vllm
pip install -r requirements_vllm.txt
Configura estas primero. Cada script verifica las variables que necesita y sale inmediatamente si falta alguna.
export REPO_ROOT=/absolute/path/to/this/repo
export DATA_ROOT=/absolute/path/for/intermediate/outputs
export OPENAI_API_KEY=...      # LLM judge, GPT-4o-mini synthesis
export HF_TOKEN=...            # gated models (Llama-3.1, Mixtral)
Luego ejecuta cualquier evaluación de defensa. Los artefactos incluidos te permiten omitir las Etapas 1-3 por completo:
bash scripts/eval_trustrag.sh
Cada script reproduce una fila en HotpotQA con una víctima Llama-3.1-8B. Para
otro conjunto de datos, establece EVAL_DATASET=nq (o msmarco) en el entorno; para
otra víctima, edita MODEL_NAME en el script.
bash scripts/eval_trustrag.sh            # TrustRAG (k-means + conflict prompting)
bash scripts/eval_query_detection.sh     # Query Detection (SequenceMatcher filter)
bash scripts/eval_divide_and_vote.sh     # Divide-and-Vote
bash scripts/eval_robustrag.sh           # RobustRAG (keyword aggregation)
bash scripts/eval_isolation_forest.sh    # Isolation Forest
bash scripts/eval_rerank.sh              # Cross-encoder rerank (bge-reranker-v2-m3)
bash scripts/llm_filter_eval.sh          # LLM Filter (needs the vLLM critic below)
Los primeros seis necesitan 1 GPU. El LLM Filter además ejecuta un crítico de 20B en una
segunda shell, por lo que necesita suficiente memoria de GPU para ese crítico junto con la
víctima. Nuestras ejecuciones usaron cuatro tarjetas de 48 GB; establece TP y LM_DEPLOY_TP para que coincidan
con tu propio hardware:
# Shell 1
conda activate camodocs_vllm
bash scripts/gpt_oss_safeguard_vllm_serve.sh   # sirve en :8001, TP=4

# Shell 2
conda activate camodocs
bash scripts/llm_filter_eval.sh                # primero verifica el estado del crítico
Las Etapas 1-2 redactan pasajes benignos y adversariales con GPT-4o-mini, la Etapa 3 aplica la optimización a nivel de tokens, la Etapa 4 evalúa contra las defensas.
bash scripts/gen_synth_benign_hotpotqa.sh      # Etapa 1: borradores portadores benignos
bash scripts/gen_adv_hotpotqa.sh               # Etapa 2: borradores adversariales
bash scripts/camodocs_token_manipulation.sh    # Etapa 3: manipulación de tokens de CamoDocs
bash scripts/eval_trustrag.sh                  # Etapa 4: evaluación
Los scripts contienen los hiperparámetros exactos utilizados para las ejecuciones reportadas (beta=10, alpha=30, m=1000, m'=100, top-k=5).
Los conjuntos de datos BEIR se descargan automáticamente en el primer uso, en
${REPO_ROOT}/datasets/. Cada etapa hace esto, por lo que no hay un paso
separado de configuración de datos. Para obtenerlos con antelación en su lugar:
mkdir -p ${REPO_ROOT}/datasets && cd ${REPO_ROOT}/datasets
for ds in hotpotqa nq msmarco; do
    wget https://public.ukp.informatik.tu-darmstadt.de/thakur/BEIR/datasets/${ds}.zip
    unzip ${ds}.zip
done
Para omitir el costoso preprocesamiento, esta versión incluye recuperaciones
precalculadas de Contriever (results/beir_results/), los subconjuntos fijos de evaluación de 1,000 consultas
(target_queries_fixed/) y ejemplos de salidas de las Etapas 2/3
(data_examples/) para los tres conjuntos de datos.
Todos los números reportados se reproducen para HotpotQA, NQ y MS-MARCO a partir de los
artefactos incluidos. (Volver a ejecutar la Etapa 2 en sí requiere tu propio archivo de respuestas para NQ y
MS-MARCO — gen_adv.py explica esto si lo intentas).
Este código se proporciona bajo la licencia MIT (LICENSE), siguiendo el
repositorio original PoisonedRAG,
que también es MIT.
Una excepción: src/contriever_src/ es el código de
contriever de Meta y permanece
bajo CC BY-NC 4.0, por lo que ese directorio es solo para uso no comercial.
Este paquete se proporciona con fines de investigación y reproducibilidad. El código publicado tiene como objetivo reproducir los experimentos reportados en el artículo y apoyar la investigación sobre la robustez y las defensas de RAG.
El paquete utiliza conjuntos de datos, modelos y bibliotecas de software disponibles públicamente bajo sus respectivas licencias y términos de uso. Los conjuntos de datos BEIR como HotpotQA, NQ y MS-MARCO se descargan de las URL oficiales de BEIR en lugar de redistribuirse en este paquete.
Los pesos de los modelos y las API utilizadas por el pipeline, incluidos GPT-4o-mini, GPT-4.1-mini, Llama-3.1-8B, Qwen3-8B, Mixtral-8x7B, Contriever, ANCE, GPT-2, bge-reranker-v2-m3 y gpt-oss-safeguard-20b, permanecen sujetos a las licencias y políticas de uso de sus proveedores originales. Este paquete no otorga derechos adicionales sobre esos artefactos de terceros.
Los documentos adversariales y los artefactos intermedios incluidos en este paquete se proporcionan únicamente para la evaluación de investigación controlada de la robustez de RAG. No deben utilizarse para atacar sistemas desplegados ni envenenar bases de conocimiento del mundo real.
@misc{jung2026camodocs,
      title={CamoDocs: A Poisoning Attack Against Retrieval-Augmented Language Models Using Camouflaged Documents},
      author={Jaewon Jung and Haizhong Zheng and Hongsun Jang and Jaeyong Song and Beidi Chen and Jinho Lee},
      year={2026},
      eprint={2608.28389},
      archivePrefix={arXiv},
      primaryClass={cs.CR},
      url={https://arxiv.org/abs/2608.28389},
}
