
Skip to content
KitploitKITPLOIT
HerramientasExploitsBlog
Log in
Enviar
HerramientasExploitsBlog
Enviar

¡Herramientas de Hacking, PenTest y Ciberseguridad para tu Arsenal de Seguridad!

Kitploit es un directorio de herramientas de hacking, ciberseguridad y pentesting. Descubre las últimas actualizaciones de proyectos para encontrar vulnerabilidades, analizar sistemas, automatizar pruebas y fortalecer tu seguridad.

FeedsContactoPrivacidad© 2026 Kitploit

Directorio de Herramientas

Categorías

Ver todas las categorías
Loading categories
ColonelClustered — Un plugin de Burp en Java que realiza agrupamiento de texto en las respuestas para identificar valores atípicos/grupos basándose en el contenido real de las respuestas del servidor, por ejemplo, de una ejecución de Intruder. | Kitploit
Herramientas/GitHubGitHub/hoodoer/colonelclustered
Análisis de VulnerabilidadesProxies Web e InterceptaciónExplotación de Aplicaciones WebSeguridad WebFuzzingPruebas de PenetraciónUtilidades y FrameworksAprendizaje Automático
GitHubhoodoer/colonelclustered

ColonelClustered

Un plugin de Burp en Java que realiza agrupamiento de texto en las respuestas para identificar valores atípicos/grupos basándose en el contenido real de las respuestas del servidor, por ejemplo, de una ejecución de Intruder.

121hace 15 díasAún no revisado
Ver Repositorio

Más Populares

Ver todos →

Descubre las herramientas más usadas por nuestra comunidad.

Explora todas las herramientas

Explora nuestra colección de herramientas

Ver todas las herramientas →
Compartir

Colonel Clustered - Clustering de Similitud de Respuestas (v1.0.1)

Una extensión de Burp Suite para agrupar respuestas HTTP y encontrar valores atípicos.

Introducción

Este es un plugin que he estado pensando en construir durante muchos años, simplemente porque me molesta moderadamente cómo analizamos los resultados de los ataques de fuzzing en Burp intruder. Normalmente buscamos cambios en las respuestas del servidor en nuestros ataques de fuzzing. Y buscamos esas diferencias observando los códigos de estado, el tiempo de respuesta y los tamaños de respuesta. Todas estas son medidas indirectas del contenido de la respuesta. Por supuesto, como pentesters no tenemos tiempo para leer el contenido de miles de servidores para buscar diferencias en el contenido de las respuestas. Pero ciertamente podemos hacer que los algoritmos hagan esto por nosotros.

Ahí es donde entra este plugin. Utiliza técnicas de clustering de texto para analizar el contenido de las respuestas y agruparlas en clústeres según su similitud. Te ofrece otra forma de ver los resultados de tus ataques de fuzzing con intruder, e identificar rápidamente aquellas respuestas del servidor que son diferentes.

Cómo Funciona

Colonel Clustered proporciona dos algoritmos diferentes para realizar el clustering de respuestas. El algoritmo predeterminado es relativamente rápido, con un algoritmo opcional de análisis más profundo que sobresale en la detección de valores atípicos, pero no escala bien. Bueno, ninguno escala bien, dudaría en lanzar 50k respuestas a este plugin. El algoritmo más rápido/predeterminado tiene una complejidad O(n^2), mientras que el algoritmo de análisis profundo es O(n^3). Así que tenlo en cuenta a medida que le envías resultados de intruder para procesar.

  1. Tokenización Consciente del Contenido: La extensión primero inspecciona el encabezado Content-Type de cada respuesta para aplicar la estrategia de tokenización más inteligente:

    • HTML: Elimina todas las etiquetas y scripts, luego genera 5-gramas basados en caracteres sobre el texto visible. Esto incluye la sanitización de dígitos para garantizar la resiliencia a variaciones menores (como IDs) en contenido con plantillas.
    • JSON: Extrae todas las claves y sus rutas anidadas como tokens, ignorando los valores. Para los arrays, analiza la estructura de todos los objetos contenidos.
    • Texto: Genera 5-gramas basados en caracteres sobre el contenido de texto plano, también sanitizando dígitos para la resiliencia de plantillas.
    • Binario/Otro: Si el contenido no está basado en texto, genera un conjunto de n-gramas de 5 bytes para encontrar similitudes en los datos binarios.
  2. Pre-Agrupación: Para mantenerse rápido incluso con miles de respuestas, la extensión realiza una única pasada para agrupar todas las respuestas perfectamente idénticas. Calcula un hash del conjunto de tokens de cada respuesta y agrupa todos los elementos que comparten el mismo hash. Esto significa que el costoso algoritmo de clustering solo tiene que ejecutarse sobre el conjunto mucho más pequeño de cuerpos de respuesta únicos.

  3. Algoritmos de Clustering Duales: Colonel Clustered ofrece dos algoritmos de clustering distintos:

    • Fast Scan (Predeterminado): Un algoritmo de alto rendimiento basado en DBSCAN se ejecuta automáticamente cuando envías múltiples solicitudes/respuestas a la extensión.

      • Ajuste Automático de Epsilon: Utiliza el algoritmo Kneedle para determinar automáticamente el epsilon óptimo (radio de densidad), adaptándose a las características del conjunto de datos.
      • Detección de Valores Atípicos (minPts=2): minPts está fijado en 2, lo que lo hace altamente efectivo para identificar respuestas que son únicas o comparten similitud con solo otro elemento, garantizando una detección sensible de valores atípicos.
    • Deep Analysis (Activación Manual): El algoritmo original de clustering jerárquico, más intensivo computacionalmente, está disponible a través de un botón "Deep Analysis". Esta opción está diseñada para escenarios que requieren una perspectiva de clustering más granular y potencialmente diferente, utilizando Average Linkage para mejorar la cohesión del clúster.

      • Construye una matriz de similitud utilizando la distancia de Jaccard entre respuestas únicas.
      • Fusiona iterativamente los clústeres más similares, registrando las distancias de fusión para determinar umbrales óptimos.
  4. Consolidación de Valores Atípicos: Después del clustering, cualquier grupo resultante que contenga solo un miembro único se considera un valor atípico. Todos estos valores atípicos se consolidan luego en un único y conveniente grupo "Outliers" en la interfaz de usuario.

Estos dos algoritmos deberían proporcionar una forma fácil de identificar automáticamente respuestas del servidor que difieren en contenido, incluso cuando el tamaño de la respuesta es una medida poco fiable de las diferencias entre respuestas.

Cómo Usar

  1. Cargar la Extensión:

    • Ve a la pestaña Extensions en Burp Suite.
    • Haz clic en Add y selecciona el archivo ColonelClustered.jar.
    • Debería aparecer una nueva pestaña llamada "Col. Clustered".
    • Nota: Espero poder incluirlo en la BAPP store pronto, actualizaré el README si es aceptado.
  2. Enviar Respuestas para Análisis:

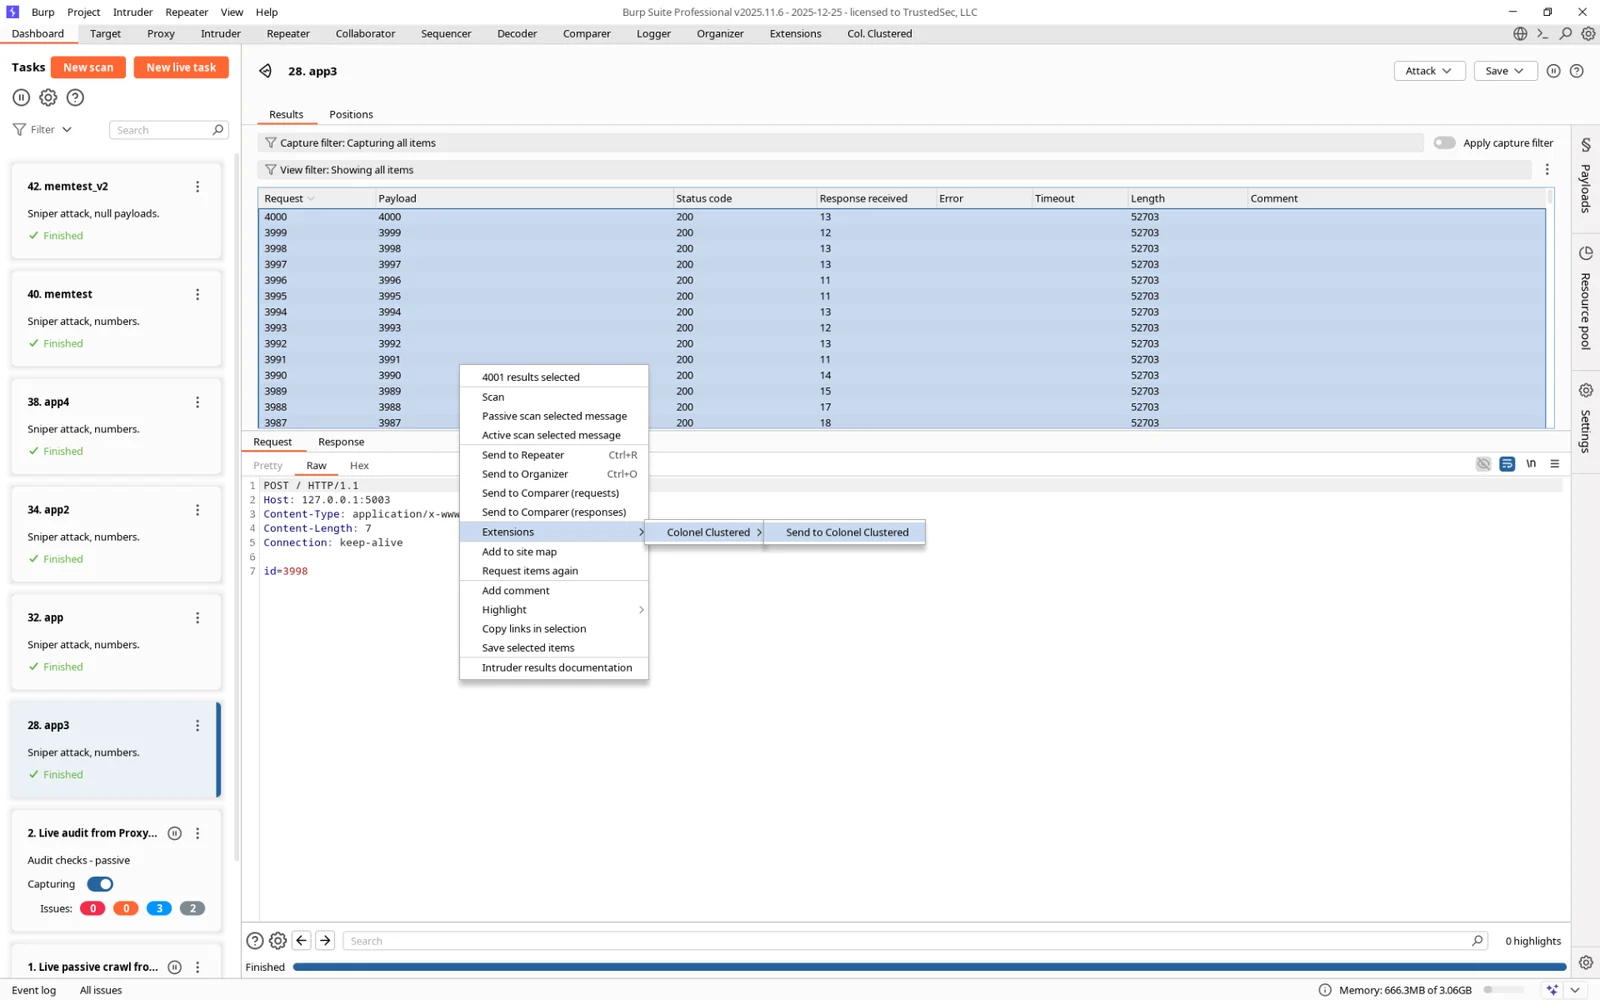
    • Ve a cualquier herramienta en Burp, como los resultados de Intruder o el historial del Proxy.
    • Selecciona uno o más elementos de solicitud/respuesta.
    • Haz clic derecho y selecciona "Send to Colonel Clustered".
    • Un Fast Scan predeterminado comenzará automáticamente, y aparecerá una barra de progreso para monitorear el análisis.
  3. Realizar Deep Analysis (Opcional):

    • Si se desea un clustering jerárquico más detallado, haz clic en el botón "Deep Analysis".
    • Nota: Si estás analizando una gran cantidad de elementos, aparecerá una advertencia sobre posibles problemas de rendimiento antes de que comience el escaneo.
    • Aparecerá una barra de progreso, permitiéndote monitorear el análisis.
  4. Analizar los Resultados en la Interfaz de Cuatro Paneles:

    • La pestaña "Colonel Clustered" utiliza un diseño de cuatro paneles para ayudarte a navegar rápidamente por los resultados.
    • Arriba-Izquierda (Clusters): Este panel muestra los clústeres encontrados, incluido un grupo especial "Outliers". Cada entrada muestra el número de elementos en ese clúster.
    • Abajo-Izquierda (Miembros del clúster): Selecciona un clúster en el panel superior para ver todos sus miembros mostrados en esta tabla. La tabla presenta varias columnas:
      • Request/Response Pair: El índice original del elemento.
      • Status Code: El código de estado de la respuesta HTTP.
      • Length: La longitud del cuerpo de la respuesta en bytes.
      • Content-Type: El encabezado Content-Type de la respuesta.
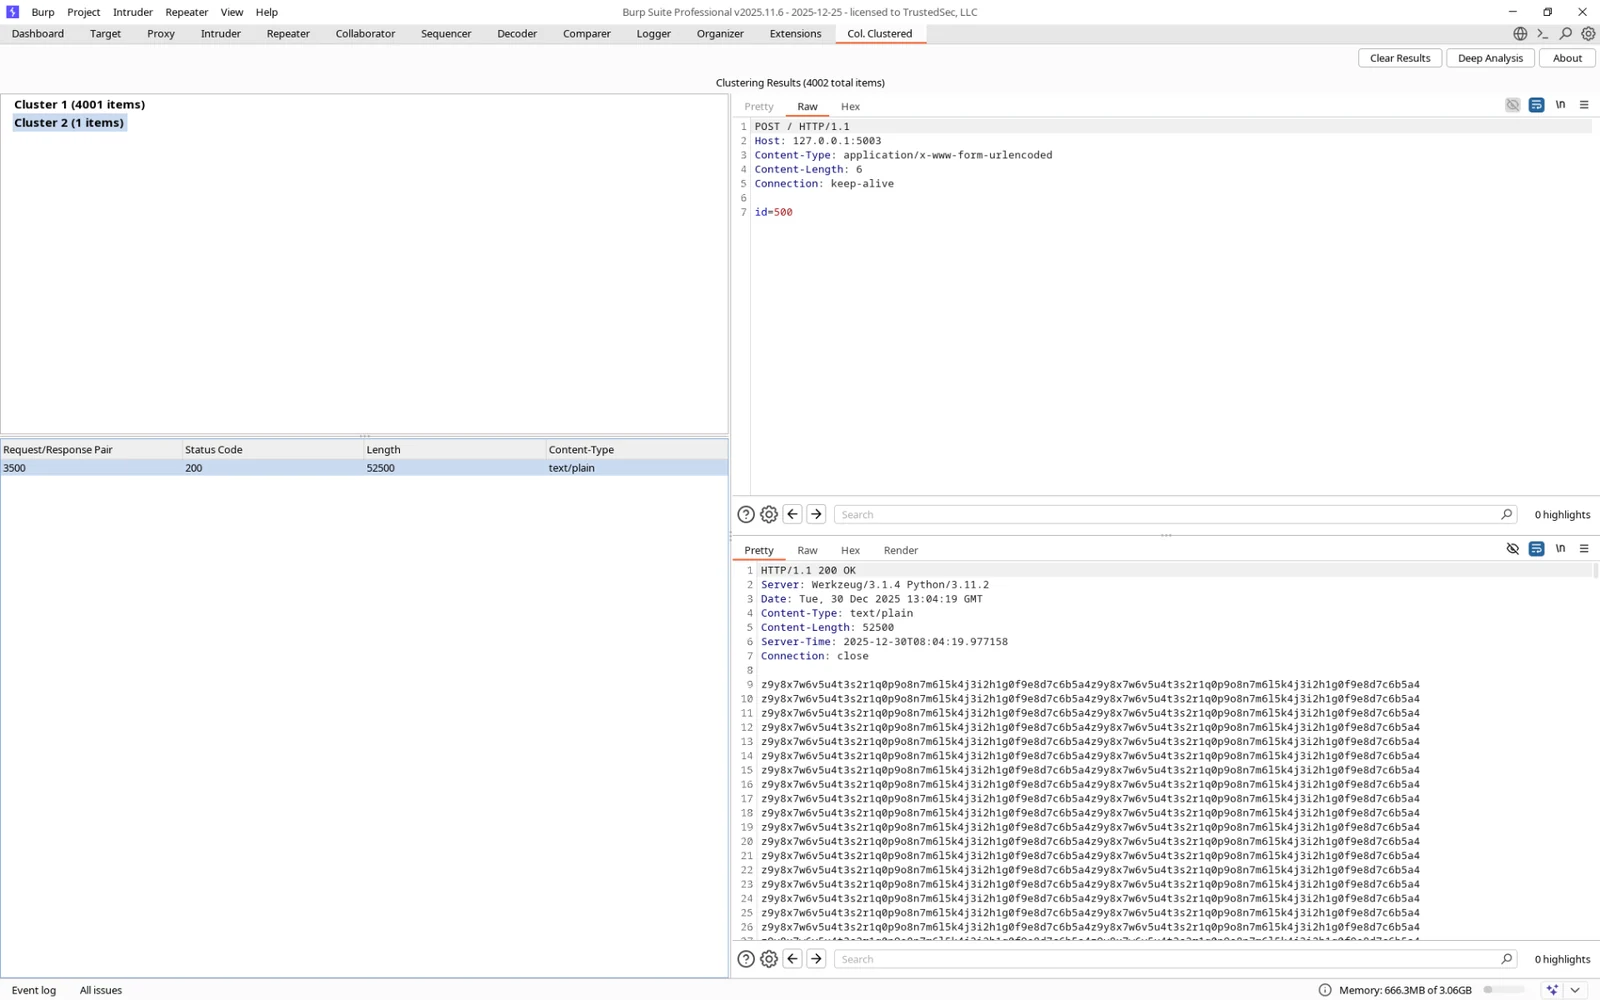
    • Ordenación: Haz clic en cualquier encabezado de columna de la tabla para ordenar los elementos dentro de ese clúster, permitiéndote encontrar fácilmente las respuestas más grandes/pequeñas, o agrupar por código de estado.
    • Arriba-Derecha y Abajo-Derecha (Visores): Selecciona cualquier fila de la tabla para ver su solicitud y respuesta completas en los visores de la derecha.

Capturas de Pantalla

image image

Compilar desde el Código Fuente

Descargar herramienta