 dtrizna/quasarnix
Detección de Reverse Shells con Machine Learning

Dmitrijs Trizna · Luca Demetrio · Battista Biggio · Fabio Roli


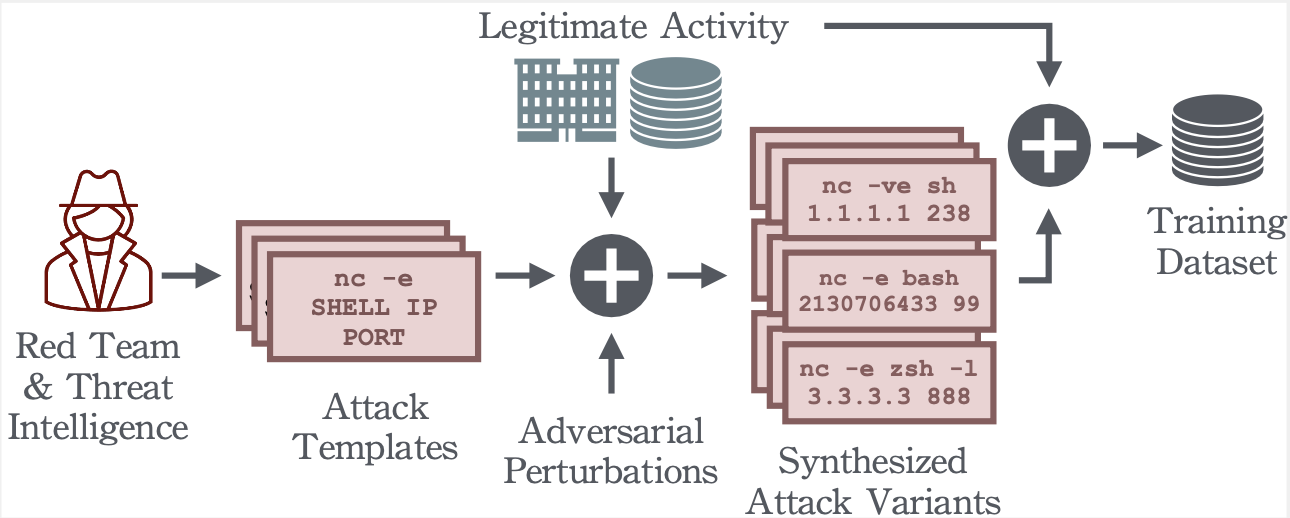
Las reverse shells living-off-the-land (LOTL) de Linux abusan de binarios legítimos (bash, python, nc, …) para establecer conexiones salientes encubiertas, lo que hace que la detección basada en firmas no sea fiable frente a variantes novedosas e intentos de evasión. QuasarNix aborda dos vacíos abiertos en este campo:
El framework sintetiza un corpus de entrenamiento de 1M de comandos a partir de 34 plantillas de reverse shells y evalúa 14 arquitecturas de modelos en un punto de operación de FPR = 10⁻⁶ — lo que refleja las restricciones reales de fatiga de alertas en SIEM.
Rendimiento en el conjunto de prueba reservado (held-out) de las heurísticas de referencia y las arquitecturas QuasarNix. La TPR se reporta como media ± desviación estándar en diez ejecuciones de entrenamiento independientes a FPR = 10⁻⁶. La negrita marca el mejor resultado; el asterisco (*) resalta los modelos analizados en el artículo.
| Arquitectura | Params | TPR @ FPR=10⁻⁶ | F1 | Exactitud | AUC | Entrenamiento |
|---|---|---|---|---|---|---|
| Firmas (Sigma) | 184 | 3.37% | 6.52% | 51.68% | 51.68% | N/A |
| One-Class SVM (sobre legítimo) | 1K | 0.00% | 82.87% | 79.33% | 79.33% | 10s |
| One-Class SVM (sobre malicioso) | 1K | 0.00% | 40.14% | 25.20% | 25.20% | 10s |
| 1D-CNN (sin aument., desbalanceado) | 1K | 0.00% | 80.29% | 77.91% | 87.44%* | 15m |
| 1D-CNN (sin aument., balanceado) | 1K | 0.06% | 82.38% | 79.33% | 88.12%* | 29m |
| SLP (sin aument.) | 1K | 0.00% | 0.00% | 50.00% | 91.58% | 1h 12m |
| Arquitectura | Params | TPR @ FPR=10⁻⁶ | F1 | Exactitud | AUC | Entrenamiento |
|---|---|---|---|---|---|---|
| Random Forest | 1K | 42.23 ± 6.27% | 96.07% | 96.21% | 99.84% | 18s |
| GBDT (XGBoost) | 1K | 60.20 ± 8.22% | 89.92% | 90.84% | 99.89% | 14s |
| MLP (No Embedding) | 264K | 54.16 ± 2.14%* | 94.00% | 94.34% | 99.80% | 18m |
| Arquitectura | Params | TPR @ FPR=10⁻⁶ | F1 | Exactitud | AUC | Entrenamiento |
|---|---|---|---|---|---|---|
| MLP (Embedding) | 297K | 10.76 ± 17.32% | 67.70% | 75.60% | 89.15% | 18m |
| LSTM | 318K | 21.52 ± 23.66% | 64.16% | 74.05% | 99.75% | 24m |
| 1D-CNN | 301K | 46.42 ± 32.67%* | 85.97% | 88.20% | 99.99% | 29m |
| 1D-CNN + LSTM | 316K | 20.48 ± 22.08% | 58.92% | 71.06% | 98.21% | 29m |
| 1D-CNN + LSTM + Attention | 402K | 17.19 ± 22.59% | 62.53% | 73.08% | 98.46% | 26m |
| Transformer (Mean Pooling) | 335K | 0.00 ± 0.00% | 83.39% | 86.07% | 98.78% | 1h 18m |
| Transformer (CLS Token) | 335K | 0.00 ± 0.00% | 78.55%* | 82.67% | 99.38% | 1h 30m |
| Transformer (Attn. Pooling) | 335K | 0.00 ± 0.00% | 87.82% | 89.41% | 98.85% | 1h 24m |
Conclusión: GBDT alcanza un 60% de TPR a FPR = 10⁻⁶ — 18× mayor que las firmas (3.37%) — con un entrenamiento de solo 14 segundos en hardware convencional.
La siguiente tabla cataloga las técnicas de shell escape de Linux presentes en la caja de herramientas del atacante. La tercera columna indica si la técnica sobrevive a la normalización de telemetría del kernel auditd — solo las cuatro entradas en negrita producen un registro EXECVE distinto y constituyen la verdadera superficie de ataque.
| Manipulación | Ejemplo funcional | Preservado por auditd |
|---|---|---|
' | ba's'h -i | No |
" | ba"s"h -i | No |
\ | ba\s\h -i | No |
$@ | ba$@sh -i | No |
[char] | ba[s]h -i | No |
{form} | {bash,-i} | No |
| Variable IFS | bash${IFS}-i | No |
| Variable vacía | bas${u}h -i | No |
| Comando falso | bas$(u)h -i | No |
| Base64 | echo c2ggLWk= | base64 -d | sh | No |
| Hex | echo \x73\x68 \x20\x2d\x69 | sh | No |
| Manipulación de flags | bash -x -li | Sí |
| IP decimal | ping 2130706433 | Sí |
| Renombrado del binario | cp bash a; a -i | Sí |
| Código fútil | mkfifo a; id; cat a | Sí |
Solo 4 de 15 técnicas sobreviven a la normalización a nivel de kernel y se utilizan como espacio de ataque adversarial.
Se evalúan tres familias de ataques: inyección de contenido benigno, perturbaciones de shell escape y un híbrido de ambas:
Además de la evasión en tiempo de inferencia, evaluamos ataques en tiempo de entrenamiento:
Contaminación por inversión de etiquetas (0–20% de etiquetas de entrenamiento invertidas): los modelos se degradan de forma gradual; GBDT muestra una resistencia inherente gracias al voto del ensemble, manteniéndose funcional con ratios de contaminación elevados.
Ataque de backdoor (0.01–1% de ratio de envenenamiento, triggers de 2–10 tokens): los triggers cortos (2–4 tokens) no logran instalar backdoors fiables debido a su prevalencia en el tráfico benigno. La instalación óptima de un backdoor requiere triggers de 6–10 tokens con un ratio de envenenamiento ≥0.03%.
Conclusión: Los ataques de envenenamiento requieren una inyección de datos sustancial y estadísticamente detectable para tener éxito. El mecanismo de ensemble de GBDT proporciona una robustez inherente sin coste de entrenamiento adversarial.
Tras la publicación de este trabajo, Google presentó un sistema de producción conceptualmente alineado en CAMLIS 2025 (arXiv:2512.08802): un pipeline de dos etapas basado en YARA + ML desplegado en decenas de miles de sistemas, que procesa hasta 250 mil millones de eventos al día. Ese sistema valida de forma independiente el paradigma híbrido de detección ML-para-SIEM y el bucle de retroalimentación de aprendizaje activo propuesto aquí, demostrando su viabilidad a escala industrial.

