 d4vinci/cwff
Crea tu lista de palabras personalizada para fuzzing

CWFF es una herramienta que crea una lista de palabras especial de alta calidad para fuzzing/descubrimiento de contenido a la máxima velocidad posible usando concurrencia y está fuertemente inspirada por el Who, What, Where, When, Wordlist #NahamCon2020 de @tomnomnom.
CWFF [-h] [--threads] [--github] [--subdomains] [--recursive] [--js-libraries] [--connected-websites] [--juicy-files] [--use-filter-model] [-o] domain

positional arguments:
  domain                Target website(ofc)

optional arguments:
  -h, --help            Show this help message and exit
  --threads             The number of maximum concurrent threads to use (Default:1000)
  --github              Collect endpoints from a given github repo (ex:https://github.com/google/flax)
  --subdomains          Extract endpoints from subdomains also while search in the wayback machine!
  --recursive           Work on extracted endpoints recursively (Adds more endpoints but less accurate sometimes)!
  --js-libraries        Extract endpoints from JS libraries also, not just the JS written by them!
  --connected-websites  Include endpoints extracted from connected websites
  --juicy-files         Include endpoints extracted from juicy files like sitemap.xml and robots.txt
  --use-filter-model    Filter result endpoints with filter_model file
  -o                    The output directory for the endpoints and parameters. (Default: website name)
Básicamente, recopila endpoints y parámetros del objetivo y sus subdominios usando muchas fuentes que ahora mencionaremos:
Archive wayback machine: recorre todos los registros del sitio web objetivo y sus subdominios y extrae las URLs que devuelven el código de estado 200.
Muchas herramientas solo recorren la página superior de wayback para ahorrar tiempo, pero aquí recorremos todos los registros en poco tiempo, aunque esto también hace que tome mucho tiempo cuando se usa la bandera --subdomains.
Archivos JavaScript recopilados durante la fase de wayback y los obtenidos al analizar la página objetivo en busca de la etiqueta <script>.
CWFF intenta separar las librerías JS de los archivos JS realmente escritos por los desarrolladores del sitio, examinando los nombres de los archivos JS.
Por defecto, CWFF extrae endpoints solo de los archivos JS escritos por los desarrolladores; para usar las librerías JS (generalmente no útiles), activa la bandera --js-libraries.
Common crawl CDX index y Alien vault OTX (Open Threat Exchange).
Si le das a CWFF la bandera --juicy-files, también extraerá endpoints de archivos como Sitemap.xml y robots.txt (podría agregar más en el futuro).
Si le das a CWFF un repositorio de github usando la bandera --github, extraerá rutas de ese repositorio usando la API de Github (no se necesita clave API).
Para aclarar, CWFF solo usará las rutas de archivos y directorios, por lo que no extraerá endpoints del interior de los archivos.
Al usar la bandera --connected-websites, CWFF utilizará la API de builtwith website (necesita clave, pero es gratuita) para extraer los sitios web conectados al objetivo desde el perfil de relaciones y luego extraer endpoints del código fuente de esos sitios.
Nota: puedes obtener tu clave API desde esta página y configurar la variable en el archivo
API_keys.py.
Después de recopilar endpoints de todas estas fuentes, si usaste la bandera --recursive, CWFF extraerá recursivamente partes de los endpoints recopilados.
parseq/javadoc/1.1.0/com se convertirá en todos estos endpoints:
parseq/javadoc/1.1.0/com
parseq/javadoc/1.1.0/
parseq/javadoc/
parseq/
javadoc/
1.1.0/
com
Nota: todos los endpoints/parámetros recopilados se limpian y ordenan sin duplicados para obtener un resultado único.
Por supuesto, después de todas estas fuentes y todo este trabajo, habrá muchos endpoints no deseados/inútiles entre los importantes, y aquí el filtrado juega un papel importante para ahorrar tiempo y recursos.
En CWFF puedes detectar y eliminar los endpoints no deseados usando tres métodos:
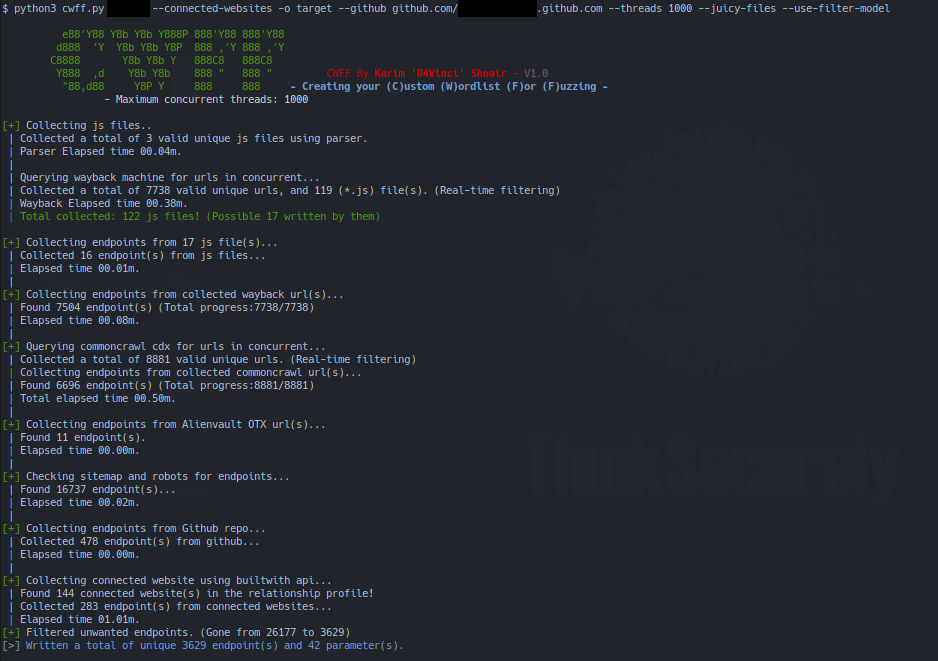
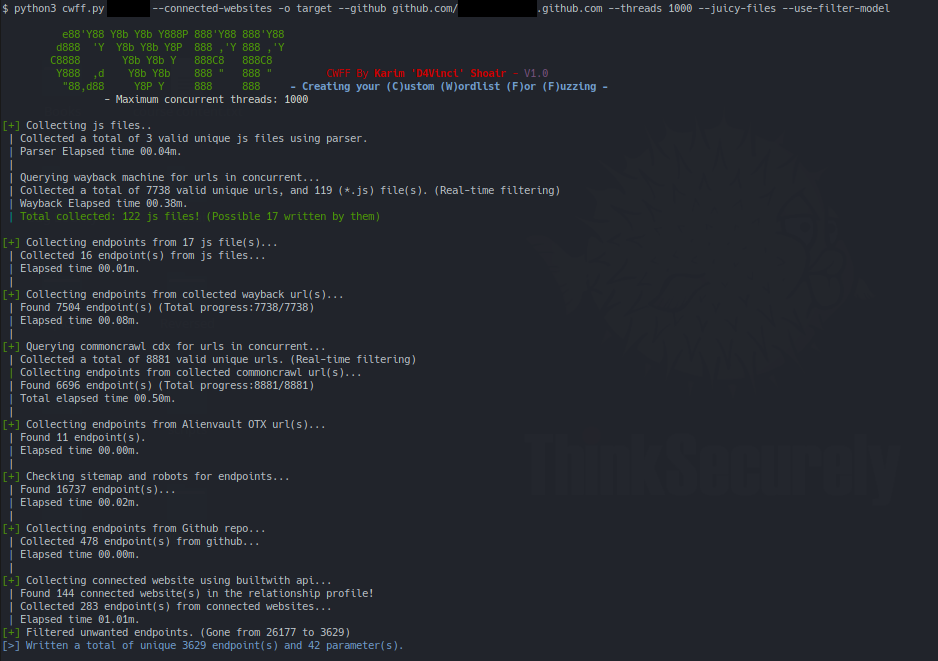
Todas estas opciones de filtrado se pueden proporcionar configurando las variables en el archivo filter_model.py y luego usando la bandera --use-filter-model al iniciar CWFF. Si no sabes cómo configurar estas variables, mira los comentarios que dejé en el archivo; es el que uso principalmente y en la captura de pantalla redujo el número de endpoints recopilados de 26,177 a 3629.
En caso de que olvides usar el filtrado mientras ejecutas CWFF, no te preocupes, te cubro 😄
Puedes usar el script filter.py para filtrar los endpoints que ya tienes de la siguiente manera, y cargará el archivo filter_model.py automáticamente sin tener que volver a ejecutar CWFF:
python filter.py wordlist.txt output.txt
python3 -m pip install -r requirements.txt
python3 cwff.py --help
Si mi trabajo te ha sido útil, siéntete libre de agradecerme invitándome un café.
CWFF se creó para ayudar en pruebas de penetración y no es responsable de ningún uso indebido o fines ilegales.
Copiar código de esta herramienta o usarlo en otra herramienta está aceptado siempre que menciones la fuente :smile
