
 blessedrebus/krawl
Krawl es un servidor de decepción web personalizable, liviano y nativo de la nube, y un anti-crawler que crea aplicaciones web falsas con vulnerabilidades de bajo nivel utilizando datos señuelo generados aleatoriamente y realistas, y plantillas HTML generadas por IA.

<h1 align="center">Krawl</h1>
<h3 align="center">
<a name="readme-top"></a>
<img
src="https://raw.githubusercontent.com/blessedrebus/krawl/HEAD/img/krawl-svg.svg"
height="250"
>
</h3>
<div align="center">
<p align="center">
Un servidor honeypot web moderno y personalizable diseñado para detectar y rastrear actividad maliciosa de atacantes y rastreadores web mediante páginas web engañosas, credenciales falsas y canary tokens.
</p>
<div align="center">
<a href="https://github.com/blessedrebus/krawl/blob/main/LICENSE">
<img src="https://img.shields.io/github/license/blessedrebus/krawl" alt="License">
</a>
<a href="https://github.com/blessedrebus/krawl/releases">
<img src="https://img.shields.io/github/v/release/blessedrebus/krawl" alt="Release">
</a>
</div>
<div align="center">
<a href="https://ghcr.io/blessedrebus/krawl">
<img src="https://img.shields.io/badge/ghcr.io-krawl-blue" alt="GitHub Container Registry">
</a>
<a href="https://kubernetes.io/">
<img src="https://img.shields.io/badge/kubernetes-ready-326CE5?logo=kubernetes&logoColor=white" alt="Kubernetes">
</a>
<a href="https://github.com/BlessedRebuS/Krawl/pkgs/container/krawl-chart">
<img src="https://img.shields.io/badge/helm-chart-0F1689?logo=helm&logoColor=white" alt="Helm Chart">
</a>
</div>
</div>
## Tabla de Contenidos
- [Demo](#demo)
- [¿Qué es Krawl?](#qué-es-krawl)
- [Panel de Krawl](#panel-de-krawl)
- [Modos de Despliegue](#modos-de-despliegue)
- [Lista de Bloqueo de Krawl](#lista-de-bloqueo-de-krawl)
- [Inicio Rápido](#inicio-rápido)
- [Docker Run](#docker-run)
- [Docker Compose](#docker-compose)
- [Kubernetes](#kubernetes)
- [Uvicorn (Python)](#uvicorn-python)
- [Configuración](#configuración)
- [config.yaml](#configuración-vía-configyaml)
- [Variables de Entorno](#configuración-vía-variables-de-entorno)
- [Bloquear IPs Maliciosas](#usar-krawl-para-bloquear-ips-maliciosas)
- [Reputación de IP](#reputación-de-ip)
- [Ejecución Detrás de un Proxy Inverso o CDN](#ejecución-detrás-de-un-proxy-inverso-o-cdn)
- [Métricas y Monitoreo](#métricas--monitoreo)
- [Documentación Adicional](#documentación-adicional)
- [Engaño usando IA](#páginas-de-engaño-generadas-por-ia)
- [Contribuir](#contribuir)
## Demo
Consejo: rastrea las rutas de `robots.txt` para diversión adicional
### URL de Krawl: [http://demo.krawlme.com](http://demo.krawlme.com)
### Ver el panel [http://demo.krawlme.com/das_dashboard](http://demo.krawlme.com/das_dashboard)
## ¿Qué es Krawl?
**Krawl** es un servidor de engaño nativo de la nube diseñado para detectar, retrasar y analizar atacantes maliciosos, rastreadores web y escáneres automatizados.
Crea aplicaciones web falsas realistas llenas de objetivos fáciles como paneles de administración, archivos de configuración y credenciales falsas expuestas para atraer e identificar actividad sospechosa.
Al desperdiciar recursos del atacante, Krawl ayuda a distinguir claramente el comportamiento malicioso de los rastreadores legítimos.
Incluye:
- **[Páginas de Engaño Generadas por IA](https://github.com/blessedrebus/krawl/blob/main/docs/ai_generation.md)**: **Deja que los atacantes ayuden a generar tu superficie de ataque falsa y vulnerable**
- **Páginas Trampa para Arañas**: Enlaces aleatorios infinitos para desperdiciar recursos de los rastreadores basado en el [proyecto spidertrap](https://github.com/adhdproject/spidertrap)
- **Páginas de Inicio de Sesión Falsas**: WordPress, phpMyAdmin, paneles de administración
- **Rutas Honeypot**: Anunciadas en robots.txt para atrapar escáneres
- **Credenciales Falsas**: Nombres de usuario, contraseñas y claves API de aspecto realista
- **Integración de [Canary Token](https://github.com/blessedrebus/krawl/blob/main/docs/canary-token.md)**: Disparo de alertas externas
- **Cabeceras de servidor aleatorias**: Confunden ataques basados en la cabecera y versión del servidor
- **Panel en Tiempo Real**: Monitorea actividad sospechosa
- **Listas de Palabras Personalizables**: Configuración sencilla basada en JSON
- **Inyección de Errores Aleatorios**: Imita el comportamiento de un servidor real
Puedes exponer fácilmente Krawl junto a tus otros servicios para protegerlos de rastreadores web y usuarios maliciosos usando un proxy inverso. Para más detalles, consulta la [documentación de Proxy Inverso](https://github.com/blessedrebus/krawl/blob/main/docs/reverse-proxy.md).
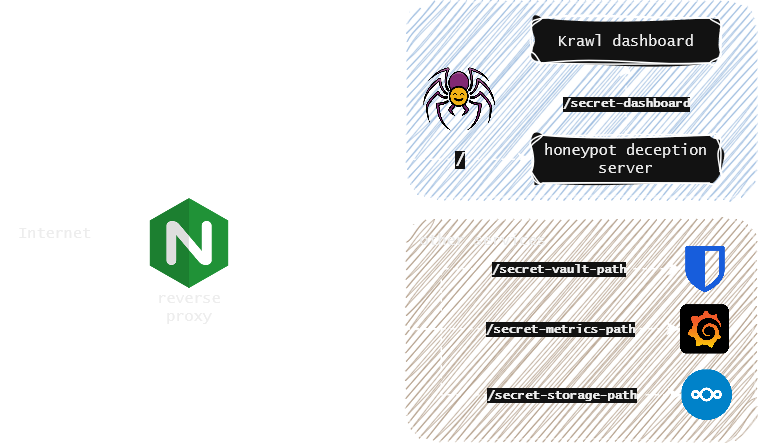
## Panel de Krawl
Krawl proporciona un panel completo, accesible en una **ruta secreta aleatoria** generada al inicio o en una **ruta personalizada** configurada mediante `KRAWL_DASHBOARD_SECRET_PATH`. Esto mantiene el panel oculto de los atacantes que escanean tu honeypot.
El panel está organizado en seis pestañas:
- **Overview**: vista de alto nivel de la actividad de ataque: un mapa interactivo de orígenes de IP, solicitudes sospechosas recientes y las principales IPs, User-Agents y rutas.
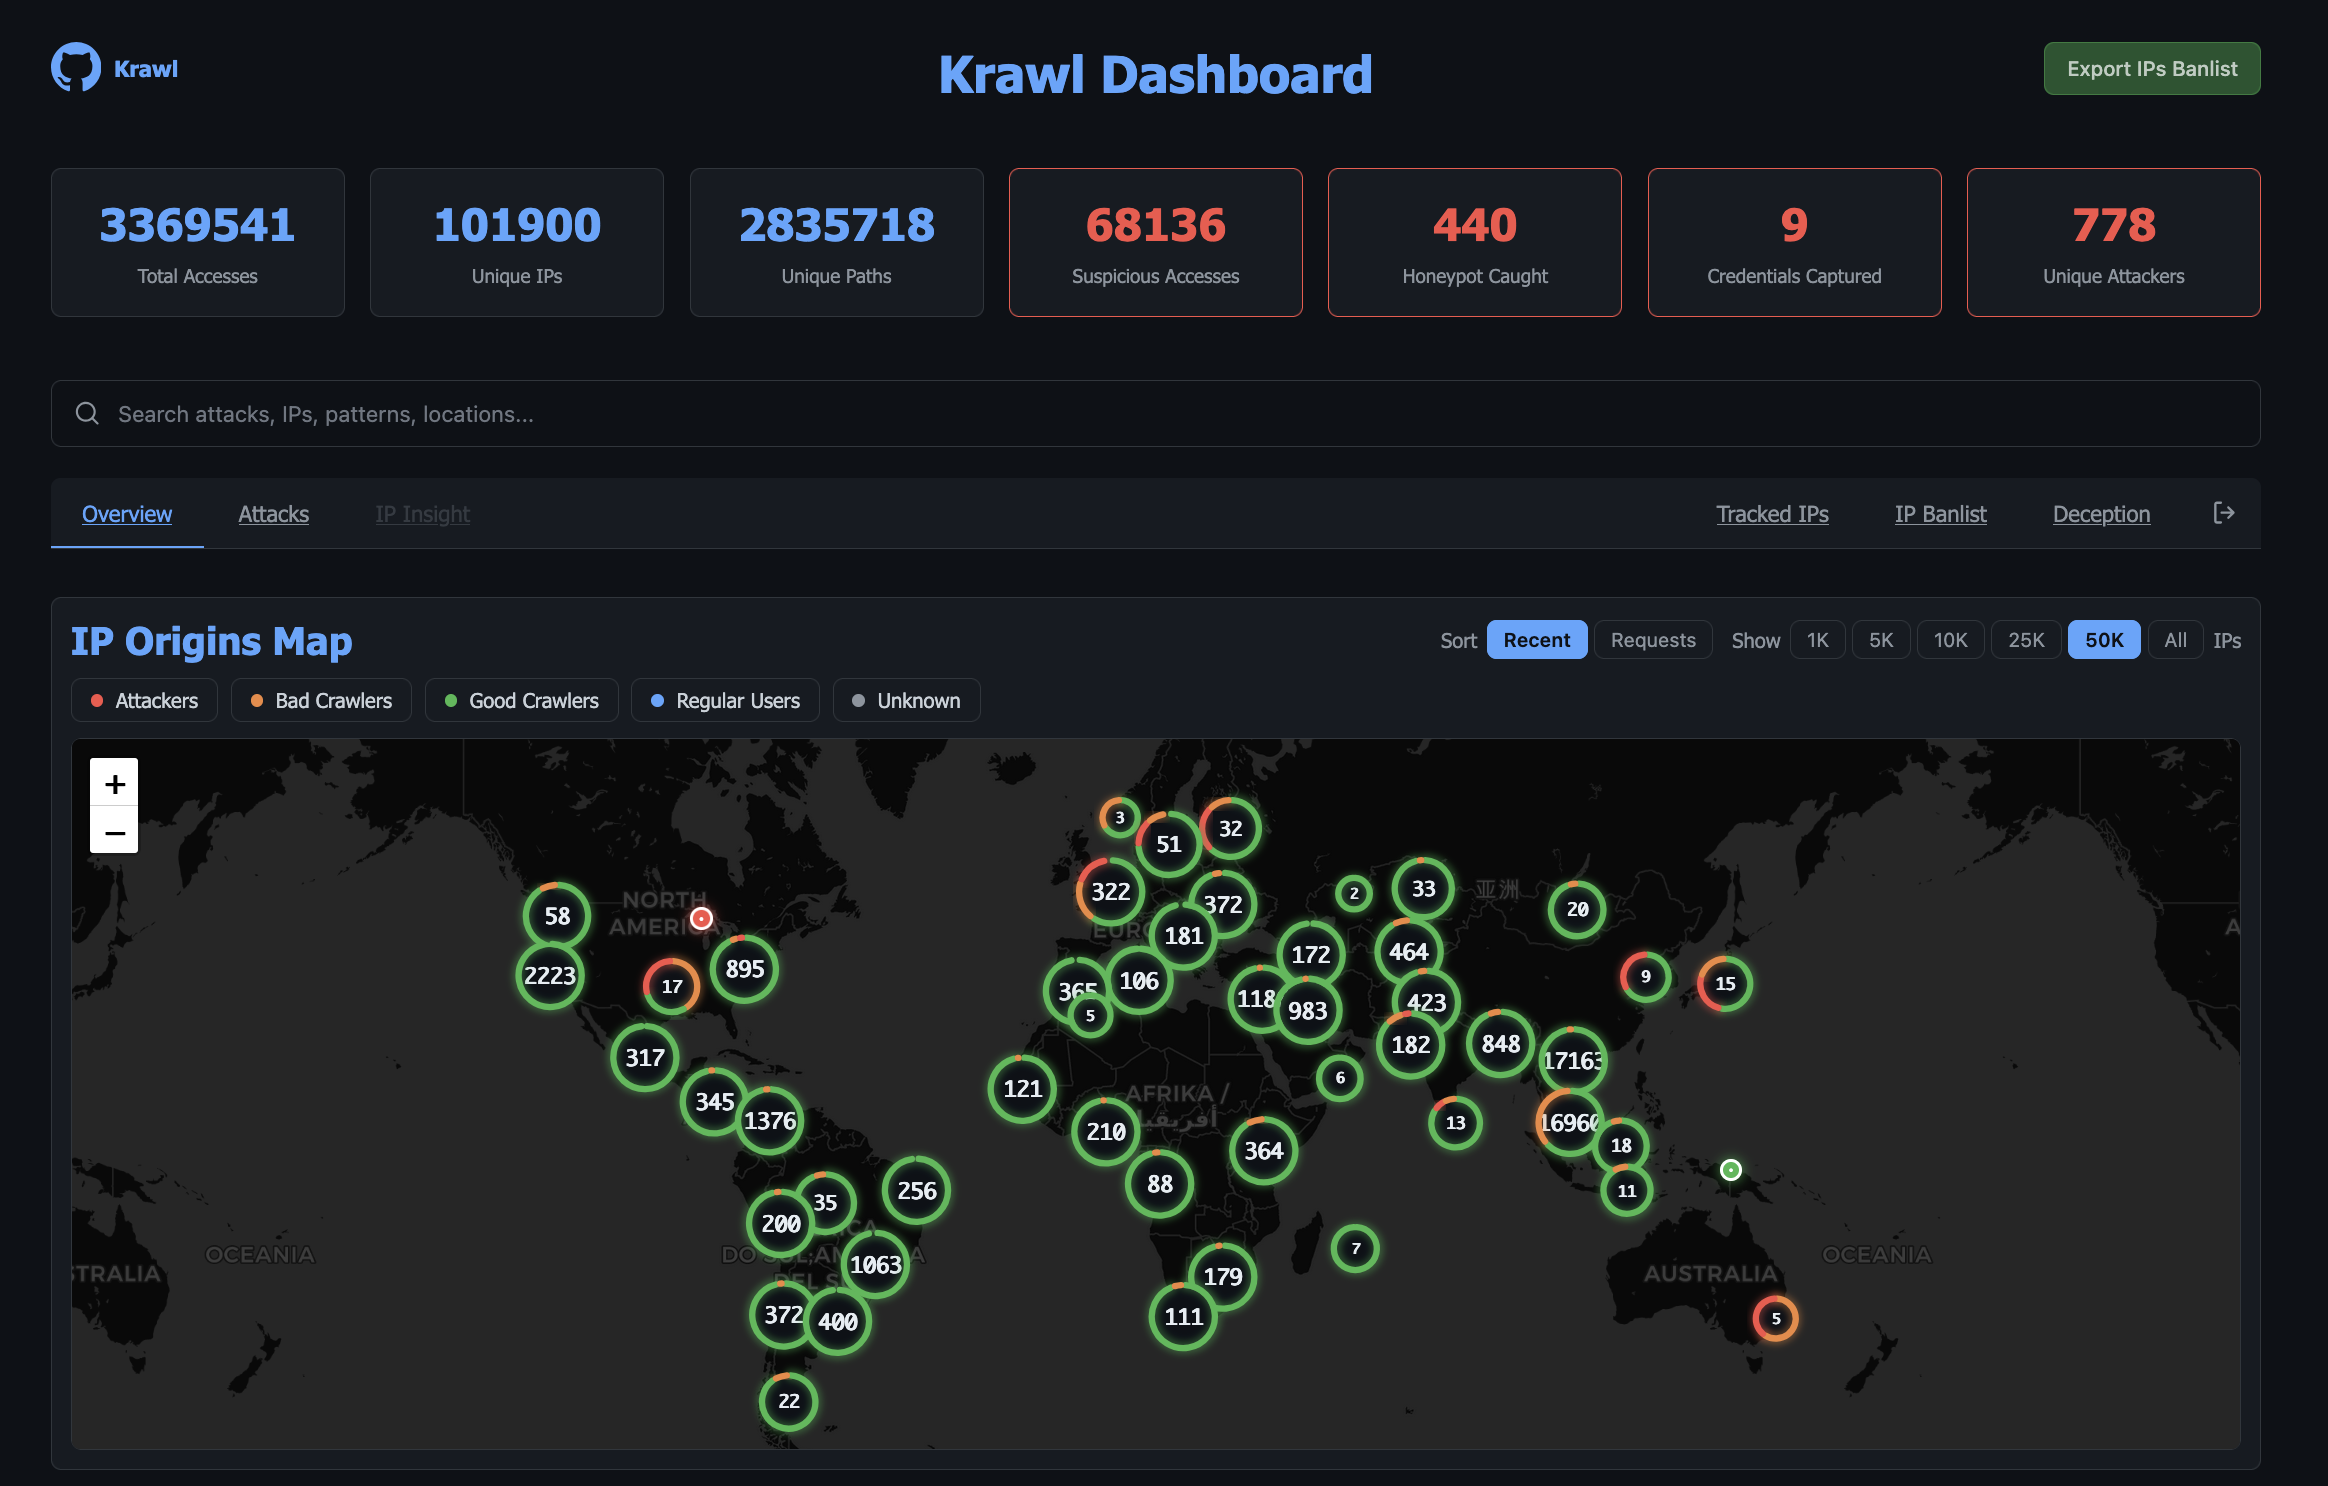
- **Attacks**: desglose detallado de credenciales capturadas, disparos de honeypot y tipos de ataque detectados (SQLi, XSS, path traversal, etc.) con gráficos y tablas.
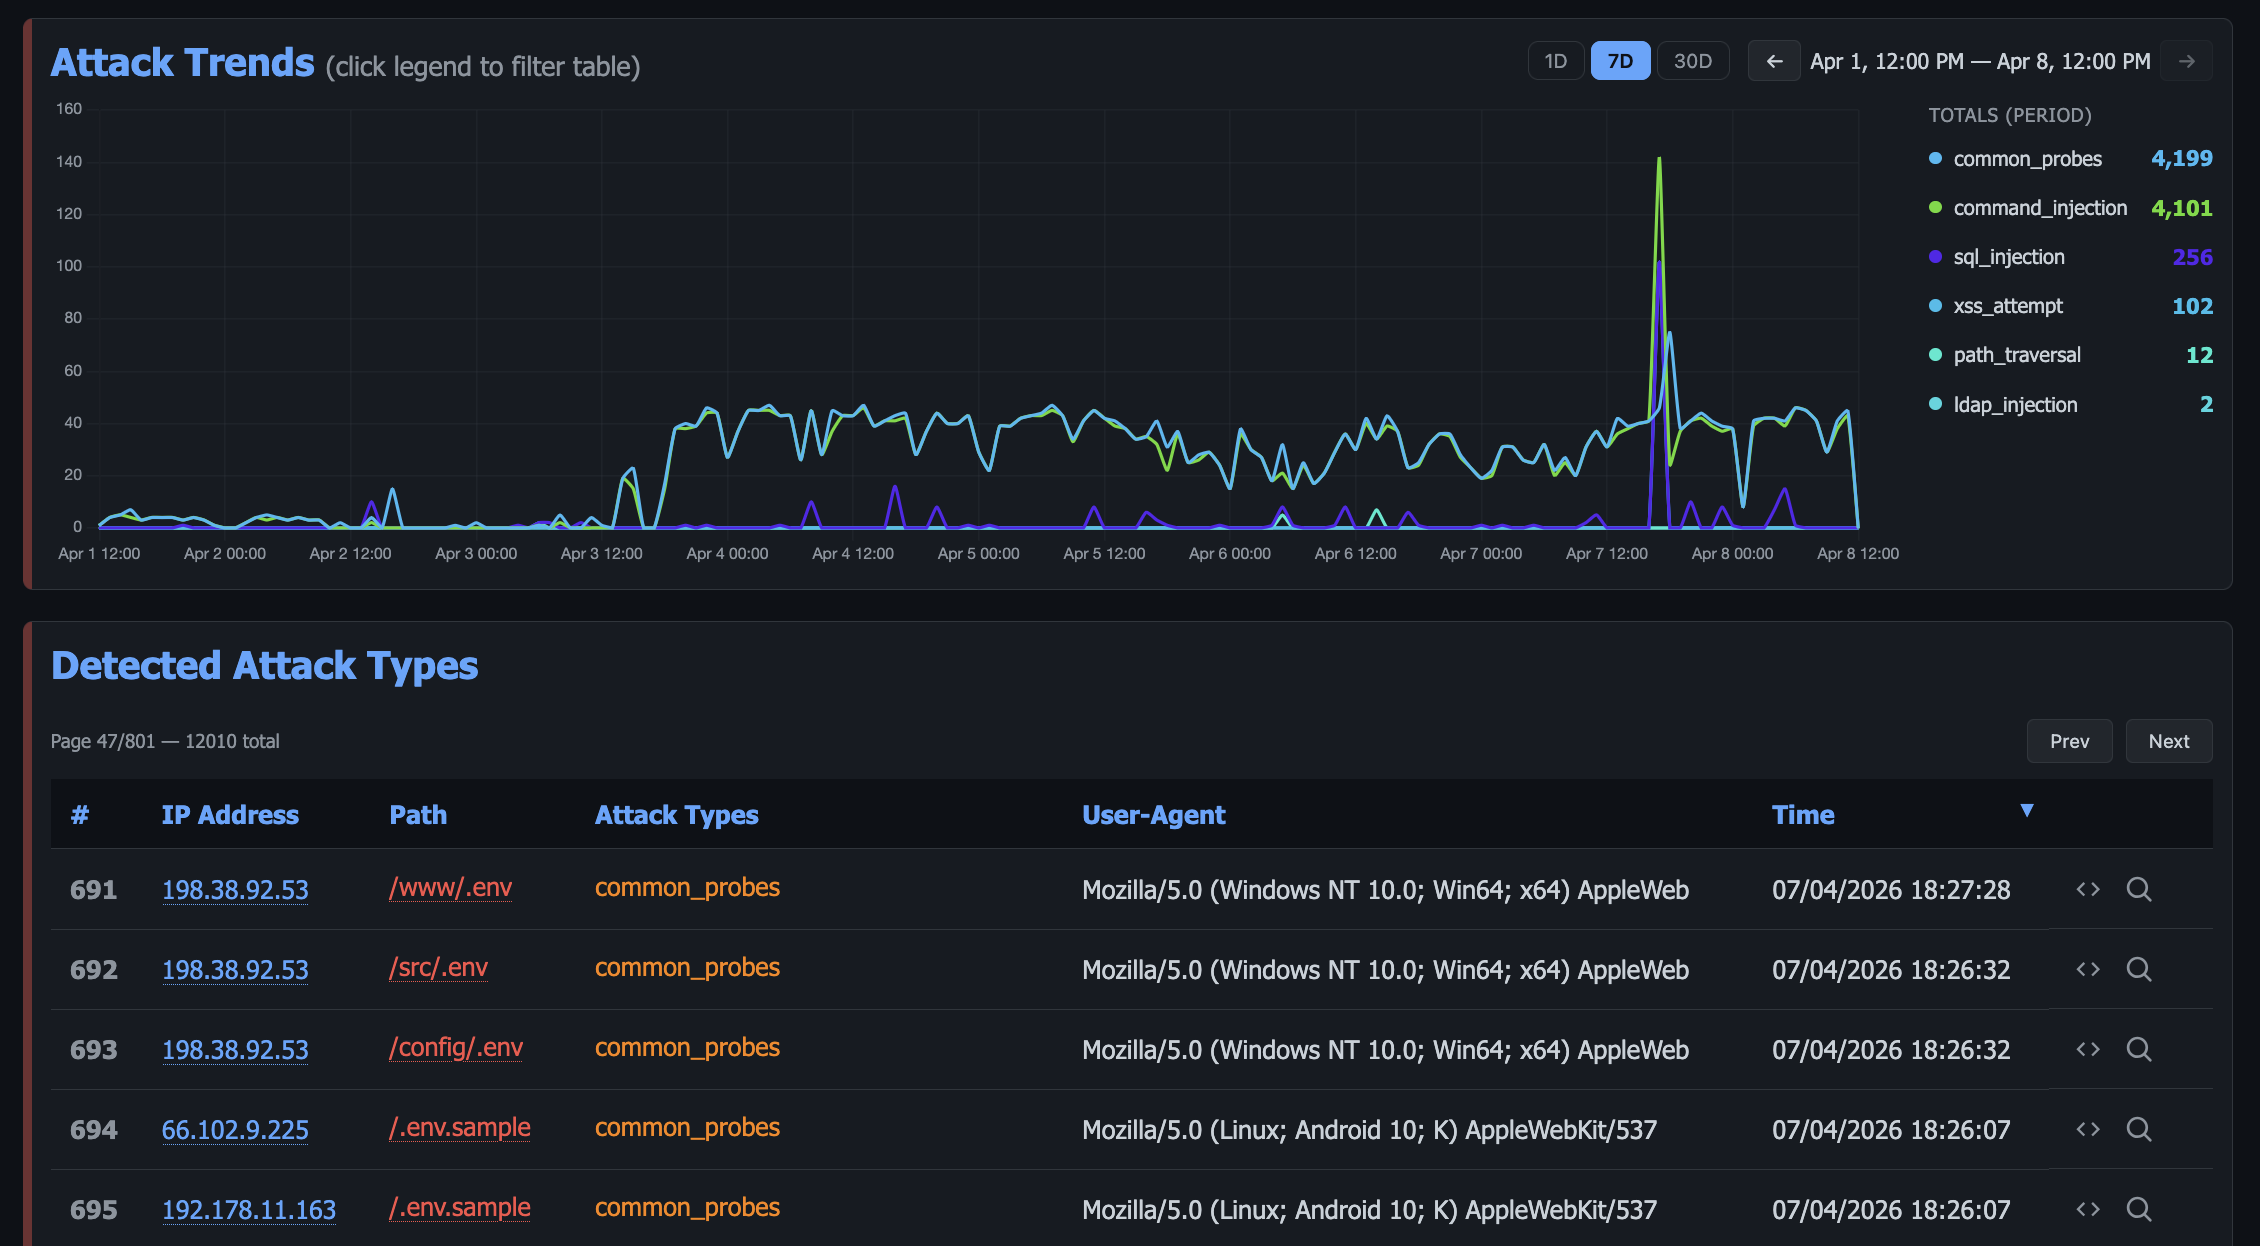
- **Threats**: payloads agrupados en campañas por hash difuso TLSH, de modo que un webshell y sus variantes editadas se leen como una sola campaña en lugar de hallazgos no relacionados, con un índice de cada archivo capturado.
- **IP Insight**: vista forense en profundidad de una IP seleccionada: geolocalización, información de ISP/ASN, indicadores de reputación, línea de tiempo de comportamiento, distribución de tipos de ataque, historial de referers, archivos y credenciales capturados, e historial completo de accesos.
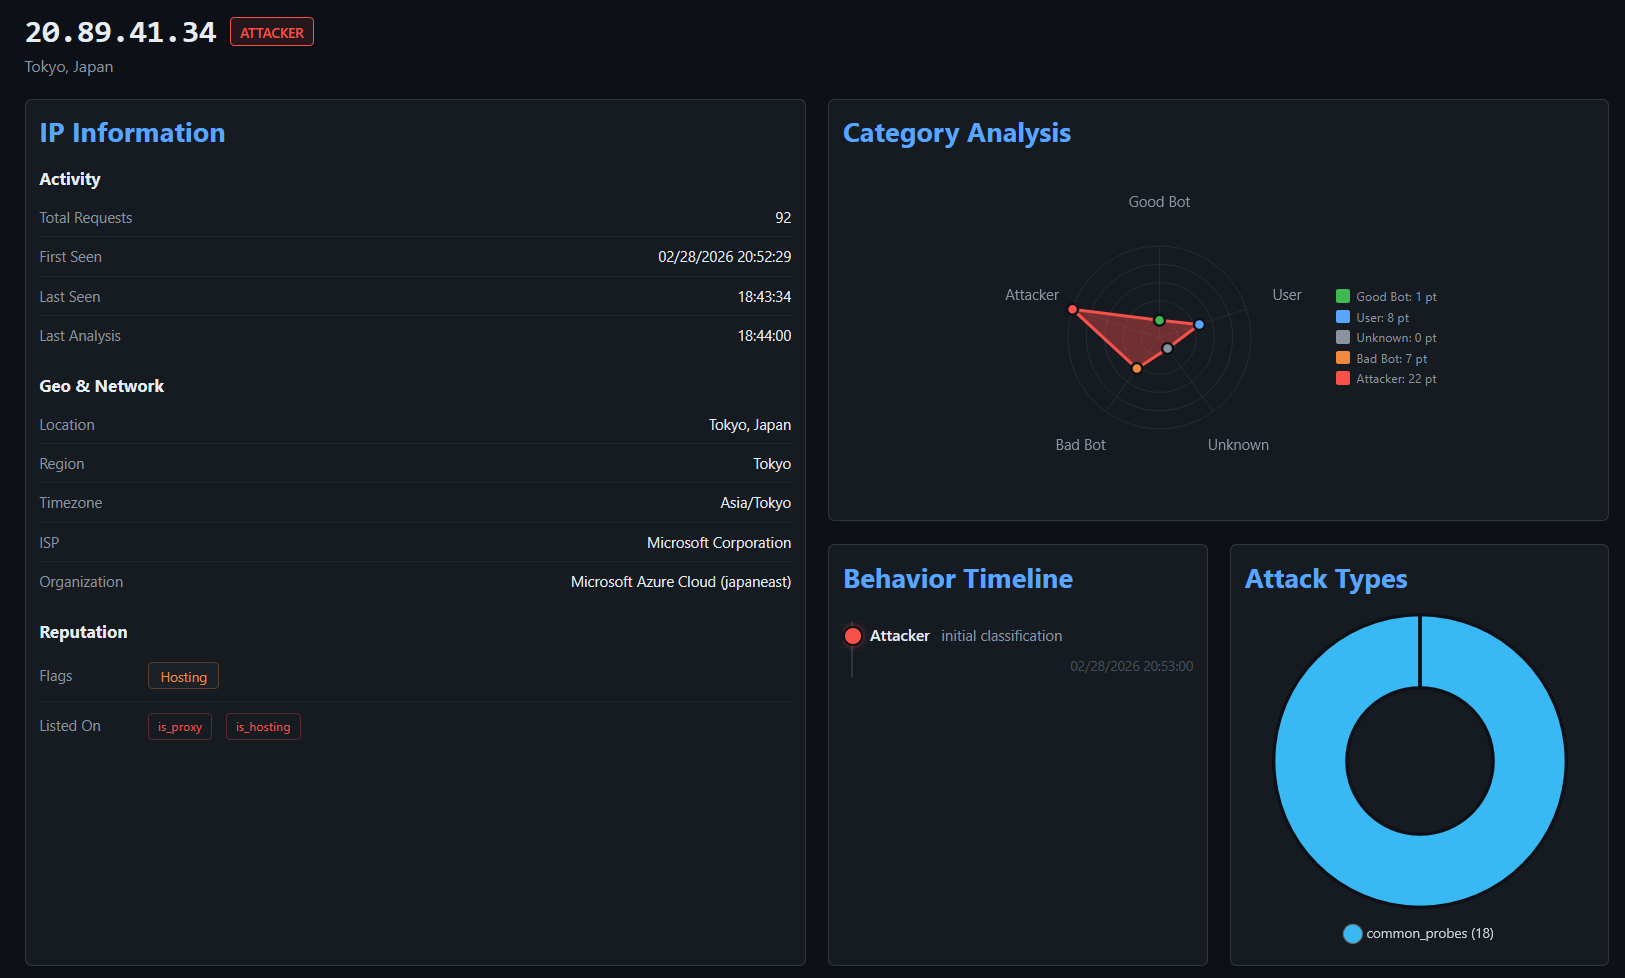
Además, tras autenticarse con la contraseña del panel, se habilitan pestañas protegidas:
- **Tracked IPs**: mantén una lista de vigilancia de direcciones IP que quieres monitorear a lo largo del tiempo.
- **IP Banlist**: gestiona bloqueos de IP, visualiza atacantes detectados y exporta la lista de bloqueo en formato raw o IPTables.
- **Timed Out IPs**: revisa las IPs actualmente retenidas en el tarpit y exime aquellas que no deberían estarlo.
- **Deception**: gestiona páginas generadas por IA, expórtalas o importa nuevas.
- **Webhooks**: reenvía bloqueos a CloudFlare y otros firewalls.
Los iconos de la cabecera abren la documentación de la API, la exportación de la lista de bloqueo y un panel de configuración que muestra la configuración en ejecución y una página de mantenimiento para ejecutar tareas programadas bajo demanda.
Para más detalles, consulta la [documentación del Panel](https://github.com/blessedrebus/krawl/blob/main/docs/dashboard.md).
## Modos de Despliegue
Krawl soporta dos modos de despliegue, controlados por la configuración `mode` en `config.yaml` o la variable de entorno `KRAWL_MODE`.
| | Standalone | Scalable |
|---|---|---|
| **Base de datos** | SQLite (modo WAL) | PostgreSQL |
| **Caché** | Diccionario Python en memoria | Redis (TTL multinivel) |
| **Réplicas** | 1 (instancia única) | 1+ (escalado horizontal) |
| **Dependencias externas** | Ninguna | PostgreSQL + Redis |
| **Ideal para** | Desarrollo, homelabs, <500k solicitudes | Producción, HA, >500k solicitudes |
**Standalone**: ideal para entornos de desarrollo o homelabs con bajo número de solicitudes. No requiere configuración adicional, solo ejecuta Krawl y funciona.
- Despliegue en un solo contenedor sin dependencias externas
- Menor uso de RAM y recursos
**Scalable**: diseñado para entornos de producción o honeypots de alto tráfico. El Helm chart usa este modo por defecto.
- Panel más rápido y receptivo gracias al almacenamiento en caché multinivel de Redis
- Menor E/S de disco con Redis actuando como caché de ruta rápida frente a PostgreSQL
- El escalado horizontal aumenta el número de réplicas de Krawl detrás de un balanceador de carga
Para configuración detallada, ejemplos de Docker Compose, configuración de Kubernetes/Helm e instrucciones de migración paso a paso, consulta la [documentación de Modos de Despliegue](https://github.com/blessedrebus/krawl/blob/main/docs/deployment-modes.md).
## Lista de Bloqueo de Krawl
Krawl mantiene un [`banlist.txt`](https://github.com/blessedrebus/krawl/blob/main/banlist.txt) actualizado regularmente con direcciones IP de **atacantes que activaron sus trampas honeypot**. La lista de bloqueo se publica semanalmente y está disponible para descargar, ayudando a la comunidad a bloquear de forma preventiva actores maliciosos conocidos incluso sin usar Krawl.
La lista de bloqueo también se puede obtener directamente desde:
[https://demo.krawlme.com/das_dashboard/api/export-ips?categories=attacker&fwtype=raw](https://demo.krawlme.com/das_dashboard/api/export-ips?categories=attacker&fwtype=raw).
### Compartir listas de bloqueo entre instancias
Las instancias de Krawl pueden federar sus listas de bloqueo: cada una puede publicar su propia lista en una
ruta no autenticada y obtener listas de otras instancias (o cualquier lista de IPs en texto plano).
Las IPs obtenidas se fusionan en las decisiones de bloqueo locales y se muestran en el panel.```yaml
banlist:
# Public, unauthenticated download path for this instance's banlist.
# Supports the same ?categories= and ?fwtype= parameters as the main API.
# Empty = disabled.
export_path: "/public_banlist.txt"
# Upstream banlists to fetch and merge. Plain ".txt" lists work too.
sources:
- "https://demo.krawlme.com/das_dashboard/api/export-ips?categories=attacker&fwtype=raw"
- "https://krawl.example.com/public_banlist.txt"
refresh_interval: 3600 # seconds between fetches
```
## Inicio rápido
### Ejecución con Docker
Ejecuta Krawl en modo autónomo con la imagen más reciente:```bash
docker run -d \
-p 5000:5000 \
-e KRAWL_DASHBOARD_SECRET_PATH="/my-secret-dashboard" \
-e KRAWL_DASHBOARD_PASSWORD="my-secret-password" \
-v krawl-data:/app/data \
--name krawl \
ghcr.io/blessedrebus/krawl:latest
```
Accede al servidor en `http://localhost:5000`
### Docker Compose
Crea un `docker-compose.yaml` con uno de los dos modos de despliegue.
**Standalone**: solo el servidor Krawl con almacenamiento Sqlite:```yaml
services:
krawl:
image: ghcr.io/blessedrebus/krawl:latest
container_name: krawl-server
ports:
- "5000:5000"
environment:
- CONFIG_LOCATION=config.yaml
# - KRAWL_DASHBOARD_PASSWORD=my-secret-password
volumes:
- ./config.yaml:/app/config.yaml:ro
- krawl-data:/app/data
restart: unless-stopped
volumes:
krawl-data:
```
**Escalable**: con PostgreSQL y Redis:
> [!CAUTION]
> El ejemplo a continuación utiliza **contraseñas predeterminadas** (`krawl`/`krawl`). **Cámbialas antes de desplegar en producción.**```yaml
services:
postgres:
image: postgres:16-alpine
environment:
POSTGRES_DB: krawl
POSTGRES_USER: krawl
POSTGRES_PASSWORD: krawl
volumes:
- postgres_data:/var/lib/postgresql/data
restart: unless-stopped
healthcheck:
test: ["CMD-SHELL", "pg_isready -U krawl -d krawl"]
interval: 10s
timeout: 5s
retries: 5
redis:
image: redis:7-alpine
volumes:
- redis_data:/data
restart: unless-stopped
healthcheck:
test: ["CMD", "redis-cli", "ping"]
interval: 10s
timeout: 5s
retries: 5
krawl:
image: ghcr.io/blessedrebus/krawl:latest
container_name: krawl-server
ports:
- "5000:5000"
environment:
- CONFIG_LOCATION=config.yaml
- KRAWL_MODE=scalable
- KRAWL_POSTGRES_HOST=postgres
- KRAWL_POSTGRES_PORT=5432
- KRAWL_POSTGRES_USER=krawl
- KRAWL_POSTGRES_PASSWORD=krawl
- KRAWL_POSTGRES_DATABASE=krawl
- KRAWL_REDIS_HOST=redis
- KRAWL_REDIS_PORT=6379
# - KRAWL_DASHBOARD_PASSWORD=my-secret-password
volumes:
- ./config.yaml:/app/config.yaml:ro
restart: unless-stopped
depends_on:
postgres:
condition: service_healthy
redis:
condition: service_healthy
volumes:
postgres_data:
redis_data:
```
Para desplegar, solo ejecuta```bash
docker compose up -d
```
También hay archivos compose listos para producción disponibles en el directorio [`docker/`](https://github.com/blessedrebus/krawl/blob/main/docker). Para **desarrollo** (compilaciones desde el código fuente con recarga en caliente), use los archivos compose en [`docker/dev/`](https://github.com/blessedrebus/krawl/blob/main/docker/dev).
Para obtener más detalles sobre ambos modos, consulte [Modos de despliegue](https://github.com/blessedrebus/krawl/blob/main/docs/deployment-modes.md).
### Kubernetes
**Krawl también está disponible de forma nativa en Kubernetes**. La instalación se puede realizar [mediante manifiesto](https://github.com/blessedrebus/krawl/blob/main/kubernetes/README.md) o [usando el chart de Helm](https://github.com/blessedrebus/krawl/blob/main/helm/README.md).
El chart de Helm **usa el modo escalable por defecto** con PostgreSQL y Redis incluidos:```bash
helm install krawl oci://ghcr.io/blessedrebus/krawl-chart --version 2.4.0 \
-n krawl-system --create-namespace \
--set postgres.password=your-password \
--set redis.password=your-redis-password \
--set dashboardPassword=your-dashboard-password \
--set config.dashboard.secret_path=/my-secret-dashboard
```
Se proporcionan archivos de valores de ejemplo mínimos para ambos modos:
- [`values-minimal.yaml`](https://github.com/blessedrebus/krawl/blob/main/helm/values-minimal.yaml) ---> Escalable (predeterminado)
- [`values-standalone.yaml`](https://github.com/blessedrebus/krawl/blob/main/helm/values-standalone.yaml) ---> Autónomo
Consulte [Modos de despliegue](https://github.com/blessedrebus/krawl/blob/main/docs/deployment-modes.md) y [Documentación del Chart](https://github.com/blessedrebus/krawl/blob/main/helm/README.md) para obtener la configuración completa y las instrucciones de migración.
### Uvicorn (Python)
Ejecute Krawl directamente con Python 3.13+ y uvicorn para desarrollo local o pruebas:```bash
pip install -r requirements.txt
uvicorn app:app --host 0.0.0.0 --port 5000 --app-dir src --no-server-header
```
Accede al servidor en `http://localhost:5000`
## Configuración
Krawl utiliza una **jerarquía de configuración** en la que **las variables de entorno tienen prioridad sobre el archivo de configuración**. Este enfoque se recomienda para despliegues con Docker y para personalizaciones rápidas listas para usar.
### Configuración mediante config.yaml
Puedes usar el archivo [config.yaml](https://github.com/blessedrebus/krawl/blob/main/config.yaml) para configuraciones avanzadas, como despliegues con Docker Compose o Helm chart.
### Configuración mediante variables de entorno
Todas las opciones se pueden proporcionar como variables de entorno, las cuales anulan `config.yaml`.
El nombre de la variable es `KRAWL_` más la ruta de la opción en mayúsculas, por lo que `dashboard.password`
se convierte en `KRAWL_DASHBOARD_PASSWORD`.
<details>
<summary><b>Servidor y generación de enlaces</b> (11 variables)</summary>
Cómo se presenta Krawl y cómo da forma al laberinto de páginas generadas.
| Variable de entorno | Descripción | Valor por defecto |
|----------------------|-------------|---------|
| `CONFIG_LOCATION` | Ruta al archivo de configuración yaml | `config.yaml` |
| `KRAWL_PORT` | Puerto de escucha del servidor | `5000` |
| `KRAWL_DELAY` | Retardo de respuesta en milisegundos | `100` |
| `KRAWL_SERVER_HEADER` | Cabecera HTTP Server para engaño | `""` |
| `KRAWL_LINKS_LENGTH_RANGE` | Rango de longitud de enlaces como `min,max` | `5,15` |
| `KRAWL_LINKS_PER_PAGE_RANGE` | Enlaces por página como `min,max` | `10,15` |
| `KRAWL_CHAR_SPACE` | Caracteres usados para la generación de enlaces | `abcdefgh...` |
| `KRAWL_MAX_COUNTER` | Valor inicial del contador | `10` |
| `KRAWL_PROBABILITY_ERROR_CODES` | Probabilidad de respuesta de error (0-100%) | `0` |
| `KRAWL_INFINITE_PAGES_FOR_MALICIOUS` | Servir páginas infinitas a IPs maliciosas | `true` |
| `KRAWL_MAX_PAGES_LIMIT` | Límite máximo de páginas para crawlers | `250` |
| `KRAWL_BAN_DURATION_SECONDS` | Duración del baneo en segundos para IPs con límite de tasa | `600` |
</details>
<details>
<summary><b>Panel, métricas y registro</b> (13 variables)</summary>
Acceso al panel, precalentamiento de caché, Prometheus y nivel de registro.
| Variable de entorno | Descripción | Valor por defecto |
|----------------------|-------------|---------|
| `KRAWL_DASHBOARD_SECRET_PATH` | Ruta personalizada del panel | Generada automáticamente |
| `KRAWL_DASHBOARD_PASSWORD` | Contraseña para los paneles protegidos del panel | Generada automáticamente |
| `KRAWL_DASHBOARD_CACHE_WARMUP` | Precalcular los datos del panel cada 5 minutos para cargas instantáneas de página | `true` |
| `KRAWL_DASHBOARD_WARMUP_PAGES` | Número de páginas a precalentar por panel de tabla | `10` |
| `KRAWL_DASHBOARD_WARMUP_AGGREGATION` | Precalcular las agregaciones completas de top_paths/top_ua para servirlas sin consultas | `false` |
| `KRAWL_DASHBOARD_TOP_N_MIN_COUNT` | Recuento mínimo de accesos para los paneles de rutas/user agents principales (establecer a 1 para desactivar) | `5` |
| `KRAWL_DASHBOARD_BRAND_NAME` | Nombre en el logotipo textual y el encabezado del panel | `Krawl` |
| `KRAWL_DASHBOARD_BRAND_URL` | A dónde enlaza el logotipo textual (vacío lo muestra como texto plano) | Repositorio de Krawl |
| `KRAWL_DASHBOARD_BRAND_LOGO` | URL de imagen mostrada en lugar de la marca de GitHub | Sin establecer |
| `KRAWL_DASHBOARD_BRAND_SHOW_VERSION` | Mostrar la versión junto al nombre | `true` |
| `KRAWL_DASHBOARD_BRAND_CONTACT` | Contacto mostrado bajo el logotipo textual (dirección, URL o texto plano) | Sin establecer |
| `KRAWL_METRICS_ENABLED` | Exponer métricas de Prometheus en `/<dashboard_path>/metrics` | `true` |
| `KRAWL_LOG_LEVEL` | Nivel de registro de la aplicación (`DEBUG`, `INFO`, `WARNING`, `ERROR`) | `INFO` |
</details>
<details>
<summary><b>Base de datos, retención y copias de seguridad</b> (12 variables)</summary>
Ubicación de almacenamiento, cuánto tiempo se conservan los datos y la tarea de volcado.
| Variable de entorno | Descripción | Valor por defecto |
|----------------------|-------------|---------|
| `KRAWL_DATABASE_PATH` | Ubicación del archivo de base de datos | `data/krawl.db` |
| `KRAWL_DATABASE_PERSIST_SUSPICIOUS_ONLY` | Persistir solo las solicitudes sospechosas en el registro de accesos | `false` |
| `KRAWL_MAP_TILE_URL` | Plantilla de URL de teselas para el mapa del panel (`{z}/{x}/{y}`, opcional `{s}`/`{r}`) | Esri dark canvas |
| `KRAWL_MAP_TILE_ATTRIBUTION` | Atribución mostrada en el mapa | Esri/OSM |
| `KRAWL_MAP_API_KEY` | Se añade a cada solicitud de tesela como parámetro de consulta — requerido por CARTO | _(vacío)_ |
| `KRAWL_MAP_API_KEY_PARAM` | Nombre de ese parámetro de consulta (`api_key`, `apikey`, `key`) | `api_key` |
| `KRAWL_IPV6_IGNORE` | Descartar por completo las solicitudes IPv6: se siguen registrando en stdout, nunca se persisten, ni se comprueban para baneo ni se exportan | `false` |
| `KRAWL_IPV6_PURGE_EXISTING` | Eliminar también las filas IPv6 existentes en el siguiente arranque (irreversible; requiere `KRAWL_IPV6_IGNORE`) | `false` |
| `KRAWL_DATABASE_RETENTION_DAYS` | Días de retención de datos en la base de datos | `30` |
| `KRAWL_BACKUPS_PATH` | Ruta donde se guardan los volcados de la base de datos | `backups` |
| `KRAWL_BACKUPS_CRON` | expresión cron para controlar la programación de la tarea de copia de seguridad | `*/30 * * * *` |
| `KRAWL_BACKUPS_ENABLED` | Booleano para habilitar la tarea de volcado de la base de datos | `true` |
</details>
<details>
<summary><b>Trampas: tarpit, páginas de engaño y canary</b> (6 variables)</summary>
Trampas opcionales y las páginas servidas a los atacantes.
| Variable de entorno | Descripción | Valor por defecto |
|----------------------|-------------|---------|
| `KRAWL_TARPIT_ENABLED` | Atrapar a los agentes de IA con respuestas lentas y texto aleatorio | `false` |
| `KRAWL_TARPIT_DELAY_SECONDS` | Retardo adicional en segundos añadido por respuesta cuando el tarpit está activo | `5` |
| `KRAWL_DECEPTION_IMPORT_PAGES` | Importar automáticamente las páginas de engaño desde `src/templates/deception/` al arrancar | `true` |
| `KRAWL_CUSTOM_TEMPLATE_PATH` | Ruta dentro del contenedor a una plantilla HTML personalizada. La plantilla debe incluir los marcadores `{counter}` y `{content}`. | `/templates/custom_page.html` |
| `KRAWL_CANARY_TOKEN_URL` | URL de token canary externo | Ninguno |
| `KRAWL_CANARY_TOKEN_TRIES` | Solicitudes antes de mostrar el token canary | `10` |
</details>
<details>
<summary><b>Analizador de reputación de IP</b> (6 variables)</summary>
Umbrales que determinan cómo se clasifica una IP.
| Variable de entorno | Descripción | Valor por defecto |
|----------------------|-------------|---------|
| `KRAWL_HTTP_RISKY_METHODS_THRESHOLD` | Umbral para la detección de métodos HTTP de riesgo | `0.1` |
| `KRAWL_VIOLATED_ROBOTS_THRESHOLD` | Umbral para violaciones de robots.txt | `0.1` |
| `KRAWL_UNEVEN_REQUEST_TIMING_THRESHOLD` | Umbral del coeficiente de variación para la temporización | `0.5` |
| `KRAWL_UNEVEN_REQUEST_TIMING_TIME_WINDOW_SECONDS` | Ventana temporal para el análisis de temporización de solicitudes en segundos | `300` |
| `KRAWL_USER_AGENTS_USED_THRESHOLD` | Umbral para detectar múltiples user agents | `2` |
| `KRAWL_ATTACK_URLS_THRESHOLD` | Umbral para la detección de URL de ataque | `1` |
</details>
<details>
<summary><b>Captura de threat-intel</b> (4 variables)</summary>
Aplica fuzzy-hash a las cargas útiles capturadas (archivos y cuerpos de solicitud marcados) y agrupa
las variantes casi duplicadas en clústeres de campañas. Requiere `py-tlsh`.
El hashing se ejecuta como la tarea en segundo plano programada `hash-payloads` (véase
`src/tasks/hash_payloads.py`), que aplica hash a cada ataque capturado una vez — los nuevos
impactos en el momento de la ingesta, y un barrido retrospectivo único del historial existente
rastreado mediante una marca de agua `payload_hash_watermark` — y luego agrupa los
digests en campañas de patrones recurrentes.
| Variable de entorno | Descripción | Valor por defecto |
|----------------------|-------------|---------|
| `KRAWL_TLSH_ENABLED` | Aplicar hash con TLSH a los archivos subidos y a los cuerpos de solicitud marcados para la agrupación de casi duplicados | `true` |
| `KRAWL_TLSH_CLUSTER_THRESHOLD` | Distancia TLSH por debajo de la cual una carga útil se une a una campaña existente (0 = bytes idénticos; las variantes de un webshell suelen diferir en < 100) | `150` |
| `KRAWL_TLSH_CAMPAIGN_MIN_EVENTS` | Número de veces que debe verse una carga útil antes de que su campaña aparezca en la pestaña Threats | `10` |
| `KRAWL_REFERER_ENABLED` | Registrar el Referer HTTP entrante en los registros de acceso, para el seguimiento de cadenas de cebo | `true` |
</details>
<details>
<summary><b>Lista de baneos e IPs ignoradas</b> (4 variables)</summary>
Compartir listas de baneos con otras instancias, y tráfico que nunca debe rastrearse.
| Variable de entorno | Descripción | Valor por defecto |
|----------------------|-------------|---------|
| `KRAWL_IGNORED_IPS` | IPs/CIDRs separadas por comas que nunca se rastrean, banean ni exportan | Loopback, RFC1918, link-local, CGNAT |
| `KRAWL_BANLIST_EXPORT_PATH` | Ruta pública de descarga de la lista de baneos, p. ej. `/public_banlist.txt` (vacío = deshabilitado) | `""` |
| `KRAWL_BANLIST_SOURCES` | URLs de listas de baneos upstream separadas por comas para obtener y fusionar | Lista de baneos de la comunidad de Krawl |
| `KRAWL_BANLIST_REFRESH_INTERVAL` | Segundos entre obtenciones de listas de baneos upstream | `3600` |
</details>
<details>
<summary><b>Páginas de engaño generadas por IA</b> (10 variables)</summary>
Consulta la [documentación de generación por IA](https://github.com/blessedrebus/krawl/blob/main/docs/ai_generation.md).
| Variable de entorno | Descripción | Valor por defecto |
|----------------------|-------------|---------|
| `KRAWL_AI_ENABLED` | Habilitar páginas de engaño generadas por IA | `false` |
| `KRAWL_AI_PROVIDER` | Proveedor de IA (`"openrouter"` u `"openai"`) | `"openrouter"` |
| `KRAWL_AI_OPENAI_BASE_URL` | URL base opcional de OpenAI para endpoints de API personalizados | `"https://api.openai.com/v1"` |
| `KRAWL_AI_API_KEY` | Clave de API para el proveedor de IA | `None` |
| `KRAWL_AI_MODEL` | Modelo de IA a usar para la generación de páginas | `"nvidia/nemotron-3-super-120b-a12b:free"` |
| `KRAWL_AI_TIMEOUT` | Tiempo de espera de solicitud en segundos para las llamadas a la API de IA | `60` |
| `KRAWL_AI_MAX_DAILY_REQUESTS` | Número máximo de páginas generadas por IA al día (0 = ilimitado) | `0` |
| `KRAWL_AI_PROMPT` | Plantilla de prompt personalizada para la generación de páginas por IA | Prompt por defecto |
| `KRAWL_AI_REASONING_ENABLED` | Habilitar tokens de razonamiento (solo modelos de razonamiento de OpenRouter) | `false` |
| `KRAWL_AI_REASONING_EFFORT` | Esfuerzo de razonamiento (`none`, `minimal`, `low`, `medium`, `high`, `xhigh`) | `"medium"` |
</details>
<details>
<summary><b>Modo escalable: PostgreSQL y Redis</b> (13 variables)</summary>
Solo se usa cuando `KRAWL_MODE=scalable`. Consulta [Modos de despliegue](https://github.com/blessedrebus/krawl/blob/main/docs/deployment-modes.md).
| Variable de entorno | Descripción | Valor por defecto |
|----------------------|-------------|---------|
| `KRAWL_MODE` | Modo de despliegue (`standalone` o `scalable`) | `standalone` |
| `KRAWL_POSTGRES_HOST` | Nombre de host de PostgreSQL | `localhost` |
| `KRAWL_POSTGRES_PORT` | Puerto de PostgreSQL | `5432` |
| `KRAWL_POSTGRES_USER` | Nombre de usuario de PostgreSQL | `krawl` |
| `KRAWL_POSTGRES_PASSWORD` | Contraseña de PostgreSQL | `krawl` |
| `KRAWL_POSTGRES_DATABASE` | Nombre de la base de datos de PostgreSQL | `krawl` |
| `KRAWL_REDIS_HOST` | Nombre de host de Redis | `localhost` |
| `KRAWL_REDIS_PORT` | Puerto de Redis | `6379` |
| `KRAWL_REDIS_DB` | Número de base de datos de Redis | `0` |
| `KRAWL_REDIS_PASSWORD` | Contraseña de Redis | Ninguno |
| `KRAWL_REDIS_CACHE_TTL` | TTL en segundos para los datos de precalentamiento del panel | `600` |
| `KRAWL_REDIS_HOT_TTL` | TTL en segundos para los datos de ruta activa (información de baneo, categorías de IP) | `30` |
| `KRAWL_REDIS_TABLE_TTL` | TTL en segundos para las tablas paginadas del panel | `120` |
</details>
Por ejemplo```bash
# Set canary token
export CONFIG_LOCATION="config.yaml"
export KRAWL_CANARY_TOKEN_URL="http://your-canary-token-url"
# Set number of pages range (min,max format)
export KRAWL_LINKS_PER_PAGE_RANGE="5,25"
# Set analyzer thresholds
export KRAWL_HTTP_RISKY_METHODS_THRESHOLD="0.2"
export KRAWL_VIOLATED_ROBOTS_THRESHOLD="0.15"
# Set custom dashboard path and password
export KRAWL_DASHBOARD_SECRET_PATH="/my-secret-dashboard"
export KRAWL_DASHBOARD_PASSWORD="my-secret-password"
```
Ejemplo de una ejecución de Docker con variables de entorno (modo independiente):```bash
docker run -d \
-p 5000:5000 \
-e KRAWL_MODE=standalone \
-e KRAWL_PORT=5000 \
-e KRAWL_DELAY=100 \
-e KRAWL_DASHBOARD_PASSWORD="my-secret-password" \
-e KRAWL_CUSTOM_TEMPLATE_PATH="/templates/custom_page.html" \
-e KRAWL_CANARY_TOKEN_URL="http://your-canary-token-url" \
--name krawl \
ghcr.io/blessedrebus/krawl:latest
```
## Usar Krawl para bloquear IPs maliciosas
Krawl utiliza un sistema basado en reputación para clasificar las direcciones IP de los atacantes y proporciona dos formas de exportar listas de IPs para la integración con el firewall.
El endpoint `/api/export-ips` consulta la base de datos directamente y admite el filtrado por categoría de IP (`attacker`, `bad_crawler`, `regular_user`, `good_crawler`) y formato de salida (`raw`, `iptables`, `nftables`):```bash
curl "https://your-krawl-instance/<DASHBOARD-PATH>/api/export-ips?categories=attacker&fwtype=raw"
```
Esto permite el bloqueo automático de tráfico malicioso en varias plataformas:
* [OPNsense y pfSense](https://ipv64.net/v64_blocklist_integration_guide)
* [RouterOS](https://rentry.co/krawl-routeros)
* [IPtables](https://github.com/blessedrebus/krawl/blob/main/plugins/iptables/README.md) y [Nftables](https://github.com/blessedrebus/krawl/blob/main/plugins/nftables/README.md)
* [Fail2Ban](https://github.com/blessedrebus/krawl/blob/main/plugins/fail2ban/README.md)
Para ver todos los parámetros de la API, ejemplos y cómo añadir formatos de firewall personalizados, consulta la [documentación de Exportadores de Firewall](https://github.com/blessedrebus/krawl/blob/main/docs/firewall-exporters.md).
Krawl también puede enviar IPs bloqueadas directamente a una Lista de IPs de una Cuenta de Cloudflare para su uso en reglas de WAF. La sincronización se ejecuta como una tarea en segundo plano y actualiza la lista mediante reemplazo completo en un intervalo configurable. Consulta la documentación de [Sincronización de Lista de Bloqueo de Cloudflare](https://github.com/blessedrebus/krawl/blob/main/docs/cloudflare_banlist.md).
## Reputación de IP
Krawl [utiliza tareas que analizan el tráfico reciente para construir y actualizar continuamente una puntuación de reputación de IP](https://github.com/blessedrebus/krawl/blob/main/src/tasks/analyze_ips.py). Se ejecuta periódicamente y evalúa cada dirección IP activa basándose en múltiples indicadores de comportamiento para clasificarla como atacante, crawler o usuario regular. Los umbrales son totalmente personalizables.
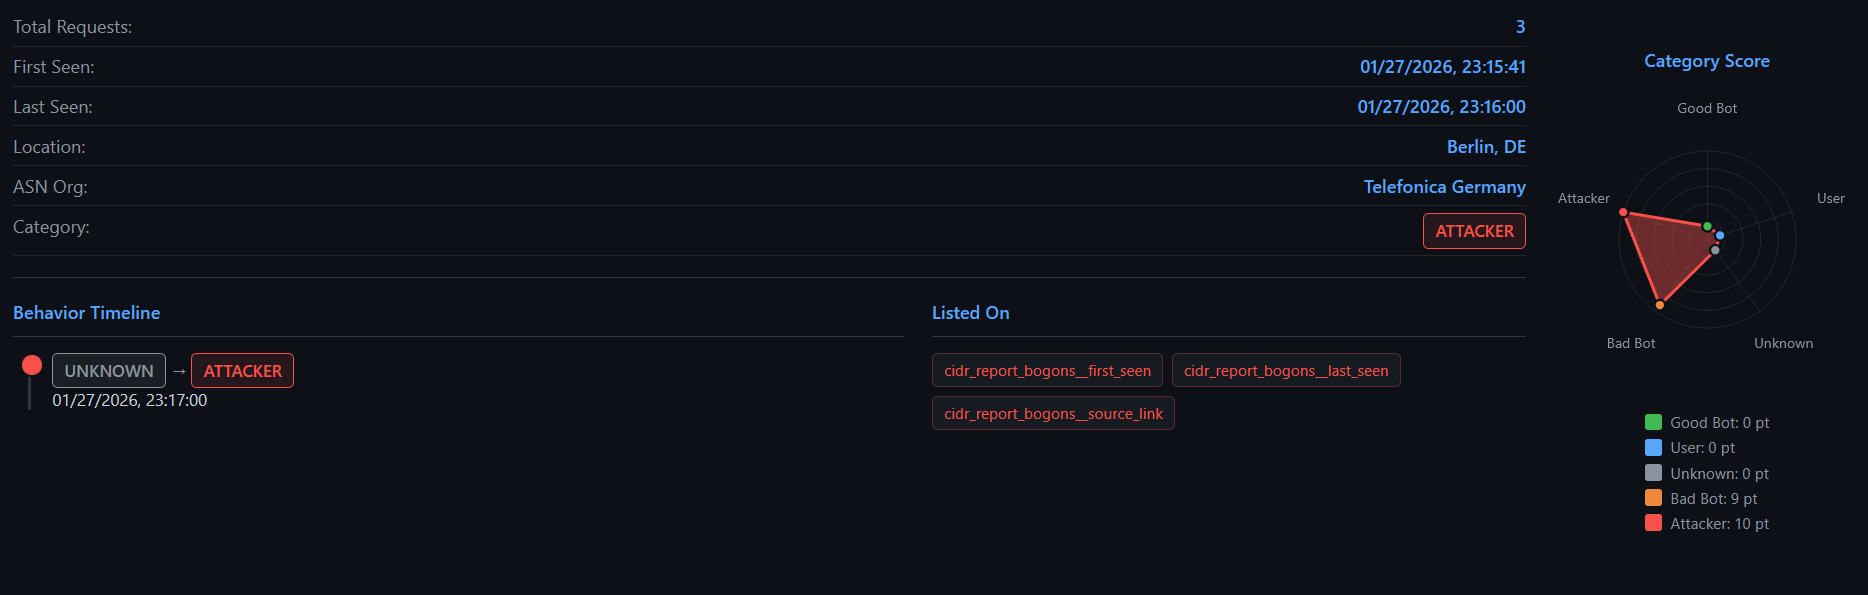
El análisis incluye:
- **Uso de métodos HTTP riesgosos** (por ejemplo, proporciones de POST, PUT, DELETE)
- **Violaciones de Robots.txt**
- **Anomalías en los tiempos de las solicitudes** (patrones irregulares o en ráfagas)
- **Consistencia del User-Agent**
- **Detección de URLs de ataque** (por ejemplo, inyección SQL, patrones XSS)
Cada señal contribuye a un modelo de puntuación ponderada que asigna una categoría de reputación:
- `attacker`
- `bad_crawler`
- `good_crawler`
- `regular_user`
- `unknown` (para datos insuficientes)
Las puntuaciones y métricas resultantes se almacenan en la base de datos y son utilizadas por Krawl para alimentar paneles de control, seguimiento de reputación y acciones de mitigación automatizadas como el bloqueo de IP o la integración con firewalls.
## Páginas de Engaño Generadas por IA
Krawl puede generar automáticamente páginas de engaño realistas utilizando modelos de IA de las APIs de **OpenRouter** o **OpenAI**. Esta función crea páginas honeypot únicas y plausibles sobre la marcha para engañar a los atacantes sin necesidad de crear páginas manualmente.
**Características Principales:**
- **Generación Dinámica**: Crea páginas HTML únicas para cualquier ruta de solicitud
- **Caché Inteligente**: Almacena en caché las páginas generadas para evitar llamadas redundantes a la API
- **Limitación de Tasa Diaria**: Controla los costes de la API con límites de solicitudes configurables
- **Múltiples Proveedores**: Compatibilidad con OpenRouter (opciones gratuitas) y OpenAI
- **Degradación Elegante**: Recurre al honeypot estándar cuando está deshabilitado o se alcanza el límite
- **Servicio desde Caché**: Las páginas generadas previamente se sirven incluso cuando la IA está deshabilitada
**Configuración Rápida:**```yaml
ai:
enabled: true
provider: "openrouter"
openai_base_url: "your-custom-base-url"
api_key: "your-api-key"
model: "nvidia/nemotron-3-super-120b-a12b:free"
timeout: 60
max_daily_requests: 10
---
[Read more](https://github.com/blessedrebus/krawl)
