
ai-reverse-engineering — Actualizado!
Ingeniería inversa asistida por IA con Ghidra
Rev·Deck — Ingeniería Inversa Asistida por IA con Ghidra
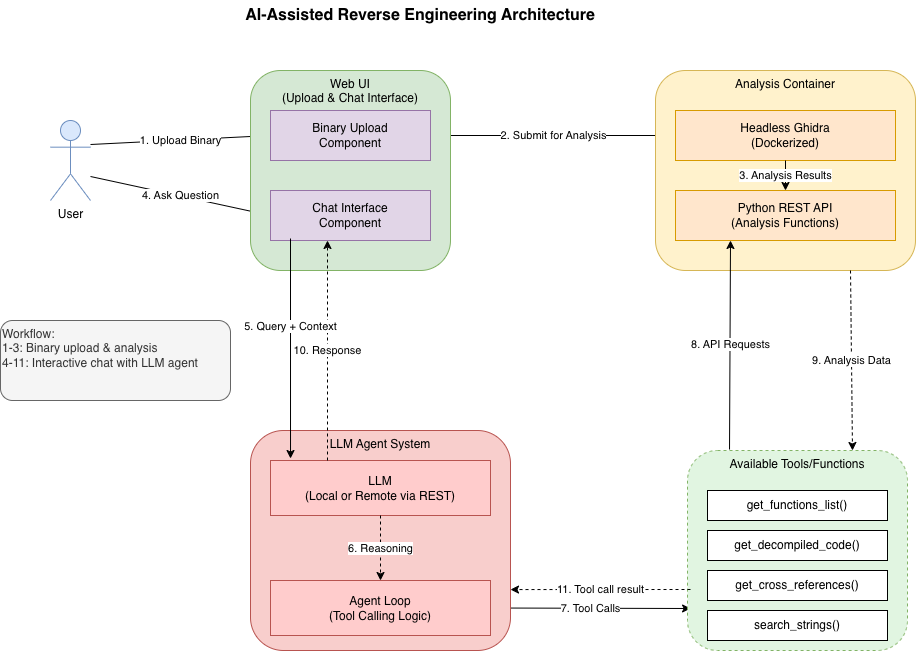
Rev·Deck es una estación de trabajo local de análisis estático para un solo usuario. Combina una interfaz web basada en evidencias con un copiloto de LLM sobre un binario analizado por un servicio Ghidra sin cabeza: navegue directamente por las evidencias deterministas (funciones, cadenas, importaciones, referencias cruzadas, un grafo de llamadas acotado), o haga preguntas acotadas al asistente cuyas afirmaciones fácticas deben citar evidencias inspeccionables.
Los binarios analizados nunca se ejecutan. El navegador solo se comunica con esta aplicación Flask; la aplicación proxy valida y tipifica las solicitudes al servicio Ghidra.
Demo
https://github.com/user-attachments/assets/fba14dc5-7ad5-4137-9349-ed824da64fbe
Inicio Rápido (Docker)
cp .env.example .env      # set API_BASE and MODEL_NAME; set API_KEY if required
docker compose up --build
Docker Compose lee .env automáticamente para la interpolación. Fallará al iniciar si falta API_BASE o MODEL_NAME; API_KEY=not-used sigue siendo válida para proveedores locales/sin clave. El stack inicia ambos servicios. Abra http://127.0.0.1:5000.
Para ejecutar solo el servicio Ghidra:
docker pull biniamfd/ghidra-headless-rest:latest   # ensure the newest image

docker run --rm \
  -p 127.0.0.1:9090:9090 \
  -v "$(pwd)/data:/data/ghidra_projects" \
  --security-opt no-new-privileges:true \
  biniamfd/ghidra-headless-rest:latest
Para un pin reproducible, use el digest de la versión probada en lugar de latest:
docker run --rm \
  -p 127.0.0.1:9090:9090 \
  -v "$(pwd)/data:/data/ghidra_projects" \
  --security-opt no-new-privileges:true \
  biniamfd/ghidra-headless-rest:1.2.1@sha256:971591a3a8448d8ed969079b452306e806f36079c3ddd298f4a618d6e2f1442d
Prerrequisitos
- Docker y Docker Compose (para la ruta de Inicio Rápido), o Python 3.10+ y Node.js 18+ (para ejecutar desde el código fuente).
- Un endpoint LLM compatible con OpenAI (local o alojado) y un nombre de modelo.
- La imagen pública de Ghidra:
biniamfd/ghidra-headless-rest:latest.
Variables de entorno esenciales
Copie .env.example a .env y complete estas; consulte ese archivo para la lista completa y los valores predeterminados.
| Variable | Por Defecto | Significado |
|---|---|---|
API_BASE | requerido | URL base compatible con OpenAI (http/https). Compose falla temprano si no está presente. |
API_KEY | not-used | Clave del proveedor. Nunca se registra ni se envía al navegador; not-used es válida para proveedores locales sin clave. |
MODEL_NAME | requerido | ID del modelo esperado por el endpoint configurado. Compose falla temprano si no está presente. |
LLM_STREAM | auto | Transporte de streaming: auto (stream, retrocede a bloqueante una vez ante un error de compatibilidad previo a la salida), true (siempre stream), false (siempre bloqueante). |
GHIDRA_API_BASE | http://127.0.0.1:9090 | URL base del servicio Ghidra. |
GHIDRA_IMAGE | biniamfd/ghidra-headless-rest:1.2.1@sha256:971591a3... | Versión probada fijada por digest inmutable. :latest también resuelve a este digest; sobrescriba para fijar una versión diferente. |
HOST / PORT | 127.0.0.1 / 5000 | Enlace del servidor de desarrollo. |
MAX_UPLOAD_BYTES | 104857600 | Límite de tamaño de carga. |
CHATS_DIR | webui/chats | Directorio del historial de chats. |
Proveedor de LLM
Rev·Deck se comunica con cualquier endpoint de Chat Completions compatible con OpenAI a través del SDK de OpenAI, configurado completamente por API_BASE / API_KEY / MODEL_NAME. No hay lógica de cabecera, parámetro o modelo específica del proveedor: un servidor local Ollama (API_BASE=http://127.0.0.1:11434/v1), un endpoint vLLM/llama.cpp/LM Studio autoalojado, el propio OpenAI, o una puerta de enlace como OpenRouter funcionan de la misma manera.
Ejemplos de configuración de proveedor en .env (use marcadores de posición, nunca confíe claves reales):
# Ollama
API_BASE=http://127.0.0.1:11434/v1
API_KEY=not-used
MODEL_NAME=qwen3:8b
# OpenRouter
API_BASE=https://openrouter.ai/api/v1
API_KEY=replace-with-your-key
MODEL_NAME=anthropic/claude-opus-4.8
# OpenAI
API_BASE=https://api.openai.com/v1
API_KEY=replace-with-your-key
MODEL_NAME=replace-with-a-supported-model-id
# LM Studio, vLLM, or llama.cpp (adjust port/model to the server)
API_BASE=http://127.0.0.1:1234/v1
API_KEY=not-used
MODEL_NAME=replace-with-the-served-model-id
Por defecto (LLM_STREAM=auto) el asistente solicita una respuesta streamed y retransmite los tokens al navegador a medida que llegan. El streaming también ofrece una garantía de cancelación más fuerte: cuando se detiene una respuesta (o se cierra la pestaña), Rev·Deck cierra rápidamente el flujo del proveedor subyacente y no realiza más rondas de herramientas o modelos, por lo que la generación ascendente se interrumpe en lugar de dejarse ejecutar hasta completarse en segundo plano.
Advertencias:
- Facturación. Cancelar cierra el flujo de nuestro lado inmediatamente, pero algunos proveedores alojados aún facturan por los tokens que ya habían generado (o por la finalización completa) independientemente de una desconexión temprana del cliente. La garantía se refiere a no hacer más trabajo, no a la política de facturación del proveedor.
- Compatibilidad. No todos los endpoints compatibles con OpenAI aceptan streaming con herramientas. En
auto, si el proveedor rechaza la solicitud streamed con un error de compatibilidad (HTTP 400/404/405/422) antes de cualquier salida de contenido o llamada a herramienta, Rev·Deck retrocede a una única llamada bloqueante una vez y lo recuerda durante el resto del proceso. Los errores de autenticación (401/403), límite de tasa (429) y de servidor (5xx) no se tratan como problemas de compatibilidad y se muestran como errores en lugar de reintentarlos silenciosamente. EstablezcaLLM_STREAM=falsepara omitir el streaming por completo, oLLM_STREAM=truepara requerirlo (sin retroceso).
Cómo usar
Abra la aplicación y cargue un binario para iniciar un trabajo de análisis. El texto plano obvio solicita confirmación antes de enviarse a Ghidra; use la anulación explícita de binario sin formato solo cuando el contenido sea intencionalmente firmware/datos en lugar de un formato ejecutable. Una vez completado el análisis, cambie entre dos pestañas del espacio de trabajo:
- Análisis — vistas de evidencias deterministas: resumen, funciones (filtro/paginación), importaciones, cadenas, una vista de consulta, un inspector de funciones (pseudocódigo, referencias cruzadas, grafo de llamadas acotado, volcado hexadecimal) y —cuando el servicio Ghidra conectado los soporte— tipos, globales, anotaciones auxiliares, exportación de archivos y una clasificación determinista de Superficie de Ataque con señales positivas/mitigantes explicables y cobertura de evidencias.
- Chat — el asistente, en uno de dos modos:
- Copiloto (predeterminado): un paso/llamada a herramienta acotado por mensaje, para preguntas ad hoc.
- Autónomo: inicie un flujo de trabajo nombrado y presupuestado que ejecuta múltiples pasos acotados por sí solo y muestra una línea de tiempo de actividad en vivo mientras trabaja.
Ambos modos toman un presupuesto de pasos por tarea, y una opción Sin límite de pasos que se ejecuta hasta que la tarea finaliza (todavía limitada por MAX_STEP_BUDGET para que un modelo en bucle no pueda descontrolarse). Si una ejecución alcanza su presupuesto, reporta resultados parciales y ofrece Continuar — que reanuda la misma conversación usando las evidencias ya recuperadas, sin rehacer las llamadas a herramientas completadas. El costo crece con el número de llamadas a herramientas/modelos, por lo que presupuestos más altos cuestan más.