

PurpleLlama
 meta-llama/purplellama
Tools zur Bewertung und Verbesserung der LLM-Sicherheit.
defensive-toolsvulnerability-analysiscode-analysis+4
4.4kvor 6 Tagen
meta-llama/purplellamaTools zur Bewertung und Verbesserung der LLM-Sicherheit.
 yzhao062/pyod
Eine Python-Bibliothek zur Anomalieerkennung in tabellarischen Daten, Zeitreihen, Graphen, Text, Bildern und Audiodaten. 60+ Detektoren,…
 phkhanhtrinh23/agas
LLM-gesteuertes agentisches Framework für Group-Shilling-Angriffe, das Black-Box-Collaborative-Filtering-Empfehlungsrankings mithilfe adaptiver…
 owasp/aisvs
Der AI Security Verification Standard (AISVS) unterstützt Entwickler, Architekten und Sicherheitsexperten mit einer strukturierten Checkliste zur…
 trusted-ai/adversarial-robustness-toolbox
Python-Bibliothek für die Sicherheit von Adversarial Machine Learning, die es Red- und Blue-Teams ermöglicht, Evasion-, Poisoning-, Extraction- und…
 ye-ze-yu/epireal-bench
Red-Teaming-Benchmark und Black-Box-Angriffsframework zur Bewertung von Risiken visueller Fehlinformationen bei kommerziellen Bildgeneratoren, mit…
 moontea0416/webmirage
Adversariale Bildangriffe auf Vision-Language-Web-Agenten, vom visuellen Grounding bis zur Browser-Ausführung
 deep-jlu/skillpoison
Forschungspipeline, die verifizierte erfolgreiche Erfahrungen konstruiert und sie in Ausbildungsdatensätze organisiert, um Modellfähigkeiten über die…
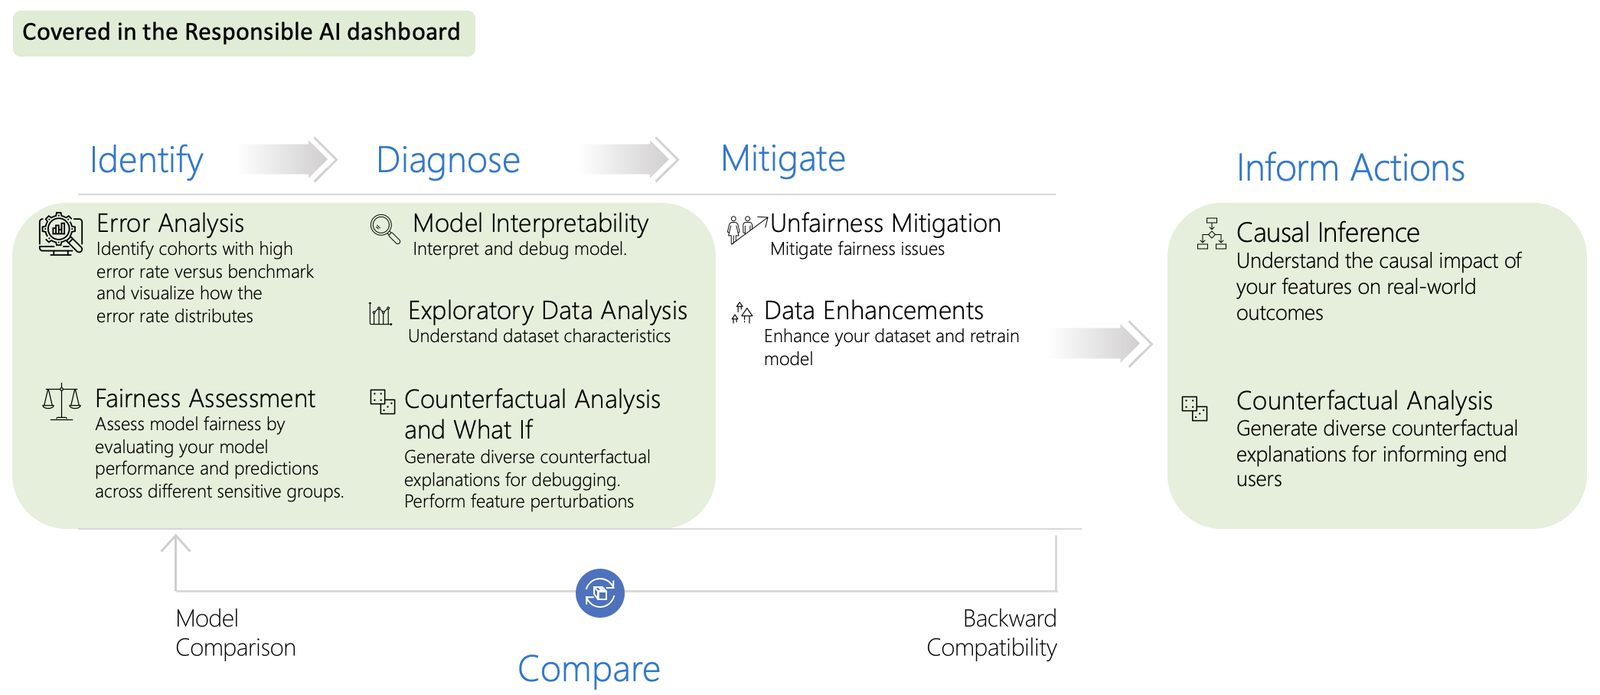 microsoft/responsible-ai-toolbox
Interaktive Dashboards und Bibliotheken für verantwortungsvolles Debugging von KI-Modellen, die Fehleranalyse, Fairness, Interpretierbarkeit,…
 jpoindexter/interrogation-game
Sprachbasiertes Detektiv-Verhörspiel. Mistral Large 3 + Voxtral STT + ElevenLabs TTS. Entwickelt für den Mistral Worldwide Hackathon 2026.
 js-lee-ai/refusal-relocates
Refusal localizes, the damage relocates, safety layers under few-sample fine-tuning
 zju-llm-safety/ascent
Fine-Tuning-Framework, das eine First-Order-Optimal-Safety-Kalibrierung und periodische Rekalibrierung auf LLMs anwendet, wobei sicherheitskompatible…
 praetorian-inc/augustus
LLM-Sicherheitstestframework zur Erkennung von Prompt-Injection, Jailbreaks und adversarialen Angriffen — 190+ Sonden, 28 Anbieter, einzelne…
 jiep/offensive-ai-compilation
Eine kuratierte Liste nützlicher Ressourcen, die Offensive AI abdecken.
 stardust457/sldr
Verteidigungsframework, das bösartiges Fine-Tuning von LLMs durch selektive Schichtwiederherstellung und dynamisches Routing abschwächt, mit…
 cybershujin/prompt-injection-in-the-wild
Tracker öffentlich gemeldeter Prompt-Injection-Techniken, aufgeschlüsselt nach Übermittlungsmethode, Kodierung und Ausbreitungsverhalten, mit…
 zju-llm-safety/trace
Agentic jailbreak framework for LLM-based agents using scheme-based task decomposition, multi-turn disguising strategies, and adaptive self-evolution…
 sliu11-byte/mea-bench
Ein Lifecycle-Benchmark für Black-Box-LLM-Extraktionsangriffe, Verteidigungen und adaptive Angriffe.